
Focus:像粘菌一样思考,LLM Agent 的主动内存清理艺术
Active Context Compression: Autonomous Memory Management in LLM Agents
本文提出了 Focus,一种受粘菌(Slime Mold)启发的主动上下文压缩架构。该方法允许 LLM Agent 在复杂的软件工程任务中自主修剪冗余的历史记录,并将其固化为结构化的“知识块”,从而在保持 60% 成功率的同时,将 Token 消耗降低了 22.7%。
TL;DR
在软件工程等长程任务中,LLM Agent 往往会因为对话历史太长而变得既昂贵又迟钝。受多头绒泡菌(粘菌)高效探索策略的启发,Focus 架构应运而生。它赋予了 Agent “主动遗忘”的能力:通过自主总结并删除冗余的调试日志,Focus 在 SWE-bench 任务中减少了 22.7% 的 Token 消耗,且保持了与全量上下文模型 100% 一致的修复成功率。
1. 背景定位:拒绝“Append-Only”的暴力增长
目前的 LLM Agent 普遍采用“仅附加”模式——每一次工具调用、报错、思维链都被永久保存在上下文窗口中。这导致了三个核心痛点:
- 成本爆炸:Token 消耗随推理步数呈二次方增长。
- 延迟增加:Context 越长,首字响应时间(TTFT)越离谱。
- 上下文污染:大量的试错过程(Trial-and-Error)会干扰模型的最终判断,使其“迷失在中间”。
作者认为,高效的系统不应保留每一个动作的完美记录,而应只保留抽象后的“地图”。
2. 核心直觉:粘菌启发式探索
就像粘菌在迷宫中探索时会收回废弃的路径、仅留下化学信号标记一样,Focus Agent 会自主决定何时进行“阶段性总结”。
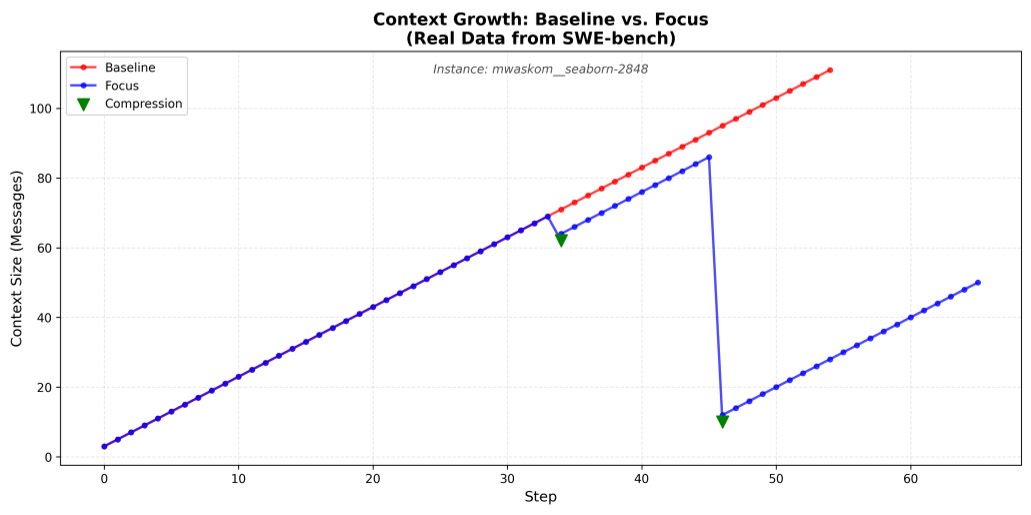 图 1:Focus 模式下的 Token 消耗呈现“锯齿状”,而基线模型则是持续增长。
3. Focus 循环工作流
该架构通过两个简单的工具原语改变了传统的 ReAct 循环:
- Start Focus:Agent 声明开始特定任务(如“检查配置文件”),设置检查点。
- Explore:执行原始的 read/edit/run 操作。
- Consolidate:任务结束或遇到死路时,Agent 主动调用
complete_focus总结学到了什么。 - Withdraw:系统将总结存入顶部的“知识块”,并从上下文内存中物理删除刚才产生的庞大原始日志。
4. 实验结果:在节省成本的同时保持高智商
在严苛的 SWE-bench Lite 测试中,Focus 展示了极强的自我调节能力:
| 指标 | Baseline | Focus | 变化 |
|---|---|---|---|
| 任务成功率 | 60% (3/5) | 60% (3/5) | 持平 |
| 总 Token 消耗 | 14.92 M | 11.53 M | -22.7% |
| 单任务平均 Token | 2.98 M | 2.31 M | -678K |
| 平均消息删除数 | 0 | 70.2 | - |
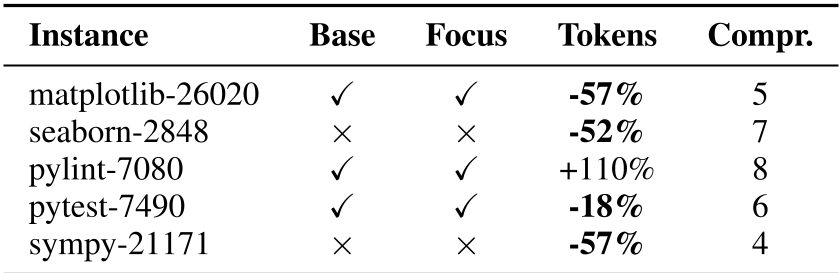 图 2:具体实例表现。在 matplotlib 等任务中,Token 节省甚至高达 57%。
关键发现:
- 探索型任务受益最大:在需要大量代码导航(如搜索 Bug 位置)的任务中,由于可以频繁删除无用的目录列表,节省效果极佳(>50%)。
- 激进提示词(Aggressive Prompting)是核心:实验发现,如果不强制提醒 Agent 每 10-15 步压缩一次,Agent 会变“懒”,节省效果会从 22% 骤降至 6%。
- 认知税(Cognitive Tax):压缩本身也消耗 Token,但在长程任务中,这种“磨刀不误砍柴工”的开销会被后期的巨大节省所摊平。
5. 局限性与深度见解
尽管 Focus 表现出色,它在某些“迭代改进”型任务(如 pylint-7080)中表现不佳,甚至出现了 110% 的 Token 增加。这是因为频繁的压缩可能导致一些细微的实现细节丢失,迫使 Agent 重新探索。
总结性启示: Focus 证明了 LLM Agent 已经具备了“自我审视内存”的初步能力。对于未来的工业级 Agent 系统,我们不需要为它堆叠百万级的上下文,而应该通过激进的提示词工程或针对性的微调,教会它们如何聪明地“忘记”。
6. 结论
Focus 架构提供了一套无需基础设施改造(Infrastructure-free)的内存管理方案。随着上下文窗口的增长,主动压缩将成为管理自动回归推理中“二次方成本增长”的关键武器。