
[ACL 2026] Adaptive Bi-SADA:告别“脆弱巨人”,赋予大模型硬核情感推理能力
Adaptive Bi-SADA: Bidirectional Structure-Aware Data Augmentation for Robust Aspect Sentiment Quadruplet Prediction
本文提出了 Adaptive Bi-SADA,一种针对方面级情感四元组预测(ASQP)的长度自适应双向结构增强数据增强框架。通过 Probe-and-Cure 机制,该方法在 Qwen-2.5 和 Llama-3.1 等大模型上实现了新的 SOTA 性能,并显著提升了模型在面对复杂句式时的结构鲁棒性。
TL;DR
尽管大语言模型(LLMs)在情感四元组预测(ASQP)中刷爆了榜单,但它们往往只是记住了“位置”而没有理解“逻辑”。本文揭示了 SOTA 模型在面对复杂语法时的溃败,并提出 Adaptive Bi-SADA 模型:通过对短句“加压硬化”和对长句“脱水规范”,将浅层模式匹配转化为稳健的结构推理,不仅刷新了 F1 记录,更在对抗测试下稳如泰山。
背景定位:高分低能的“脆弱巨人”
在方面级情感分析(ABSA)的最细粒度任务 —— ASQP(预测方面项、类别、意见项、极性)中,基于 Instruction Tuning 的大模型已成为绝对主流。然而,作者通过一系列“外科手术式”的对抗攻击发现,这些模型更像是依赖统计概率的“词袋子”。只要稍微改变句式(如使用倒装或加入插入语),模型就会陷入幻觉。
痛点深挖:三种致命的“结构缺陷”
研究团队设计了 Multi-Surgical Adversarial Attack 协议,精准打击模型的三个软肋:
- 逻辑鲁棒性缺失:引入对比干扰项(如“是 A 而非 B 是好的”),模型常会误抓 B。
- 工作记忆跨度短:在方面项和意见项间插入长从句,模型会发生“跨度丢失”。
- 位置偏见(Positional Bias):改变词序(如被动语态),模型甚至会将“好评”预测为“中立”。

核心方法:Adaptive Bi-SADA 课程学习
为了修复上述病态特征,作者提出了自适应双向结构感知数据增强(Adaptive Bi-SADA)。其核心直觉在于:不同的句子长度需要不同的教学策略。
1. 短句:自然结构硬化 (Natural Structural Hardening)
短句结构简单,模型极易产生位置依赖。Bi-SADA 将其改写为复杂的分裂句(Cleft sentences)或被动语态。这迫使模型在训练时必须学会解析层级化的语法树,而不能仅仅依赖词项的邻近性。
2. 长句:语法规范化 (Syntactic Normalization)
冗长且口语化的长句充满噪音。Bi-SADA 将其简化为标准的 SVO(主谓宾)结构。这相当于为模型提供了清晰的“注意力锚点”,帮助其在接触复杂变体前,先精准掌握情感语义。
3. 生成时验证协议
为了防止增强数据中出现标签漂移,作者引入了严格的验证网关:必须保留所有 Ground-truth 术语,且不得引入新的形容词,确保语义流形(Semantic Manifold)的绝对纯净。
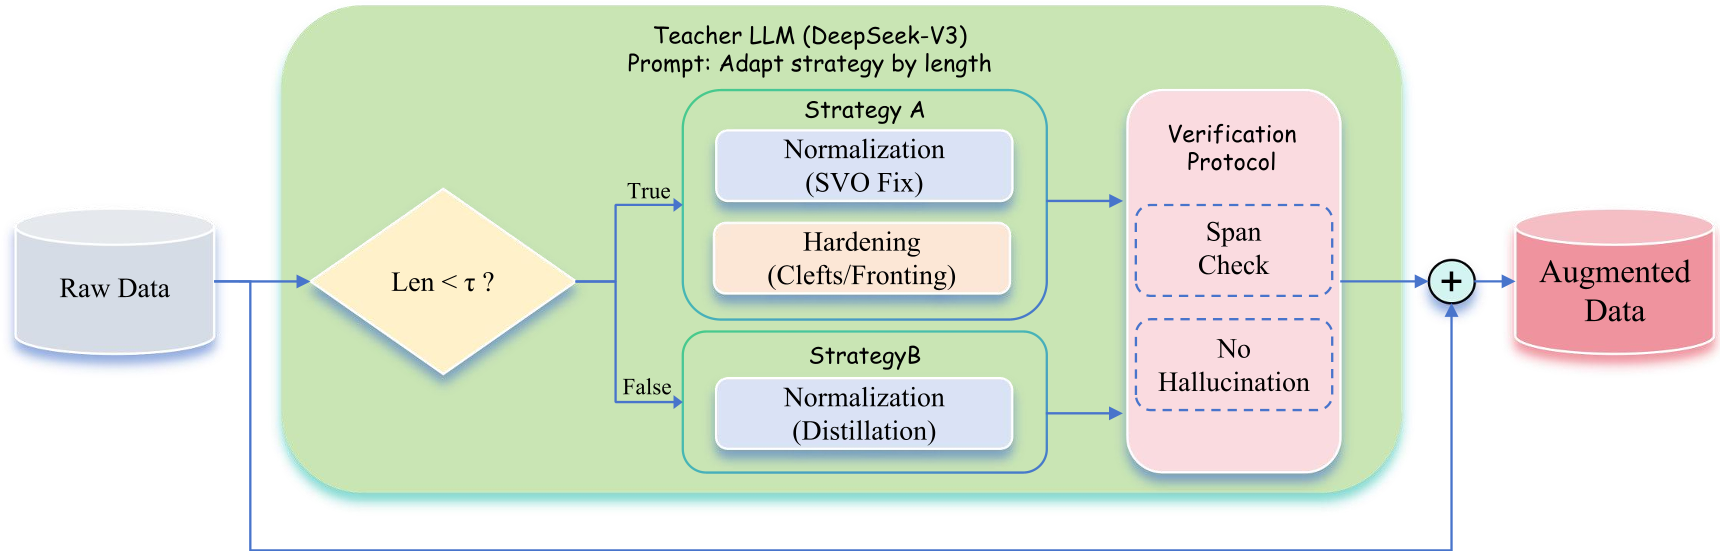
实验与结果:全线霸榜与极致鲁棒
实验覆盖了 Qwen-2.5, Llama-3.1, Mistral 三大主流架构。
- SOTA 突破:Bi-SADA 版 Qwen-2.5 在 Rest-ACOS 数据集上的 F1 提升了约 4.5%,超越了 E4L 等强基线。
- 对抗表现:在对抗性集合 上,传统模型性能断崖式下跌,而 Bi-SADA 增强后的模型维持了极高的稳定性。特别是 Mistral 变体,表现出的性能缺口(Gap)微乎其微。

深度洞察:为什么“长短有别”有效?
消融实验证明,单纯的硬化或简单的规范化都无法达到最优。
- Hardening(加压) 是防御攻击的关键(对抗表现提升显著)。
- Normalization(减压) 是维持标准准确率的基石(防止模型因数据太难而跑偏)。 这种**双向(Bidirectional)**策略完美平衡了模型的泛化能力与解析精度。
结论与展望
Adaptive Bi-SADA 证明了:通过精心设计的结构化课程,即使是中等规模的开源 LLM(如 7B/8B),也能在极具挑战性的细粒度抽取任务中展现出超越“直觉”的深层推理能力。未来,该方法有望扩展到跨语言场景,解决更复杂的低资源结构化抽取问题。
主编点评:该研究最耀眼的地方在于它不仅仅是在堆算力刷榜,而是通过语言学直觉(语法硬化)去纠正深度学习中由来已久的“捷径学习”顽疾。