
Agent-GWO:借鉴狼群智慧,实现 LLM 提示词与超参数的自动化协同进化
Agent-GWO: Collaborative Agents for Dynamic Prompt Optimization in Large Language Models
2026-01-01
总结
问题
方法
结果
要点
摘要
本文提出了 Agent-GWO,一个专为复杂推理任务设计的动态提示词优化框架。该方法通过模拟灰狼优化算法(Grey Wolf Optimizer)的领导者-追随者机制,在不进行参数微调的情况下,实现了提示词模板与解码超参数的自动化协同进化。
TL;DR
Agent-GWO 是一种创新的推理增强框架,它将复杂的推理任务抽象为“狼群狩猎”。通过协同优化提示词(Prompts)和解码配置(Decoding Hyperparameters),该框架在无需重新训练模型的情况下,在数学(GSM8K, MATH)和混合推理任务上刷新了 SOTA 表现。
1. 痛点深挖:提示词的“脆弱性”与搜索空间的“割裂”
当前大语言模型(LLM)的推理高度依赖 Chain-of-Thought (CoT)。然而,学术界和工程界正面临两个棘手问题:
- 提示词脆弱性 (Prompt Brittleness):微小的措词改动或示例顺序变化都能导致模型表现剧烈波动。
- 配置空间孤立:优化提示词的工作通常固定了解码参数,而优化参数的工作又忽略了提示词的影响。事实上,一个适应高 Temperature 的提示词,在低 Temperature 下表现可能并不理想。
2. 核心直觉:灰狼优化 (GWO) 的跨界应用
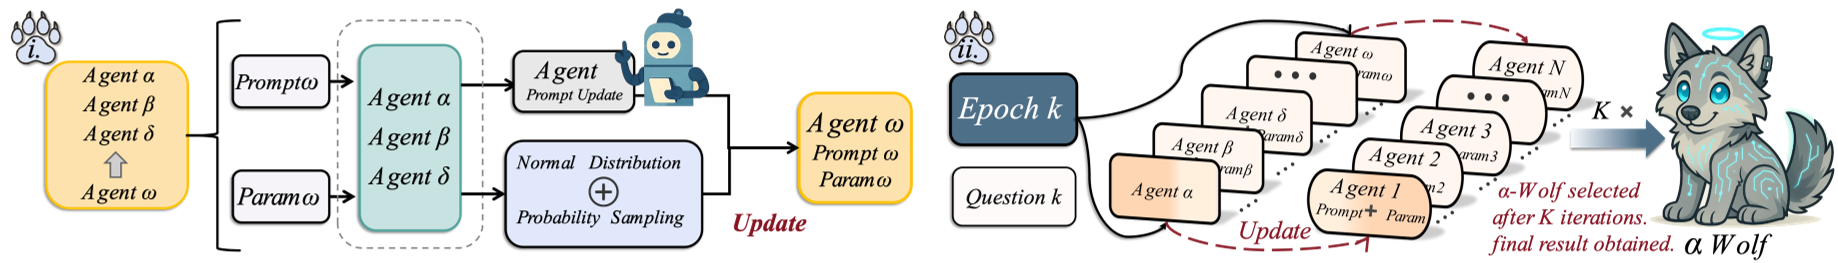
作者引入了经典元启发式算法——灰狼优化 (Grey Wolf Optimizer)。在 Agent-GWO 中,每个推理智能体被视为一只“狼”,其 DNA 由两部分组成:
- Prompt 基因:推理模板、格式约束等。
- 解码参数基因:包括 Temperature, Top-p, Frequency Penalty 等。
协作机制
系统维持一个智能体种群,通过迭代进行优化:
- 分层评价:根据逻辑一致性、创造力和完整性对智能体打分。
- 领导者引领:选出表现前三的智能体(, , )。
- 种群进化:普通智能体()向三位领导者的配置靠拢。超参数通过正态分布加权采样更新,提示词则利用 LLM 进行受控的编辑(如步骤重排、语义转述)。
3. 实验结果:全方位的性能碾压
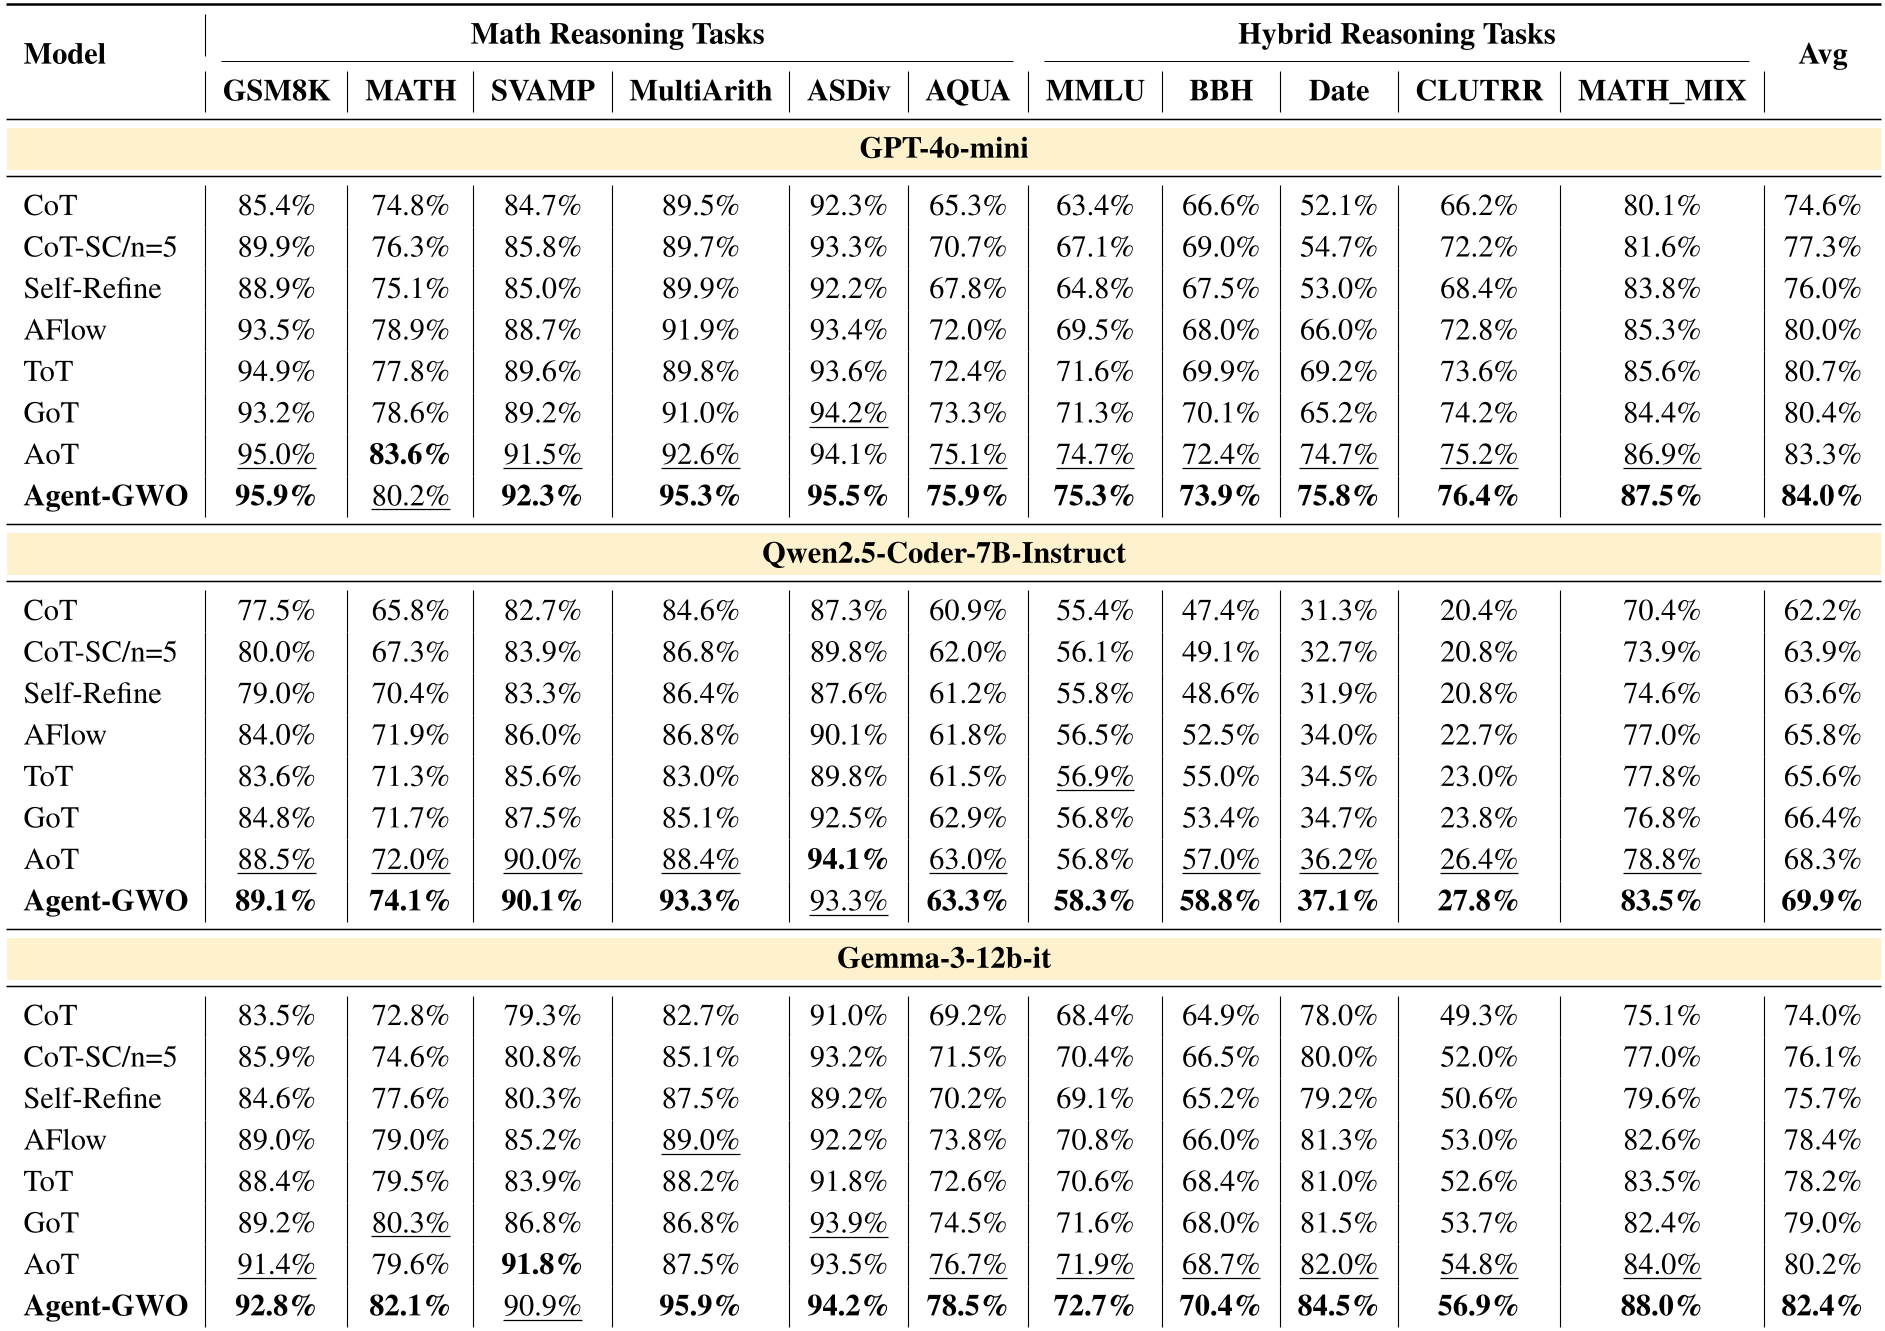
在涵盖 GSM8K、MATH 等 11 个基准测试中,Agent-GWO 展现了统治级的表现:
- 大幅超越基线:在 GPT-4o-mini 上,其平均表现超越了传统的 CoT-SC 和 Self-Refine。
- 广泛的适配性:无论是 OpenAI 的闭源模型还是 Qwen、Gemma 等开源模型,Agent-GWO 均带来了显著的 Acc 提升(最高提升达 20% 以上)。
4. 深度洞察:为什么它有效?
- 联合优化的 Inductive Bias:Agent-GWO 发现,最优的推理状态并非存在于某一个孤立的点,而是提示词与解码参数的“共振”。
- 由于避免了局部最优:多智能体并行搜索结合 GWO 的随机扰动机制,使得算法能够跳出局部最优的提示词陷阱。
- 成本与收益的平衡:尽管推理成本随智能体数量(n)增加,但消融实验(Ablation Study)显示,当 或 时,即可在可接受的计算开销内获得绝大部分收益。
5. 总结与局限
Agent-GWO 为 LLM 时代的测试时缩放(Test-time Scaling)提供了一个新颖的视角。它通过群体智能减少了人工调优提示词的繁琐过程。
局限性:
- 计算开销:由于涉及多智能体并行及多轮迭代,推理延迟较高,目前更适用于离线推理或对准确率要求极高的严肃科研/工程场景。
- 未来展望:如何引入更高效的调度算法(Compute-aware Scheduling)来降低搜索成本,将是该领域的下一个突破口。
Takeaway: 推理不仅是模型的能力问题,更是配置空间的优化问题。Agent-GWO 用“演化”给出了目前的最佳答案。