
智能体适应性的 2x2 蓝图:从参数微调到工具进化的全范式重构
Adaptation of Agentic AI: A Survey of Post-Training, Memory, and Skills
本文提出了名为 "Adaptation of Agentic AI" 的统一框架,旨在整理并定义大模型智能体(LLM Agents)在预训练后的能力演进。核心方法将智能体适应划分为四种范式(A1, A2, T1, T2),涵盖了从参数微调到外部工具/存储系统的全栈改进方案。
TL;DR
大语言模型(LLM)正从单纯的“聊天机器人”进化为拥有手、眼、脑的“智能体”。然而,我们如何让这些智能体在特定任务中表现更好?这篇由 UIUC 韩家炜教授团队领衔的重磅综述,提出了一套全新的维度:A1、A2、T1、T2 四大范式。它告诉我们:有时候,与其费力去微调那个千亿参数的“大脑”(Agent),不如去优化它手里的“工具”(Tool)。
1. 现状:破碎的智能体研究坐标系
当前的智能体研究处于“碎片化”状态。有人在改 Prompt(提示词),有人在搞 RAG(检索增强),还有人在做 RLHF(强化学习)。论文指出,智能体系统在长程规划(Long-horizon planning)和跨领域泛化上依然笨拙。
作者通过后训练 (Post-training)、记忆 (Memory) 和 技能 (Skills) 三个机制,将各种繁杂的技术路径统一到了“适应(Adaptation)”这一核心概念下。
2. 核心架构:四种适应范式
这是本文最有价值的直觉贡献。作者将智能体工具系统解构为两个轴向:改进谁(Agent 还是 Tool) 以及 靠什么信号改进(执行结果还是最终答案)。
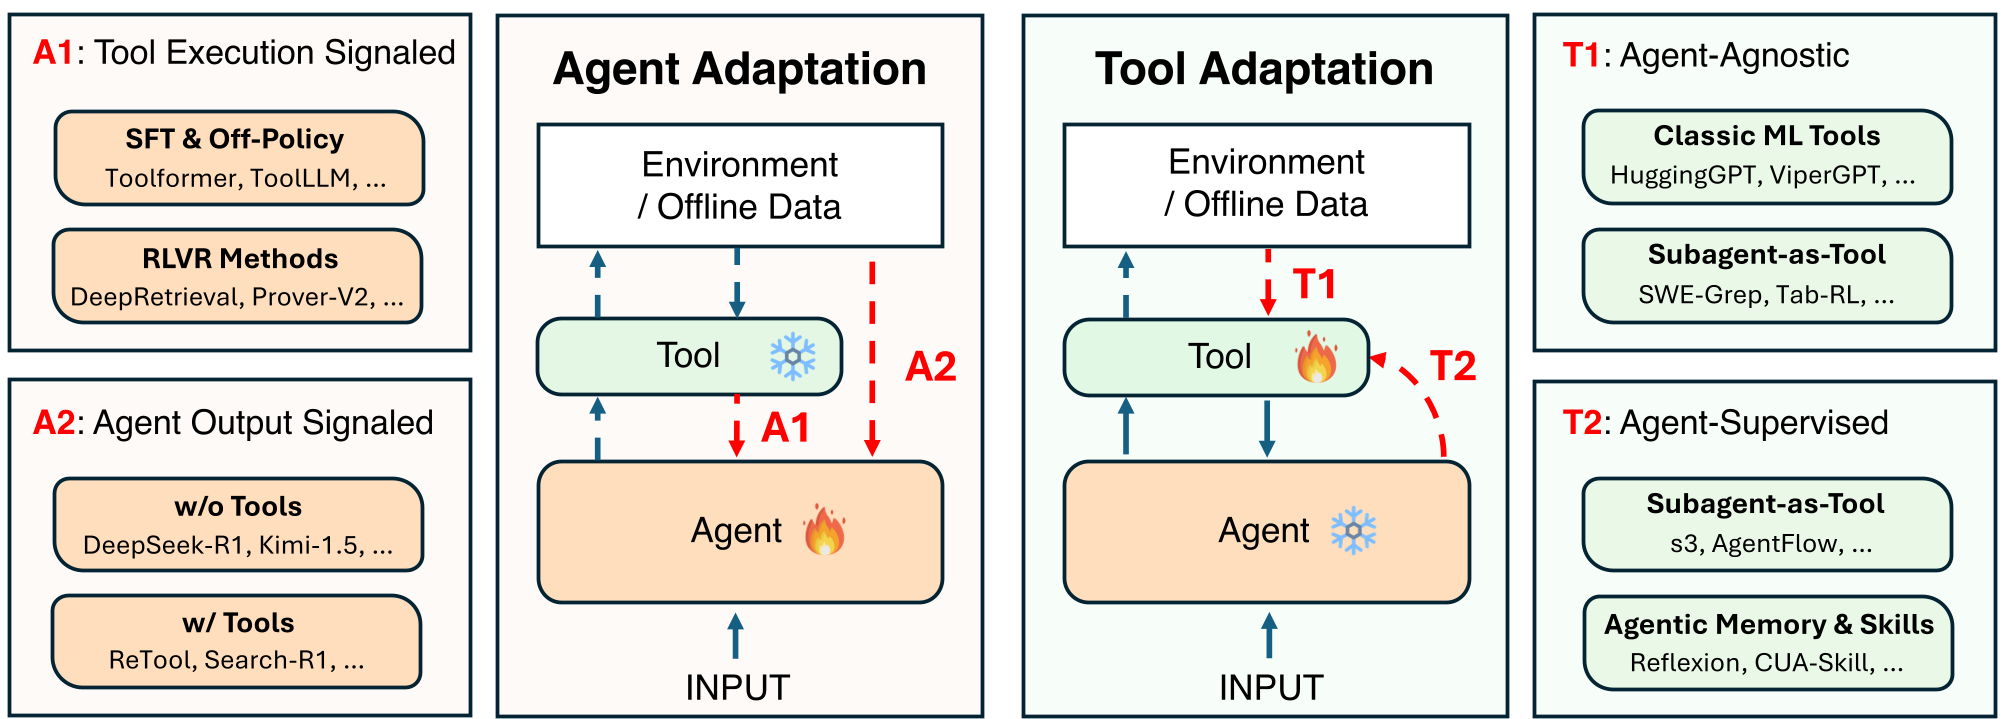
- A1 (Tool-Execution-Signaled):通过工具执行结果改进智能体。例如:代码跑通了没有?检索回来的文档相关吗?这是一种“因果级”的反馈。
- A2 (Agent-Output-Signaled):基于最终输出改进智能体。大名鼎鼎的 DeepSeek-R1 就是典型代表,通过强化学习优化推理轨迹。
- T1 (Agent-Agnostic):即插即用的预训练工具。如 CLIP 视觉模型、AlphaFold 蛋白预测模型。
- T2 (Agent-Supervised):根据智能体的需要来“量身定制”工具。比如训练一个专门给 GPT-4 准备搜索摘要的小模型。
3. 方法论详解:为什么 T2 范式是未来的关键?
微调一个大模型(Agent Adaptation)极其昂贵且容易产生“灾难性遗忘”。论文中对比了一个有趣的案例:
- A2 方案 (Search-R1):训练整个模型学习检索+推理,需要 17 万条数据。
- T2 方案 (s3):保持大模型不动,只训练一个小型的搜索智能体作为其“向导”,仅需 2400 条数据。
两者的效率差距高达 70 倍! 这种“解耦”思想是未来构建高效、可进化 AI 系统的重要指导原则。
4. 实验与结果对比:性能与成本的博弈
论文通过多个维度的对比(Data Efficiency, Generalization, Modularity),清晰展示了不同范式的战绩:
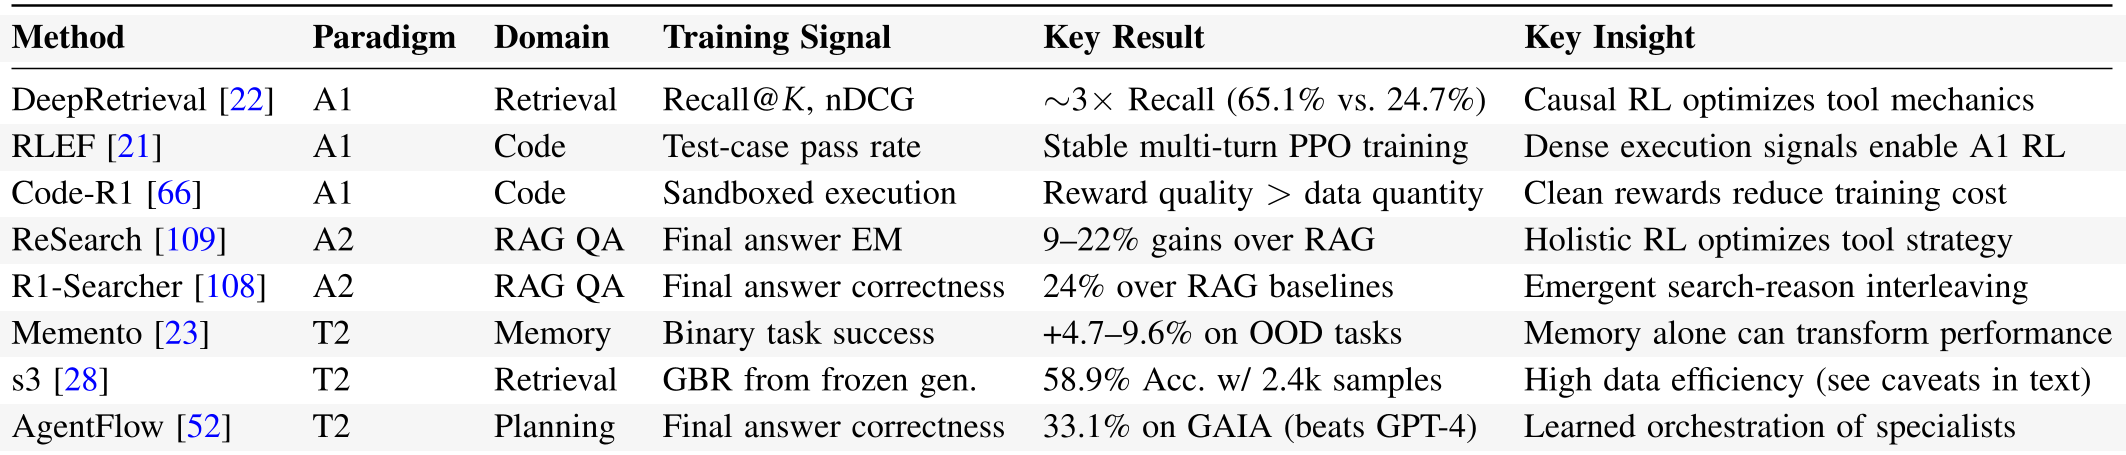
关键发现:
- A1 范式在代码、SQL、自动定理证明等拥有“编译器反馈”的场景下效率极高。
- T2 范式在记忆管理(Persistent Memory)和定制化搜索中表现稳健,且不会损害大模型本身的通用能力。
- “毕业”机制 (Graduation Path):A1/A2 训练出来的优秀智能体,未来可以被冻结成为 T1 工具,供其他更强大的模型调用。
5. 深度洞察:协同演化 (Co-adaptation)
论文在末尾抛出了一个极具前瞻性的论点:协同自适应。未来的智能体系统不应该是单向的训练,而应该是“大脑”和“工具”像人与火、人与计算机一样,在交互中同时进化。
局限性分析: 当前的评估体系(Benchmarks)依然落后于范式的发展。尤其是 T2 范式,我们需要不仅能测量智能体“智商”,还能测量工具“趁手程度”的全新评估标准。
总结
这篇文章不仅是一篇 Survey,它更像是一份智能体工程的“使用说明书”。它提醒我们:AI 的力量不仅源于更聪明的大脑,更源于学会如何更好地利用和自我完善身边的工具。