
揭秘 AI Agent 的搜索内幕:1400 万次请求背后的行为逻辑
Agentic Search in the Wild: Intents and Trajectory Dynamics from 14M+ Real Search Requests
本文对 DeepResearchGym 平台上 1444 万条真实搜索请求(397 万个会话)进行了大规模日志分析,揭示了 AI Agent 在执行多步信息寻求任务时的行为模式。研究提出了 CTAR 指标量化证据追溯性,并发现推理型任务倾向于广度探索,而事实获取型任务常陷入高重复率的死循环。
TL;DR
传统的搜索日志分析主要针对人类,而当搜索的主体变成 AI Agent 时,规律发生了巨变。本文通过对 DeepResearchGym 海量日志的深度挖掘,发现 Agent 搜索并非盲目,而是具有极强的“意图驱动”特征。虽然 Agent 动作极快,但也容易陷入“复读机”式的死循环。研究提出的 CTAR 指标首次量化了 Agent “活学活用”检索证据的能力。
背景定位:从“人搜”到“智能体搜”
在 AI 时代,信息检索(IR)正从单次点击演变为多步规划的 Agentic Search。传统的点击(Clicks)和停留时间(Dwell Time)已不再适用,我们需要一种新的范式来衡量 Agent 的搜索效率和证据利用率。
核心发现:Agent 搜索的三大奇观
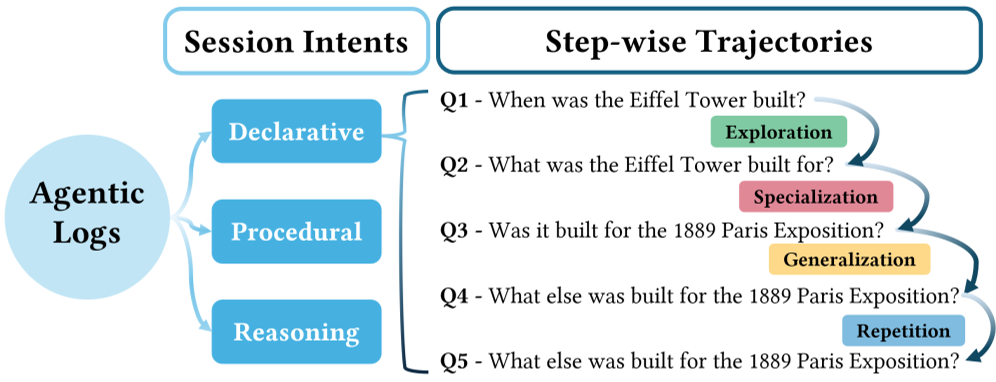
1. 意图决定策略:事实型 vs 推理型
通过对会话意图的标注,研究者发现:
- 事实获取(Declarative):Agent 表现得异常保守,后期大量出现重复查询(Repetition),试图通过微调词句来验证某个特定事实。
- 推理合成(Reasoning):Agent 表现出更强的探索欲,语义漂移(Semantic Drift)更大,能够不断根据新证据挖掘深层信息。
2. “钻牛角尖”的演化偏置(Drill-down Bias)
Agent 在重构查询时,非常喜欢 Specialization(特化) 和 Exploration(局部探索),即在已知领域越挖越深;而极少进行 Generalization(泛化)。这说明当前的 Agent 逻辑往往是“一条路走到黑”,缺乏“退一步海阔天空”的宏观重新规划能力。
3. CTAR:Agent 到底有没有在看检索结果?
为了回答这个问题,作者提出了 Context-driven Term Adoption Rate (CTAR)。
- 数据说话:超过 54% 的新查询术语可以直接在之前的检索结果中找到原型。
- 路径差异:当 Agent 进行“特化”操作时,78.35% 的新词来自刚才读到的文档;而当它陷入“重复”循环时,CTAR 骤降,说明它在脱离上下文“盲搜”。
实验深度解析
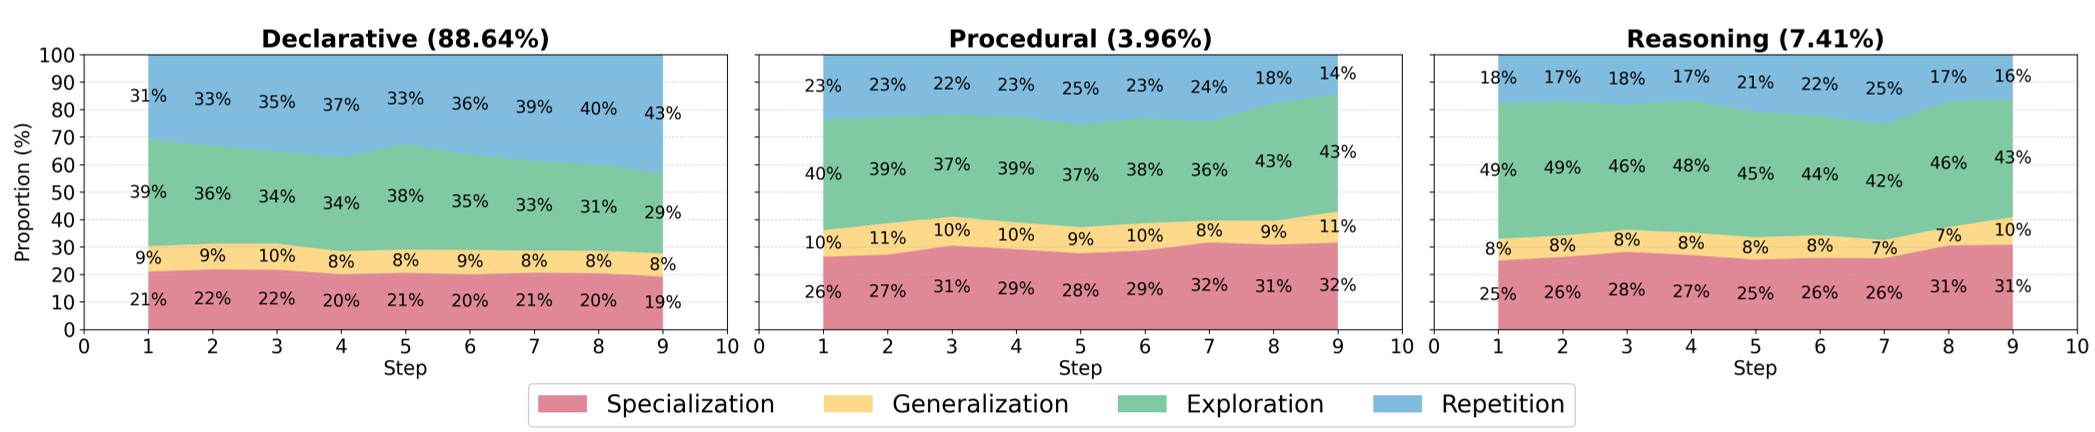
实验通过对比不同意图下的步骤动态(Figure 4),清晰展示了 Agent 行为的演化:
我们可以看到:
- 在 Declarative 任务中,Repetition(灰色)的占比随步数显著上升。
- 在 Reasoning 任务中,Exploration(蓝色)始终占据主导,保持了搜索的生命力。
行业启示:如何设计更好的搜索 Agent?
- 重复感知停止(Repetition-aware Stopping):如果监测到系统进入高稳定性、低 CTAR 的循环,应强制触发反思机制或请求人工介入。
- 动态检索预算(Intent-adaptive Budgeting):没必要为所有查询设定统一的检索深度(K 值)。程序类查询(Procedural)往往需要更深的 K 值来覆盖长尾步骤。
- 显式上下文跟踪:既然新词高度依赖历史证据,系统可以主动提取关键词供 Agent 决策,减少幻觉风险。
局限性与展望
尽管样本量巨大,但由于日志脱敏,研究无法直接获取 Agent 内部的 Prompt 或记忆状态。未来的研究需进一步探索这些行为模式与最终回答准确率(Success Rate)之间的因果关联。
总结
本文不仅是一次大规模的统计实践,更是为 Agentic IR 体系建立了一个坐标系。它告诉我们:Agent 会搜索,但还不够“聪明”,尤其是在打破僵局和战略性撤退方面,仍有巨大的优化空间。