Agents' Last Exam: 当 AI 走进真实职场,谁能通过这最后一场“职业资格考”?

Agents' Last Exam

2026-01-01
Yiyou Sun, Xinyang Han, Weichen Zhang, Yuanbo Pang, Tianyu Wang, Yuhan Cao, Yixiao Huang, Chris Duroiu, Haoyun Zhang, Jeffrey Lin, Weishu Zhang, Tyler Zeng, Ying Yan, Bo Liu, Hanson Wen, Mingyang Xu, Xiaoyuan Liu, Zimeng Chen, Weiyan Shi, Amanda Dsouza, Vincent Sunn Chen, Patrick Bryant, Carl Boettiger, Yamini Rangan, Bradley Rothenberg, Kyle Steinfeld, Arvind Rao, Tapio Schneider, Georgios Yannakakis, Laure Zanna, Kaan Ozbay, Ida Sim, Tarek Zohdi, George Em Karniadakis, Jack Gallant, Teresa Head-gordon, Yushan Li, Wenxi Deng, Tao Sun, Huiqi Wang, Zhun Wang, Justin Xu, Chris Yuhao Liu, Yafei Cheng, Rongwang Hu, Aras Bacho, Shengcao Cao, Zengyi Qin, Yixiong Chen, Hengduan Fan, Hao Liu, Lin Zeng, Shashank Muralidhar Bharadwaj, Litian Gong, Yingxuan Yang, Maojia Song, Ruheng Wang, Zongzheng Zhang, Honglin Bao, Shuo Lu, Jianhong Tu, Zhonghua Wang, Zheng Zhang, Zijiao Chen, yanqiong Jiang, Zhendong Li, Bohan Lyu, Chang Ma, Peiran Xu, Benran Zhang, Shangding Gu, Haoyue Hua, Haoyang Li, Wanzhe Liao, Chengzhi Liu, Junbo Peng, Haoran Sun, Zechen Xu, Bo Chen, Jiayi Cheng, Yi Jiang, Keying Kuang, Yuan Li, Youbang Pan, Ziyan Rao, Alexander Schubert, Yifan Shen, Vincent Siu, Xiatao Sun, Kangqi Zhang, Xiaopan Zhang, Yuchen Zhu, Ishaan Singh Chandok, Lei Ding, Jingxuan Fan, Andrew Glover, Jiaming Hu, Yiran Hu, Wenbo Huang, Zixin Jiang, Haoran Jin, Lukas Kim, Ming Liu, Yang Liu, Alireza Rafiei, Xuhuan Shen, Kunyang Sun, Sophia Sun, Ting Sun, Eric Wang, Yixin Wang, Hanwen Xing, Sihan Xu, Yuzheng Xu, Zhongxing Xu, Zhiling Yan, Boqin Yuan, Ruiqi Zhang, Yifan Zhang, Zibo Zhao, Liana, Santanu Bosu Antu, Haoyue Bai, Carlo Bosio, Joseph Cavanagh, Patricia Cavazos-Rehg, Tianxing Chen, Xuewen Chen, Yipu Chen, Zhu Chenyu, Chen Dai, Stefano De Castro, Yunfu Deng, Kaustubh Dhole, Jiayuan Ding, Chenchen Du, Zhehang Du, Hao Fan, Run-ze Fan, Hengyu Fu, Shi Gu, Yifan Gu, Charlie Guo, Baihe Huang, Baixiang Huang, Rimika Jaiswal, Zhihan Jiang, Ran Jin, Erin Kasson, Xin Lan, Joseph Lee, Deren Lei, Chenyu Li, Daofeng Li, Haitao Li, Hongwei Li, Jingyan Li, Xiao Li, Yi Li, Yinsheng Li, Yuangang Li, Zhixu Li, Wenyu Liang, Longtai Liao, Kevin Qinghong Lin, AndyZeyi Liu, Che Liu, Jiaming Liu, Kaiyuan Liu, Xuan Liu, Pan Lu, Wenbo Lv, Yicheng Lv, Qiuyang Mang, Kyle Montgomery, Yuzhou Nie, Ruoxi Ning, Jorin Overwiening, Xu Pan, Layna Paraboschi, Core Francisco Park, Justin Purnomo, Swati Rajwal, Scott Rankin, Bixuan Ren, Yiren Rong, HaoYang Shang, Ventus Shaw, Fiona Shen, Jiawei Shen, Minqi Shi, Qiu Shi, Huaxiu Yao, Tianneng Shi, Jonah So, Vladislav Susoy, Hannah Szlyk, Haocheng Wang, Jialu Wang, Wei Wang, Xinyu Wang, Zehao Wang, Dowling Wong, Angela Wu, Dehao Wu, Fangyu Wu, Mengyuan "Millie" Wu, Yu Wu, Yuchen Wu, Yuhao Wu, Qingpo Wuwu, Weihang Xiao, Yongyi Xiong, Fan Xu, Ruiling Xu, Mingxuan Yan, Benjamin Yang, Jirong Yang, Sen Yang, Xiaoli Yang, Yushi Yang, Haoran Ye, Xiaohu Yu, Zhengming Yu, Chenlong Zhang, Chi Zhang, Hanning Zhang, Hanwen Zhang, Junge Zhang, Kunpeng Zhang, Song Zhang, Wenjin Zhang, Wenshuo Zhang, Ying Zhang, Yizhi Zhang, Brian Zhao, Qijian Zhao, Yimin Zhao, Yuhaohua Zheng, Liwei Zhou, Tianyue Zhou, Sichen Zhu, Siqi Zhu, Yan Zhu, Yishu Zhu, Jierui Zuo, Chonghao Cai, Helena Casademunt, Wenjia Chen, Benjamin Cheng, Nawen Deng, Rao Fu, Tianfu Fu, Yifan Han, Ren He, Zhenyu He, Qiao Jin, Lang Lang, Yuetai Li, Sylvia Liu, Lu Lu, Qing Lu, Subhabrata Mukherjee, Yunqi Ouyang, Yin Ren, Dawei Shi, Haoran Wu, Zhiyue Wu, Hannah Yao, Zhuoran Yi, Jenny Yu, Rhea Zhan, Hang Zhou, Blake Zhu, Junfan Zhu, Alan Yuille, Yang Liu, Russell Alan Poldrack, Jiachen Li, Zhenglu Li, Molei Tao, Jing Huang, Wenqi Shi, Costas Spanos, Lichao Sun, Chenguang Wang, Orson Xu, Zhen Dong, Hector Gomez, Aylin Caliskan, Ali Emami, Haimin Hu, Zhi Li, Lihui Liu, Murphy Niu, Yi Shao, Jianxin Sun, Mikko Tolonen, Ting Wang, Sanjiv Das, Yanjun Gao, Wenbo Guo, Erika J Schneider, Zhiyong Lu, Mark Mueller, Radha Poovendran, Somayeh Sojoudi, Dawn Song
总结
问题
方法
结果
要点
摘要

本文推出了 Agents' Last Exam (ALE),一个旨在评估 AI Agent 处理长程、真实且具有经济价值的工作流的基准测试。ALE 与 250 多位行业专家合作开发,涵盖了 13 个行业集群的 1000 多个任务,通过确定性脚本和结构化量规实现自动验证,是目前最贴近真实职业环境的 Agent 测评体系。

TL;DR

如果 AI Agent 能够像人类专家一样操作各类专业软件、处理数小时甚至数周的工作流,全球 GDP 将迎来指数级增长。然而,目前的 AI 在榜单上是“学霸”,进入职场可能连“实习生”都不如。由 UC Berkeley 团队领衔、联合 250 多位专家开发的 ALE (Agents' Last Exam) 正式发布,它用 1000 多个真实的职业任务敲碎了 AI 的幻觉:在最难的职业任务中,最强 Agent 的通过率仅为 2.6%

背景定位:从“做题题库”到“职业资格证”

在 AI 领域,我们不缺基准测试(Benchmarks)。从考常识的 MMLU 到考编程的 SWE-bench,AI 已经刷新了一个又一个记录。但 ALE 的作者们敏锐地指出:榜单胜利尚未转化为经济产出

现有的测试要么太短(几分钟搞定),要么太单一(只用终端或浏览器)。ALE 则是基于美国联邦职业分类体系 (O*NET / SOC 2018) 构建,涵盖了从金融分析、生物设计到工业制造的 55 个细分领域。它不是在考 AI 会不会说话,而是在考 AI 能不能在 Windows/Linux 虚拟机里,熟练使用 SolidWorks 绘图、用 Dorico 打谱、或在 MicroDicom 中审阅 X 光片。

痛点深挖:为什么“懂道理”的 Agent 做不好“专业活”?

论文揭示了一个残忍的真相:Agent 的失败并不总是因为“手笨”(点击位置出错),更多是因为“没脑子”或“没常识”。

即使是 GPT-5.5 级别的模型,在面对复杂的跨软件协作时,也经常陷入:

  1. 领域知识鸿沟 (Domain Knowledge Gap):不理解注塑模拟中的收缩率,或不知道音乐编辑中的音轨规范。
  2. 理解与执行脱节:明白要干什么,但在执行长达数小时的任务时,由于缺乏闭环验证,导致前面一个小错直接毁灭整个结果。

核心架构:Generalist CUA(全才计算机 Agent)

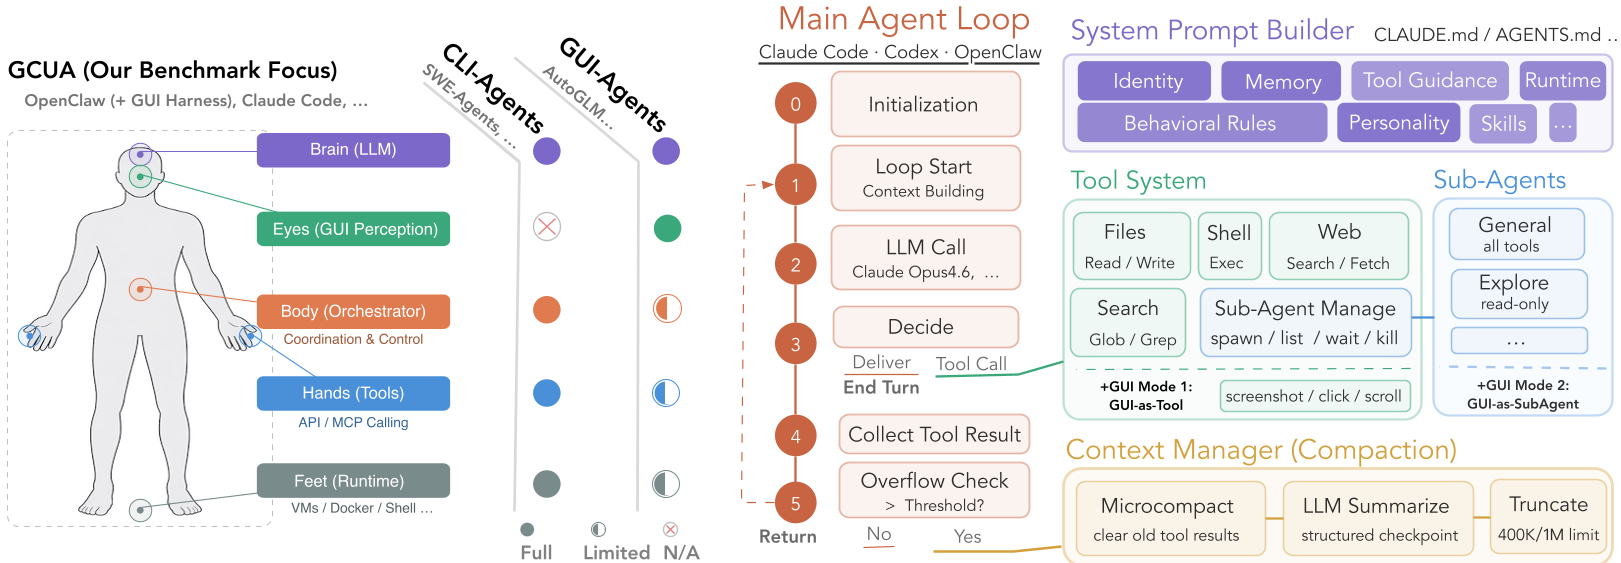
为了应对 ALE 的挑战,作者提出了 GCUA (Generalist Computer-Use Agent) 概念,将 Agent 的能力拆解为五层模型(见下图):

  • Brain (脑):LLM 推理与规划。
  • Eyes (眼):通过截图进行 GUI 视觉感知。
  • Hands (手):结构化的工具调用(CLI/GUI/API)。
  • Body (身):流程控制逻辑。
  • Feet (脚):底层运行环境(虚拟机/容器)。

模型架构图 图 1:Agent 能力层级结构,ALE 要求 Agent 在五层上均无短板。

ALE 的测试环境高度解耦,Agent 通过模拟点击、键盘输入和 Bash 命令与云端虚拟机交互。这不仅测试了 AI 的多模态理解力,更考验了它在不同软件间切换的“协同力”。

实验结果:残酷的 2.6% 通过率

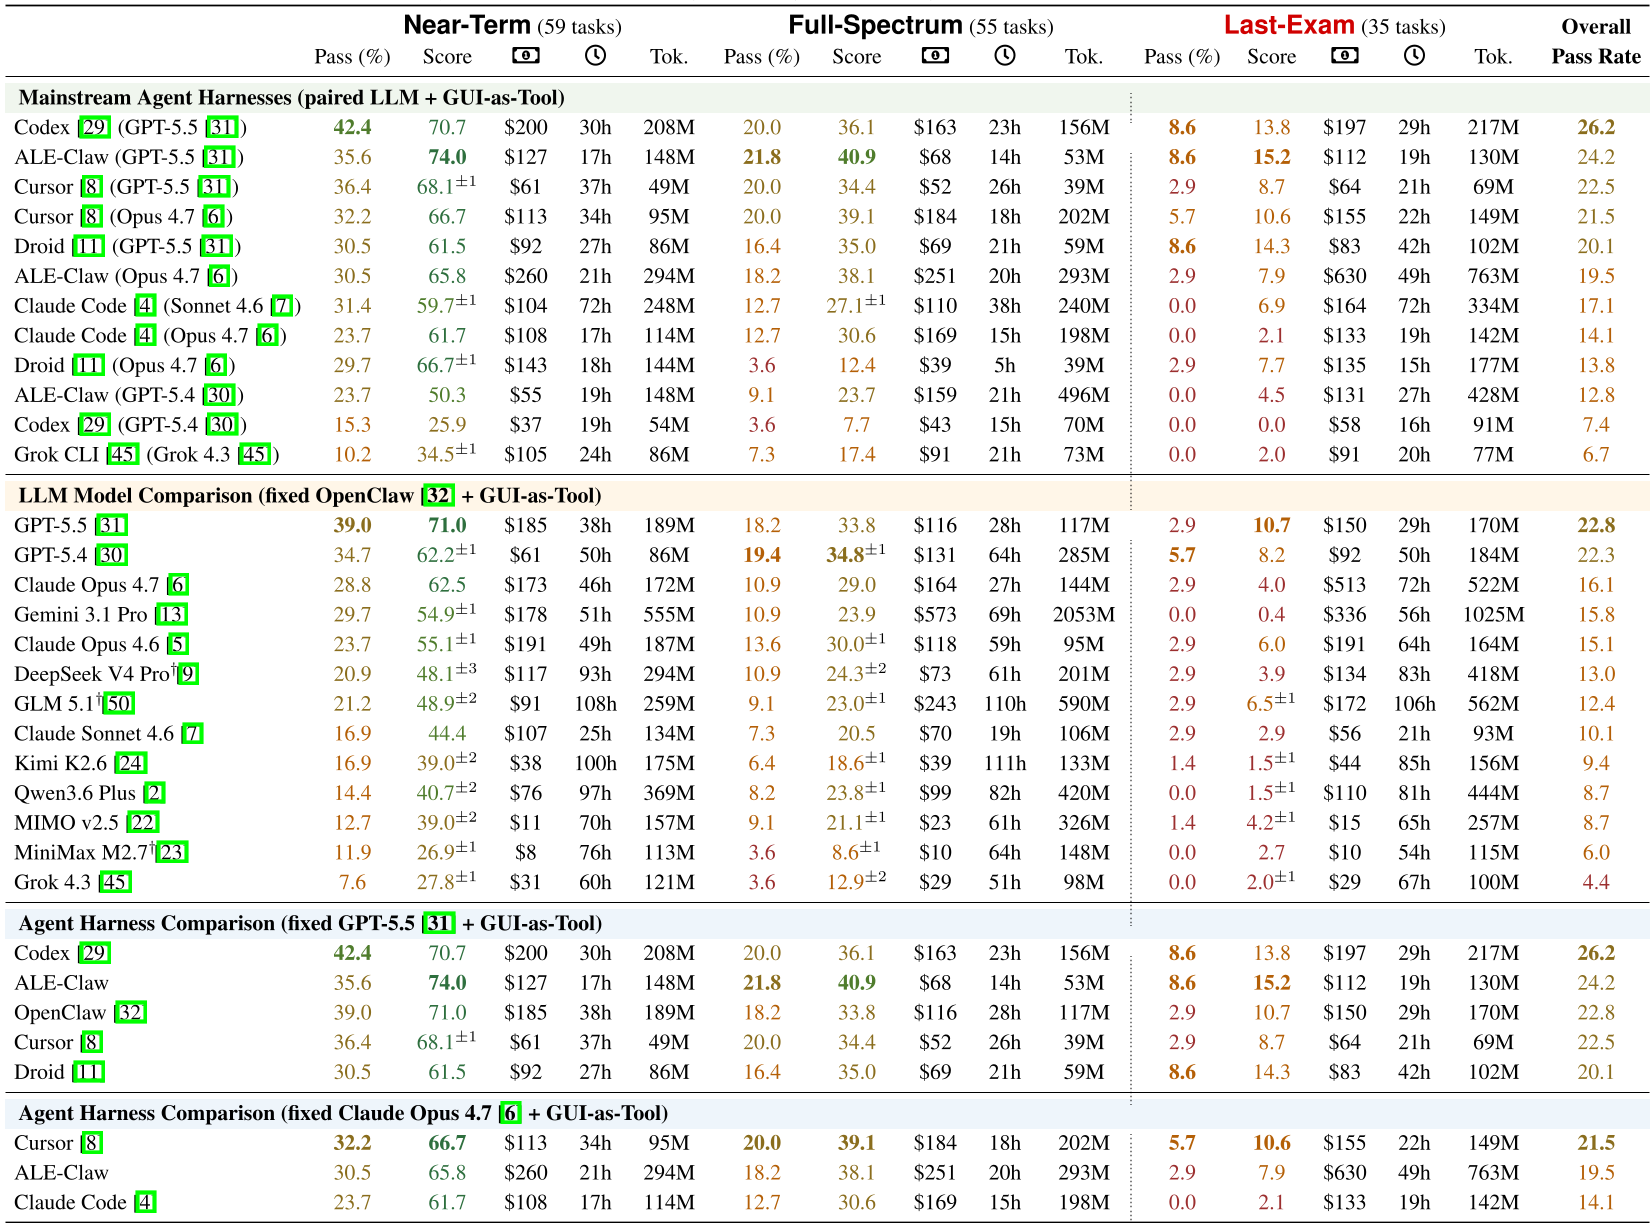
ALE 将任务按难度分为三个梯队:Near-Term(近期可达)Full-Spectrum(全频谱覆盖)Last-Exam(终极考验)

实验结果对比 图 2:主流 Agent 在不同难度梯队下的战绩。可以看到随着难度提升,通过率断崖式下跌。

关键发现:

  • 模型强才是真的强:更换底层大模型(如 GPT-5.4 到 GPT-5.5)带来的提升是更换 Agent 框架(如不同的 Prompt 策略)的 3 倍。
  • GUI 工具使用不足:虽然 34% 的任务明确需要图形界面软件,但 Agent 往往倾向于写临时脚本(Bash/Python)来规避操作 GUI,这在处理如 DA Vinci 处理视频或 CAD 建模时往往导致失败。
  • 成本极高:在 ALE 上跑一次全量测试,不仅需要数千美元的 API 费用,还需要数百小时的计算时间。

深度洞察:ALE 给行业的启示

ALE 不仅仅是一个新的排行榜,它定义了 AI 时代的“真实工作场景”:

  1. 确定性验证是硬指标:ALE 拒绝模糊的“LLM 评分”,而是通过读取文件状态、计算几何表面偏差(STL 相似度)等硬性指标。
  2. “最后考试”的意义:如果一个 Agent 能通过 ALE,它才真正具备了商业化交付的潜力。这为投资人和产品经理提供了一把尺子:你的 AI 是在跳舞,还是在干活?

总结与局限

ALE 的出现终结了 AI Agent 在简单玩具环境中的“刷榜时代”。当然,ALE 目前也面临着评估成本高昂、环境部署复杂等挑战。但正如此论文标题所示,通过这一场“最后的考试”,AI 才能真正从实验室走向 GDP 的每一个像素点里。


主编点评:ALE 可能是 2026 年最具野心的基准测试。它不再讨好模型开发者,而是真正站在行业专家的视角,给所有的通用智能体泼了一盆冷水——领域深度,永远是 Agent 迈向职业化的最后一公里。

发现相似论文

试试这些示例

  • 查找最近其他试图解决通用计算机使用 Agent (Generalist CUA) 在处理长程职业工作流时复杂性与可靠性平衡问题的研究。
  • 哪篇论文最早定义了智能体评估中的“Gate-and-score”机制,ALE 提出的确定性自动评分与 GDPval 中的人工评分在准确性上有何对比?
  • 有哪些研究正尝试将 ALE 基准测试中的领域专家知识图谱集成到大语言模型的推理循环中以减少“理解性故障”?
目录
Agents' Last Exam: 当 AI 走进真实职场,谁能通过这最后一场“职业资格考”?
1. TL;DR
2. 背景定位:从“做题题库”到“职业资格证”
3. 痛点深挖:为什么“懂道理”的 Agent 做不好“专业活”?
4. 核心架构:Generalist CUA(全才计算机 Agent)
5. 实验结果:残酷的 2.6% 通过率
6. 深度洞察:ALE 给行业的启示
7. 总结与局限