
[Patterns 2026] AI for Science 不止是算法:科学发现本质上是一个社会性难题
AI for Scientific Discovery is a Social Problem
本文由 Hugging Face 与牛津大学的研究者共同撰写,探讨了 AI 助力科学发现(AI for Science)所面临的核心障碍。文章指出,尽管 AlphaFold3 和 GNoME 等取得了技术突破,但 AI 在科学领域的民主化进程受阻于四个社会性与制度性问题:社区协调功能障碍、研发优先级错位、数据碎片化以及基础设施分配不公。
TL;DR
在 AI 驱动科学发现(AI for Science)的浪潮中,我们常被 AlphaFold 或 GNoME 的辉煌战绩吸引,认为更强的模型即是一切。然而,Hugging Face 的这篇深度评述指出:AI 在科学界的真正瓶颈不在于算法成熟度,而在于深层的社会性与制度性缺陷。 除非我们能解决社区协作、数据标准、以及算力的阶级差距,否则所谓的“AI 科学家”只能是实验室里的虚假繁荣。
背景定位
本文并非一篇提出新架构的实验报告,而是一篇具有“学科坐标意义”的观点论文。它将 AI for Science 从纯粹的“优化问题”拉回到了“科学社会学”的讨论范畴,警示研究者:如果忽略了机制性的协作障碍,AI 可能会加剧科学研究的不平等,而非加速发现。
痛点深挖:为何“预测”不是“科学”?
作者一针见血地指出,当前的 AI 开发存在一种**“AI 成功”与“科学成功”的错位**。
- AI 成功:追求极致的预测精度。比如一个 Transformer 模型能精准预测行星轨道。
- 科学成功:追求机理理解(Mechanistic Understanding)。如果模型只是学会了拟合曲线,却没有学到背后的牛顿力学,它对科学进步的贡献就非常有限。
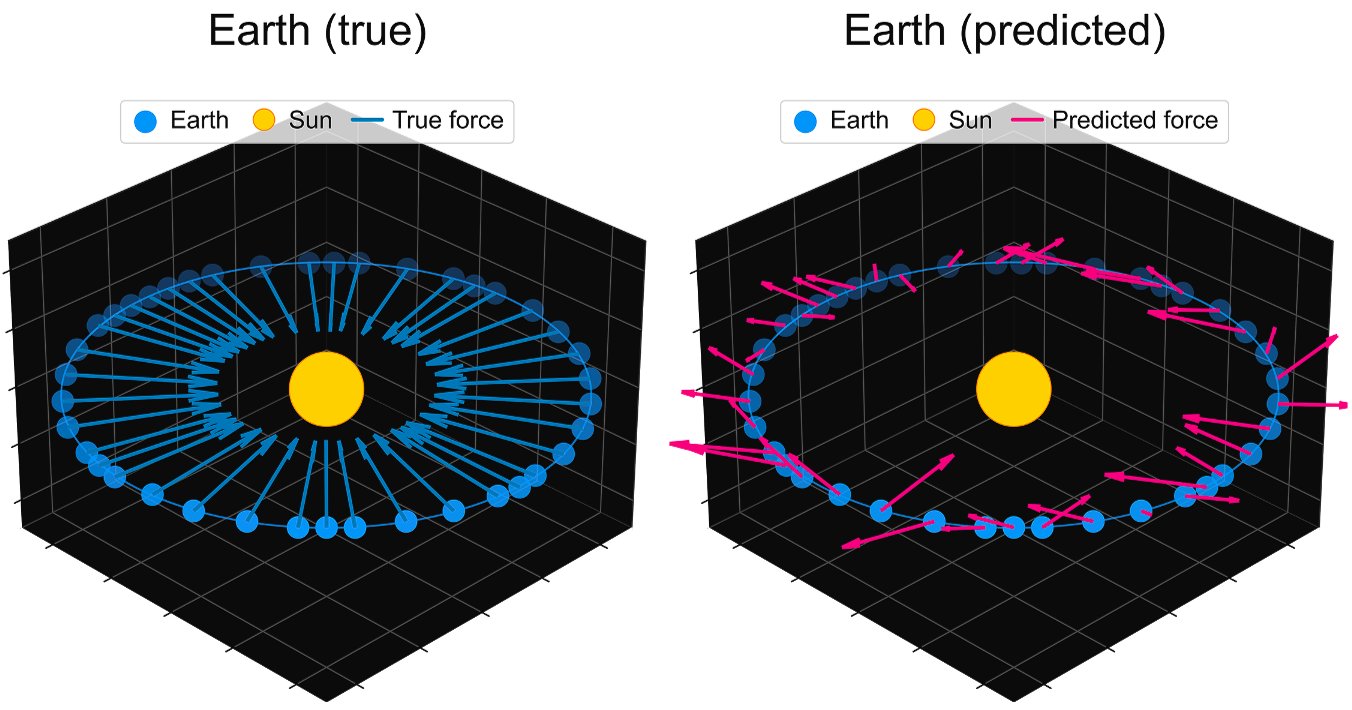 图 1:Vafa 等人的研究显示,模型虽然预测准确(右),但其捕捉的物理逻辑与真实的牛顿力学(左)并不一致。
此外,文章痛斥了**“孤胆天才型 AI 科学家”**的错误叙事。这种叙事抹杀了数据科学家、领域专家和实验员的协同价值,导致学术界在招聘和晋升时过度偏爱模型改进者,而轻视了那些为科学数据“挖井”的人(数据整理和架构维护者)。
核心障碍解析
1. 社区功能障碍 (Community Dysfunction)
IT 专家与科学家的跨学科对话就像是“鸡同鸭讲”。计算机学者关注 SOTA 精度,而物理学家关注模型是否符合能量守恒。缺乏中间人(Bridge Research)和跨学科教材是导致这种脱节的主因。
2. 研发优先级错位 (Misaligned Priorities)
目前大家都在追求下游的酷炫应用(如写论文摘要),却忽视了上游的计算瓶颈:
| 上游挑战 | 影响领域 | 当前局限 |
|---|---|---|
| PDE 神经算子 | 天气、等离子体聚变 | 在紊流等极端状态下外推失效 |
| 稀有事件采样 | 蛋白质折叠、极端气候 | 传统训练无法捕捉低概率分布 |
3. 数据碎片化与 Token 困扰
科学数据不仅仅是文本。多组学数据、高分辨率天文影像具有复杂的空间拓扑。如果暴力使用 Llama 类似的 Tokenizer,会丢失关键的生物/物理结构信息。
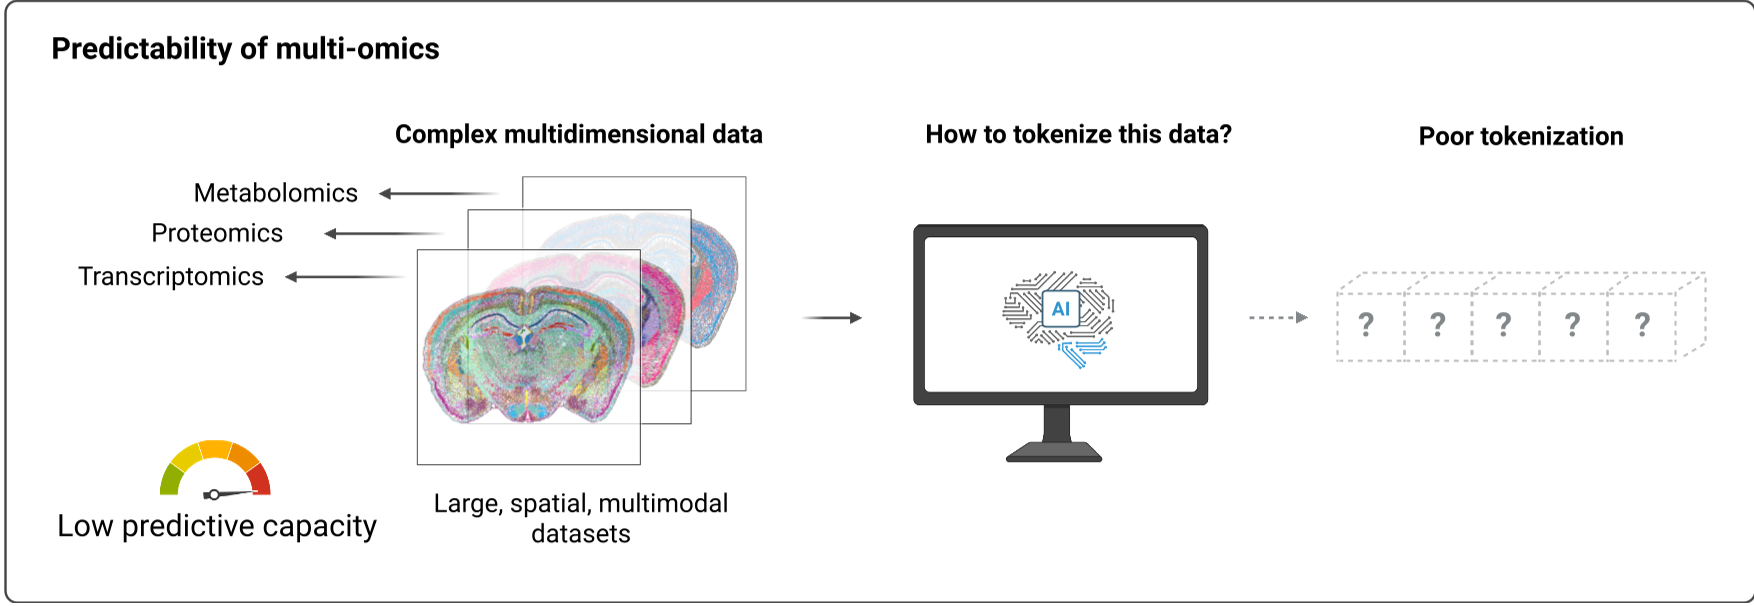 图 2:当前的 Transformer 处理文本 Token 很强,但在处理具有复杂层级和空间关系的科学数据时显得力不从心。
解药:如何构建一个 AI 驱动的集体智能?
论文提出了四大支柱性的解决方案:
- 强化协作与教育:建立像
Astropy这样透明的 API,不再让领域科学家处理繁杂的预处理,实现技术的“黑盒化可信任调用”。 - 结构化上游挑战:重塑 CASP (蛋白质结构预测竞赛) 的辉煌。CASP 的成功证明了:只要社区达成共识,确定一个公认的目标和评价标准,哪怕是几十年的老问题也可能被突破。
- 数据民主化:学习 Materials Project。该项目通过标准的 JSON 格式和 RESTful API,让 60 多万开发者能够无障碍获取材料数据。
- 社区所有的基础设施:推广如 Hugging Face Hub 和 Open Science Grid 这样的平台,打破大厂对算力的垄断。
深度洞察与总结
Takeaway:AI for Science 的成功 = 50% 的算法模型 + 50% 的社会协调。
局限性:作者坦言,虽然论文提出了治理框架,但实施这些想法需要学术评价体系、资助机构甚至是监管机构进行深层次的利益博弈和政策重构。
展望:未来的 AI for Science 应当从“让 AI 自动做实验”转向“让 AI 增强人的连接”。真正的突破将来自于通过构建物理先验(Mechanistic Priors)来降低对样本量的依赖,正如文中提到的案例:结合 Sim2Real 迁移学习,我们仅需 50 个真实实验样本就能训练出高性能模型。
科学发现是一场漫长的接力赛,AI 应该是更好的接力棒,而不是试图一个人跑完全程。