
LibAUC 赋能:突破 AI 生成文本检测的边界
ARE AI-GENERATED TEXTS DETECTABLE? AN EXPERIMENTAL STUDY USING THE LIBAUC LIBRARY
本文介绍了一种利用 LibAUC 库进行深度 X-risk 优化(如 AUC 最大化)来检测 AI 生成文本的方法。通过在 DeBERTaV3 和 DistilRoBERTa 等 Transformer 模型上应用该技术,作者在 AuTexTification 和 OUTFOX 等多个数据集上取得了超越 SOTA 基线的表现,包括在分布外(OOD)和对抗性环境下的显著提升。
核心速览 (Executive Summary)
随着大语言模型(LLM)的爆发,如何精准识别“机器代笔”已成为学术诚信、内容治理等领域的急迫难题。本论文《ARE AI-GENERATED TEXTS DETECTABLE?》通过引入 LibAUC 库,将 AI 文本检测带入了一个全新的视角:深度 X-risk 优化。作者证明了,比起常规的交叉熵损失,直接优化 AUC 指标能让模型在面对分布外(OOD)数据和对抗改写时展现出更强的防御力。
背景定位:这是一项基于 SOTA 模型(DeBERTaV3)的工程优化式创新,它在现有的检测算法坐标系中,通过改进优化目标(Loss Function),成功刷新了多个主流数据集的成绩。
痛点深挖:为什么 AI 文本检测这么难?
目前的 AI 检测器在实验室环境下表现尚可,但在现实应用中往往落入三个陷阱:
- 数据失衡 (Imbalance):人类文章的获取成本远高于批量生成的 AI 文本,这导致训练集中人类样本往往是少数派。
- 领域漂移 (OOD):在一个法律文档集上训练的模型,去检测推特流(Tweets)时效率会断崖式下跌。
- 对抗改写 (Adversarial):哪怕是简单的 Paraphrasing 或像 DIPPER 这样的专业改写器,也能让大多数基于频次的检测器彻底失效。
方法论详解:AUC 最大化的物理直觉
作者并没有盲目更改 Transformer 的内部结构,而是将重点放在了“如何训练”上。
LibAUC 的核心介入
LibAUC 允许开发者直接在 PyTorch 中使用 MultiLabelAUCMLoss。与传统的二元交叉熵(BCE)相比,AUC 优化旨在拉大正负样本得分之间的“间隔(Margin)”。
架构关键点:
- DeBERTaV3-large:利用解耦注意力(Disentangled Attention)机制,赋予模型更强的语义捕捉能力。
- PESG 优化器:这是一种针对 AUC 设计的随机近端梯度下降变体,特别适合深度学习中的大规模 X-risk 优化。
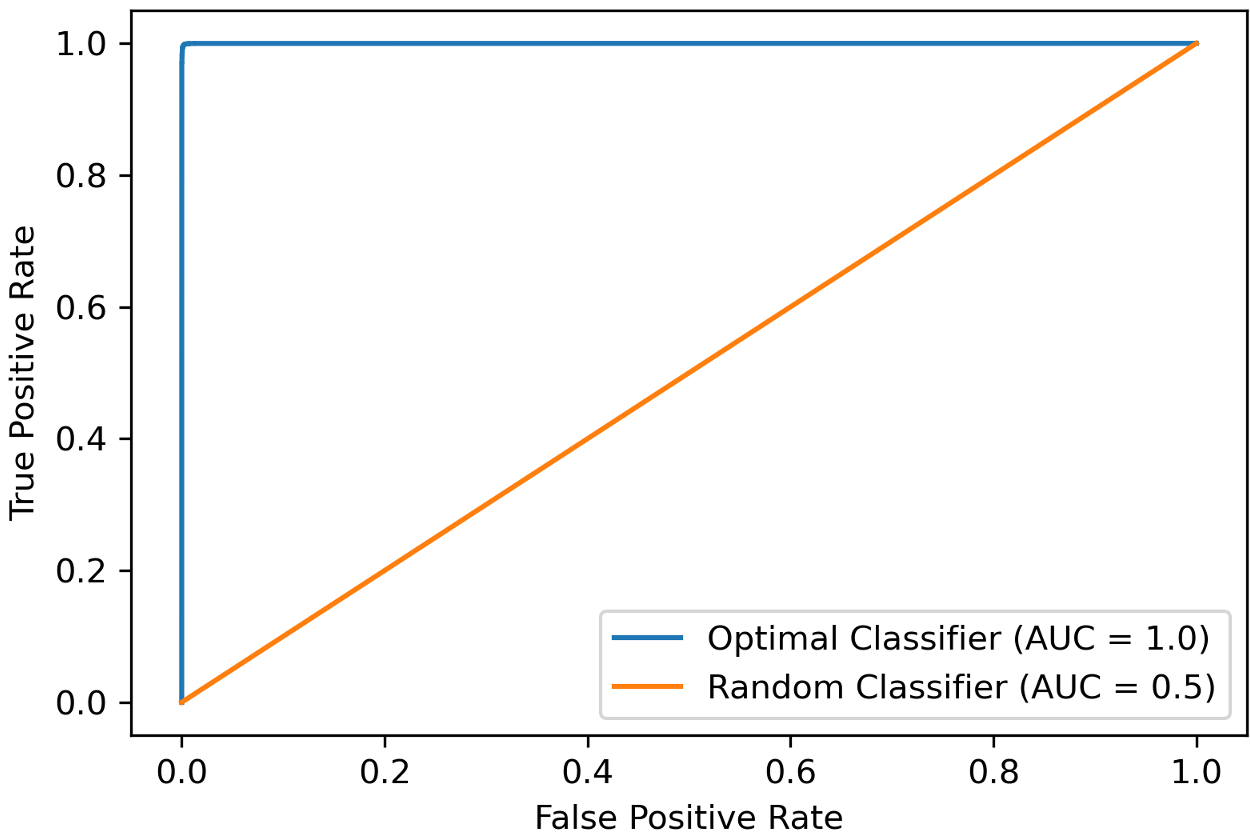
实验与结果:硬核战绩对比
作者在四个不同维度的数据集上进行了高强度压力测试。
1. AuTexTification 排行榜霸榜
在包含 Wikipedia、Tweet 和法律文档的跨域测试中,LibAUC 训练的模型展现了惊人的泛化能力。
| 模型 + 优化方案 | Macro-F1 Score (OOD Test) |
|---|---|
| DeBERTaV3-large + LibAUC | 87.59 |
| TALN-UPF (此前最高分) | 80.91 |
| Transformer Baseline | 57.10 |
2. 对抗性改写测试 (OUTFOX)
即使是面对经过反馈循环精心构造的“攻击性 AI 文本”,DeBERTaV3-large + LibAUC 依然保持了极高的 F1 值(>97%),尤其是在识别经过 DIPPER 改写后的文本时,明显优于原始的 OUTFOX 检测器。
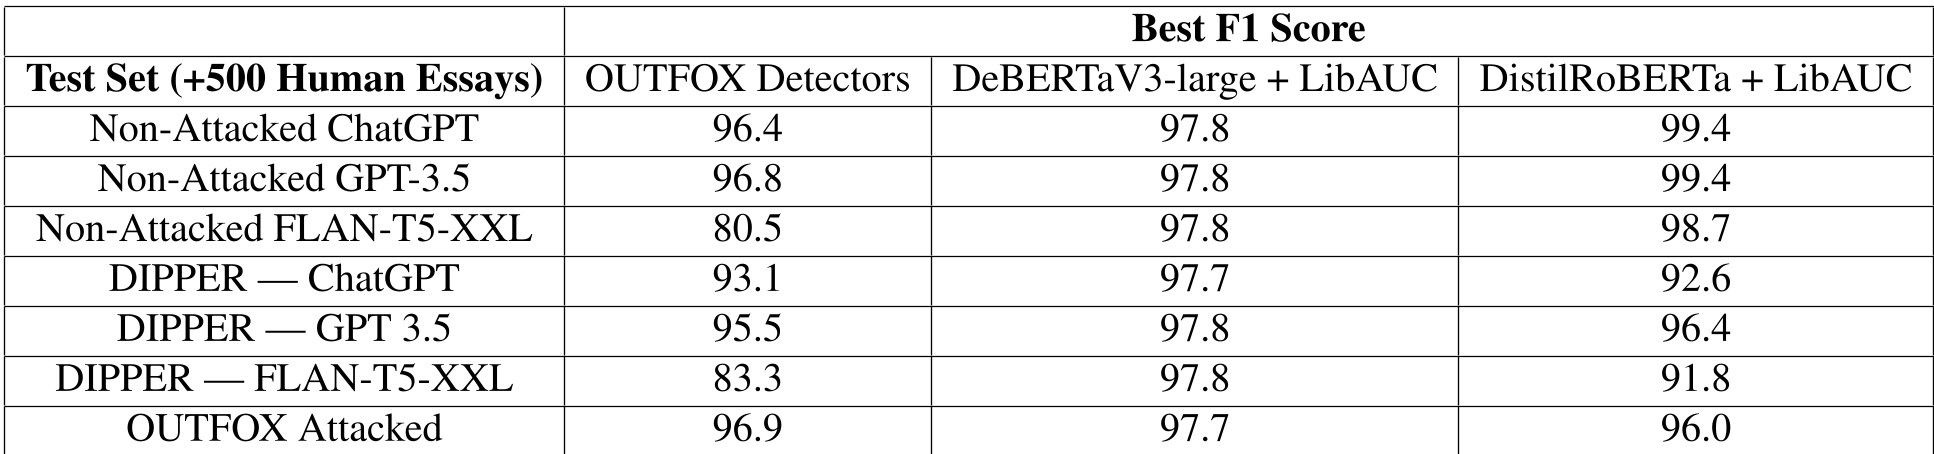
3. AWS Bedrock 真实环境下的大练兵
作者亲自构建了一个包含 Amazon Titan、Claude、Llama 2 和 Mistral 的新数据集。实验揭示了一个有趣的现象:Amazon Titan Express/Lite 产生的文本最难被识别(AUC 仅 0.64 左右),而 Claude 生成的内容特征相对明显。
深度洞察与总结 (Critical Analysis)
Takeaway: 这篇文章最大的启示在于,AI 文本检测不应仅仅是特征工程的竞赛。通过在底层优化目标中引入 AUC 最大化,我们可以让模型在不知道“新领域长什么样”的情况下,依然能守住区分人类与机器的底线。
局限性 (Limitations):
- 误伤成本 (False Positive):在学术诚信场景中,低阈值的设定可能导致冤枉学生。实验显示模型有时会因为过于敏感而将带有拼写错误的人类文章判定为 AI。
- 算力瓶颈:强如 Llama 2 级别的巨量参数检测器在文中并未能完成训练,未来的轻量化检测仍是挑战。
展望: 随着 Google Gemma 等新模型的出现,攻防战将进入白热化。未来的检测器不仅要看“像不像机器”,更需要结合像 LibAUC 这样具备鲁棒性的统计框架来应对不断进化的生成算法。