
[Expert Review] AI 赋能科研:如何通过人工智能终结系统文献综述的“体力劳动”?
Artificial intelligence to automate the systematic review of scientific literature
2024-01-16
总结
问题
方法
结果
要点
摘要
本文对过去15年间利用人工智能(AI)自动化系统文献综述(SLR)的研究进行了全面综述。核心涵盖了34项主要研究,重点分析了机器学习(ML)和自然语言处理(NLP)在辅助筛选、数据提取及报告生成中的应用,并指出了当前该领域从半自动化向深度学习驱动转型的趋势。
TL;DR
系统文献综述(SLR)是科研中的“重体力活”。本文综述了 15 年来 AI 在该领域的进化史,指出以 SVM 和 主动学习 (Active Learning) 为核心的算法已能在执行阶段减少 80% 以上的初筛工作量,而未来的前沿则在于利用 深度学习 (Deep Learning) 自动生成综述报告。
背景定位
在学术研究的坐标系中,这篇由 de la Torre-López 等人发表的研究属于二次研究(Secondary Study)的综述。它不仅是工具的罗列,更是对 SLR 自动化这一年轻学科的理论框架构建。
痛点深挖:为何 SLR 难以完全自动化?
传统的文献综述面临三个核心挑战:
- 数据不平衡(Data Imbalance):候选库中有 90% 以上是干扰项。
- 冷启动难题:新研究领域缺乏标注好的训练集。
- 语义黑箱:传统关键词匹配无法理解研究动机与结论的深层逻辑。
方法论详解:AI 如何介入 SLR 全生命周期
文章将自动化过程划分为三个关键阶段,并解构了其背后的技术逻辑:
1. 规划阶段 (Planning)
- 核心技术:聚类 (Clustering) 与 过程挖掘 (Process Mining)。
- 直觉:利用无监督学习(如 Lingo3G 算法)对尚未标记的领域进行“测绘”,帮助研究者快速界定研究边界。
2. 执行阶段 (Conducting) —— 研究重灾区
这是 AI 渗透率最高的部分(59% 的相关研究集中于此)。
- 主动学习 (Active Learning):通过人类作为“先知 (Oracle)”对极少数样本打标签,由模型(通常是 SVM)进行标签传播。
- 架构直觉:利用 TF-IDF 对标题和摘要进行特征化,建立高维向量空间。
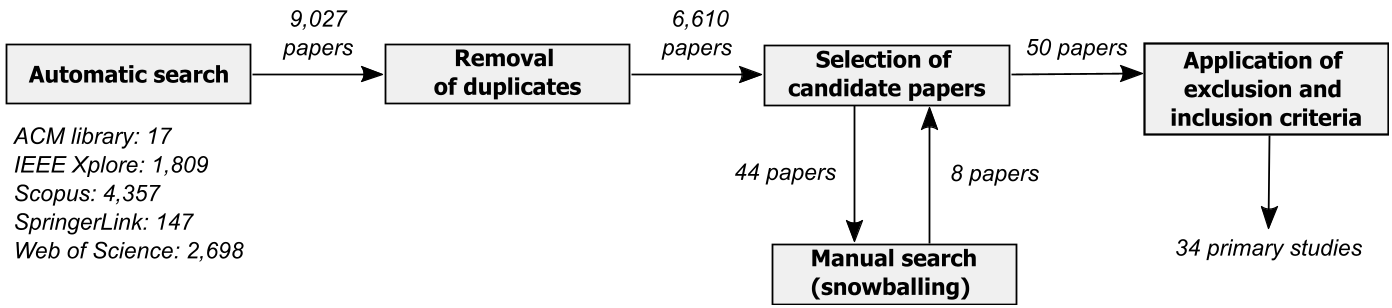 图 1:系统综述的自动化方法论步骤
3. 报告阶段 (Reporting)
- 新方向:利用 BioBERT 编码语义,并通过 LSTM 生成论文摘要。这标志着 AI 从“过滤器”向“写作者”的身份转变。
实验与结果:效率的量化提升
作者对比了多个主流工具的实战表现:
- 分类精度:SVM 在处理高维词袋模型(BoW)时表现出极强的鲁棒性。
- 工作量削减:对比实验显示,使用基于主动学习的 FAST2 工具,研究者只需阅读原库中 10% 的文献,即可覆盖 95% 的核心论文。
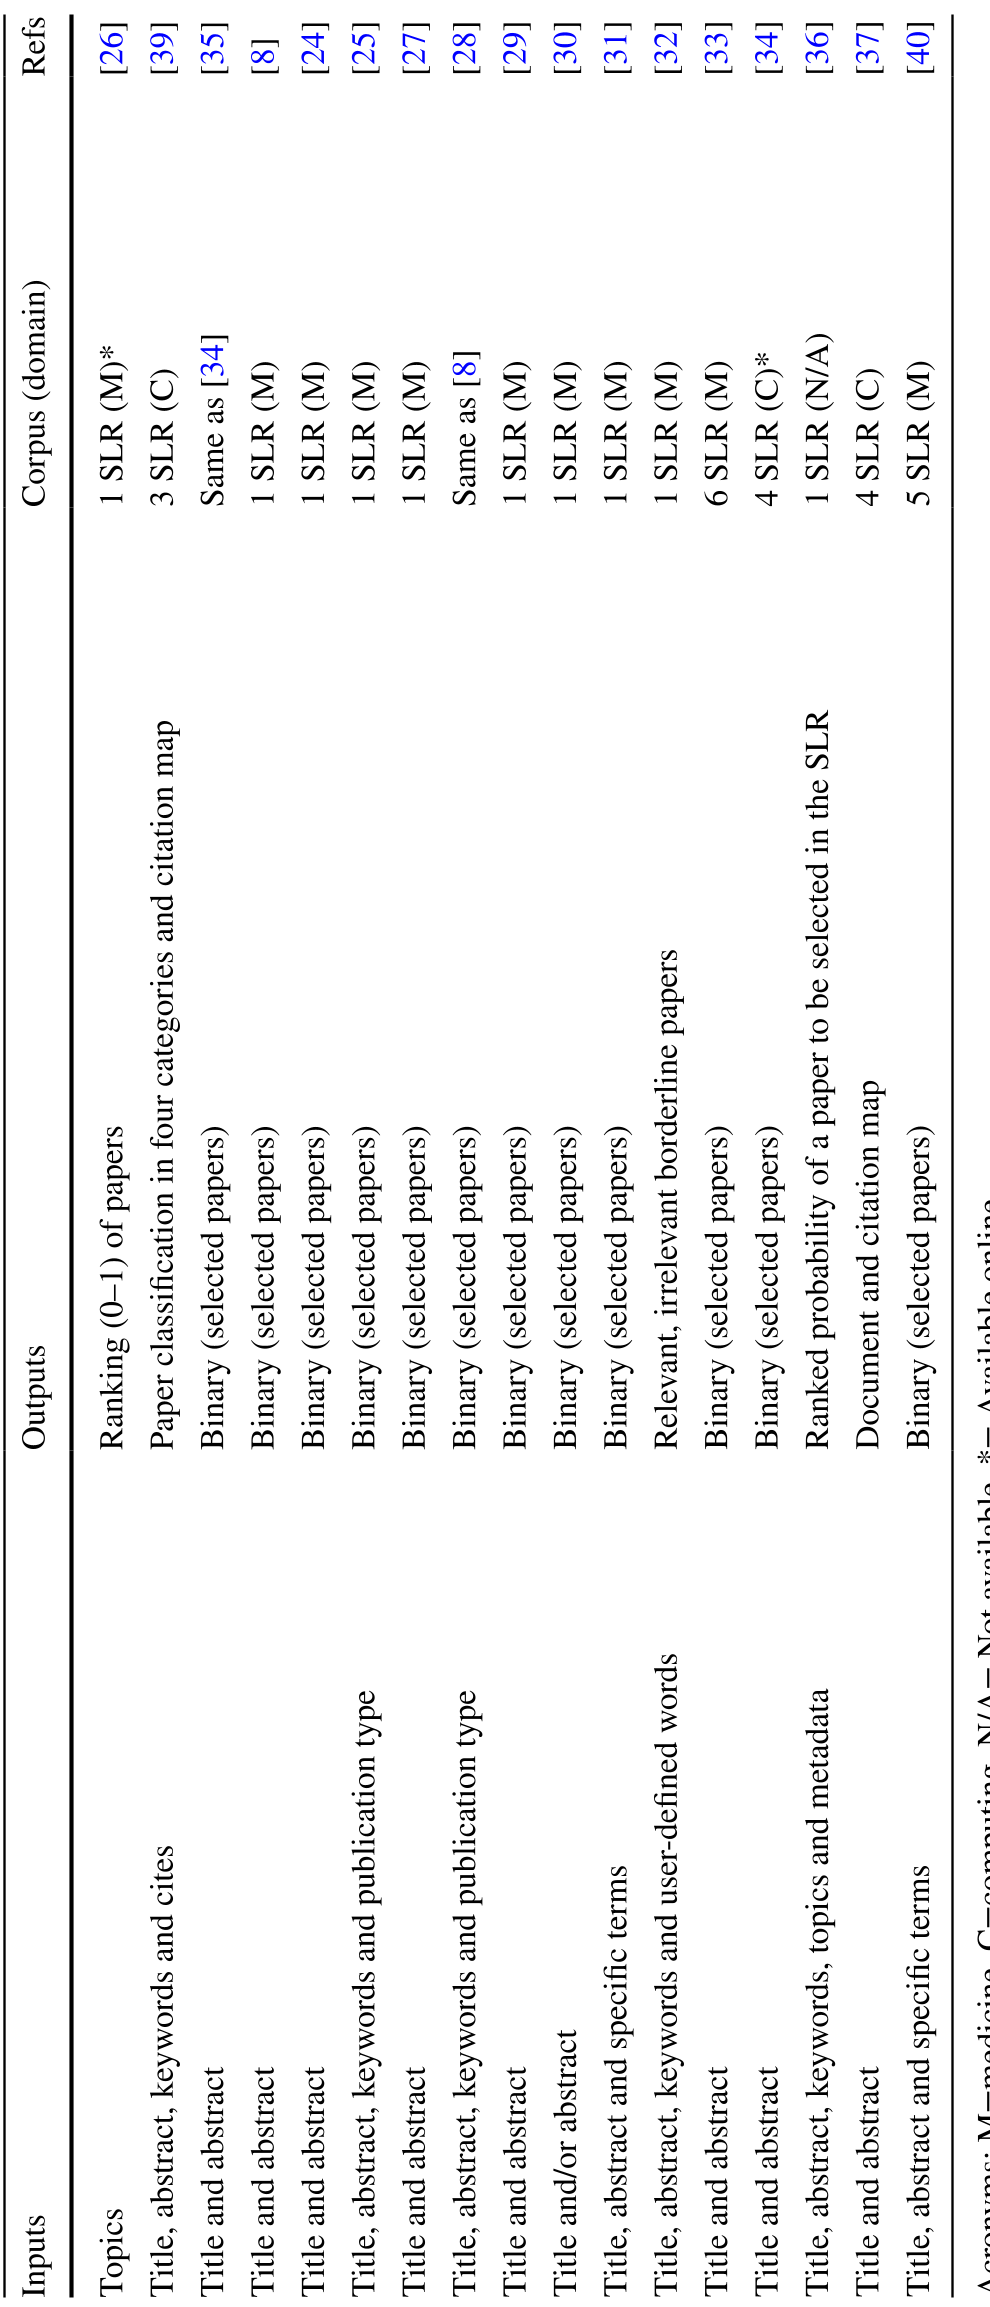 表 1:各 AI 方法在不同 SLR 任务中的输入输出与性能分布
深度洞察:未来的变局
- 从黑盒到可解释性:单纯的“推荐”已不够,研究者需要知道 AI 为什么 认为这篇文章相关(Explainable AI)。
- 超越标题摘要:目前的 AI 大多只看“皮毛”。未来的核心竞争力在于对全文逻辑的深入解析。
- 大语言模型的降维打击:虽然本文发表于 LLM 爆发前夕,但其预测的“自动写作”正通过 GPT 等模型快速变现。
总结
SLR 自动化不应追求完全脱离人类的“无人驾驶”,而应当是增强智能 (Augmented Intelligence)。未来的科研人员将扮演“总编辑”的角色,而 AI 则是最勤恳、永不疲倦的“初审编辑”。
局限性提示:目前的工具对新兴跨学科术语的敏感度依然不足,且大部分研究代码未开源,实验可重复性挑战依然巨大。