
AutoResearchBench:当顶级 LLM 遇上科研检索,胜率竟然不足 10%?
AutoResearchBench: Benchmarking AI Agents on Complex Scientific Literature Discovery
本文推出了 AutoResearchBench,一个专门用于评估 AI Agent 自动科学文献检索能力的深度基准测试。该基准包含 Deep Research(精准追踪目标论文)和 Wide Research(全面收集符合条件的论文集)两种任务,涵盖了计算机科学的 8 个核心领域。
TL;DR
在通用网页浏览和信息搜集任务中,GPT-4 等模型已经能取得 80% 以上的优异成绩。然而,由 AutoResearchBench 团队最新发布的基准测试显示,一旦进入“硬核”科学文献检索领域,强如 Claude-Opus 和 Gemini-3.1-Pro 的准确率竟然跌破了 10%。这意味着,我们距离真正的“AI 科学家”还有巨大的鸿沟。
背景定位
目前学术界都在炒作“自动化学术研究”(Autonomous Scientific Research),但所有研究的基石——文献综述与证据发现,却一直缺乏一个严谨的评估尺度。AutoResearchBench 的出现,填补了这一空白。它不是简单的关键词检索测试,而是一个考察 Agent 能否像人类博士生一样,在数百万篇论文中通过蛛丝马迹追踪到特定研究、并确保搜索“不重不漏”的深度考核。
痛点深挖:为什么搜索学术论文这么难?
作者指出,现有的 AI Agent 在面对学术检索时有三大死穴:
- 证据隐蔽性:关键信息不再标题或摘要里,而是在消融实验的表格、图表的注脚,甚至是论文附录的证明过程中。
- 约束复杂化:科研问题通常是多个技术约束的交集(例如:用了 A 算法、在 B 数据集上实验、且使用了 C 这种特定的正则化项)。
- 开放性终点:Agent 很难判断什么时候该停止搜索。是没搜到?还是真的不存在符合条件的论文?
方法论详解:如何考倒最聪明的 AI?
为了防止 Agent 走捷径,AutoResearchBench 采用了**全文优先(Full-text-first)**的构建逻辑:
- Deep Research(深度溯源):通过混淆和模糊化处理,将关键词过滤掉,迫使模型进行多跳引用推理。如果 Agent 不能读懂全文,根本无法定位到唯一的金标论文。
- Wide Research(广度覆盖):要求模型找全所有符合条件的论文。这对模型的召回率(Recall)和过滤精度(Precision)提出了极高要求。
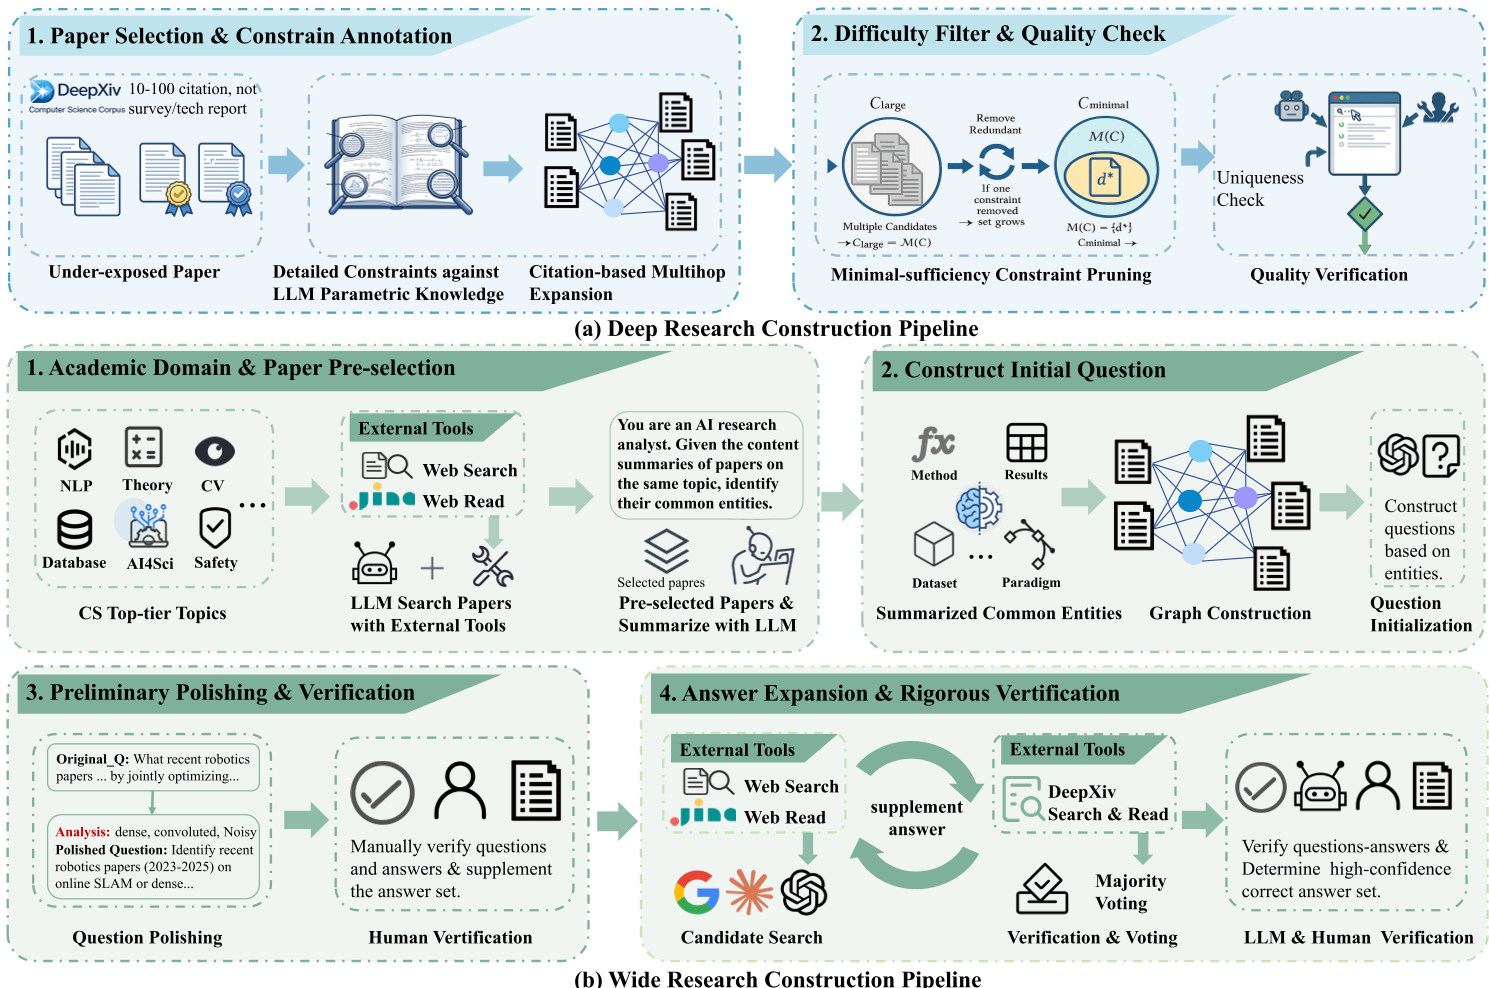 图 1:AutoResearchBench 的构建流程,包含目标论文选择、约束挖掘、模糊化及人工验证。
实验与结果:全线溃败的现状
实验结果令人震惊。即使是针对 Research 场景优化的模型,其表现也乏善可陈:
- 精度上限极低:在 Deep Research 任务中,表现最好的 Claude-Opus 只有 9.39% 的准确率。
- 暴力增加 Token 没用:增加模型思考的时间(Think Mode)和对话轮数,并不能直接提升性能。很多时候,模型只是在无效的检索路径上“鬼打墙”。
- 工具利用率低下:模型经常在复杂的检索语法上出错,或者无法将搜索到的零散证据聚合成最终结论。
 表 1:各大主流模型在 Deep 和 Wide 任务上的表现,得分普遍在个位数。
深度洞察:我们学到了什么?
这份报告揭示了一个残酷的现实:当前的 LLM 缺乏真正的“科学直觉”和“逻辑严密性”。
- 逻辑漂移:Agent 容易被相似但不相关的论文带偏(Retrieval Drift)。
- 过早放弃:在 Wide Research 中,很多模型搜到 1-2 篇相似论文后就草草收兵,严重缺乏对“完整集”的追求。
- 知识鸿沟:当涉及非常冷门或前沿的术语时,模型即便读到了案头上的证据,也无法识别出它就是答案。
总结
AutoResearchBench 的发布,标志着 AI Agent 评估从“常识阶段”迈向了“专业领域阶段”。对于那些致力于开发 AI Scientist 的团队来说,这不再是一个可选的测试集,而是一个必须跨越的“恐怖谷”。未来的突破点可能在于更强大的长文本推理架构以及更具逻辑性的 Agent 搜索策略。