
[Nature 水平] BAPO:突破离策强化学习瓶颈,让 32B 模型推理力超越 o3-mini
BAPO: Stabilizing Off-Policy Reinforcement Learning for LLMs via Balanced Policy Optimization with Adaptive Clipping
本文提出了 BAPO,一种针对大语言模型(LLMs)强化学习的平衡策略优化方法。该方法通过 Adaptive Clipping 机制动态调整 PPO 目标函数的截断边界,有效解决了离策(Off-policy)训练下的不稳定性,在 AIME 2024/2025 竞赛数学基准测试中达到了 SOTA 水平。
TL;DR
强化学习(RL)已成为对齐和增强大语言模型(LLMs)推理能力的核心范式。然而,传统的 Off-policy RL 常因“数据陈旧”导致训练崩溃。复旦大学等机构的研究者发现,这是由于不平衡的优化梯度和截断机制对熵的抑制造成的。本文提出的 BAPO (BAlanced Policy Optimization) 通过动态调整截断边界,实现了极高效率的稳定训练。32B 模型在 AIME 2025 数学竞赛中不仅横扫开源界,更力压 OpenAI o3-mini 和 Gemini-2.5-Flash-Thinking。
背景定位
目前大模型强化学习通常依赖于 On-policy(在线)训练,但这种方式对基础设施要求极高且样本效率低下。Off-policy(离策)虽然能复用历史数据、显著提升效率,但在实践中极易导致模型“变笨”(熵崩溃)。BAPO 的出现,为利用陈旧数据稳定提升模型推理深度提供了一套严谨的数学框架和实操方案。
痛点深挖:为什么离策训练会“崩溃”?
作者通过深入研究发现,现有的 PPO 式目标函数在离策场景下存在两大硬伤:
- 梯度失衡(Imbalanced Optimization):负优势样本(Negative-advantage samples)往往在数量和梯度贡献上占据绝对统治地位。这不仅会抑制有用的行为,还会因为 log 项趋近负无穷而诱发梯度爆炸。
- 熵-截断法则(Entropy-Clip Rule):传统的对称截断区间(如 0.8 到 1.2)会系统性地过滤掉那些能增加策略熵的“低概率正样本”,同时保留了大量减少熵的更新。结果就是模型陷入过拟合的“死胡同”。
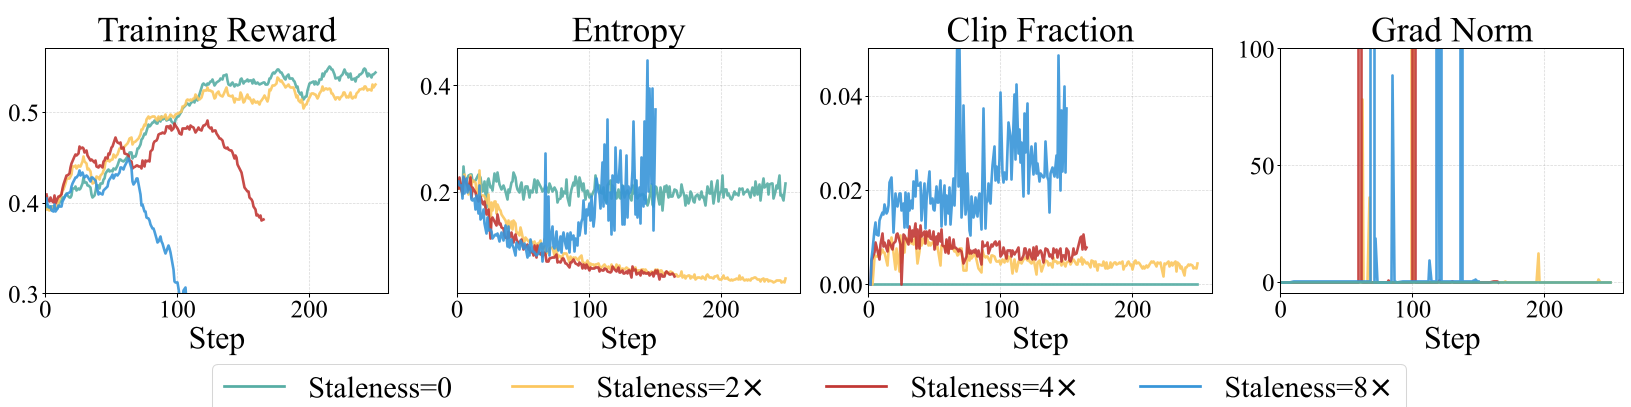 图 1:随着数据陈旧度(Staleness)增加,模型熵值急剧下降,训练最终崩溃。
核心方法论:BAPO 的自适应剪裁逻辑
BAPO 的核心直觉在于:既然固定的边界会扼杀熵,那就让边界跑起来。
1. 架构解析
BAPO 在 GRPO(Group Score Policy Optimization)的基础上引入了自适应机制。它每一步都会统计当前 Batch 中正负样本的贡献比例。如果正信号太弱,它会:
- 放宽上限 ():引入更多之前被截断的“低概率正样本”(增加熵)。
- 收紧/调整下限 ():过滤掉过度负面的贡献,防止梯度爆炸。
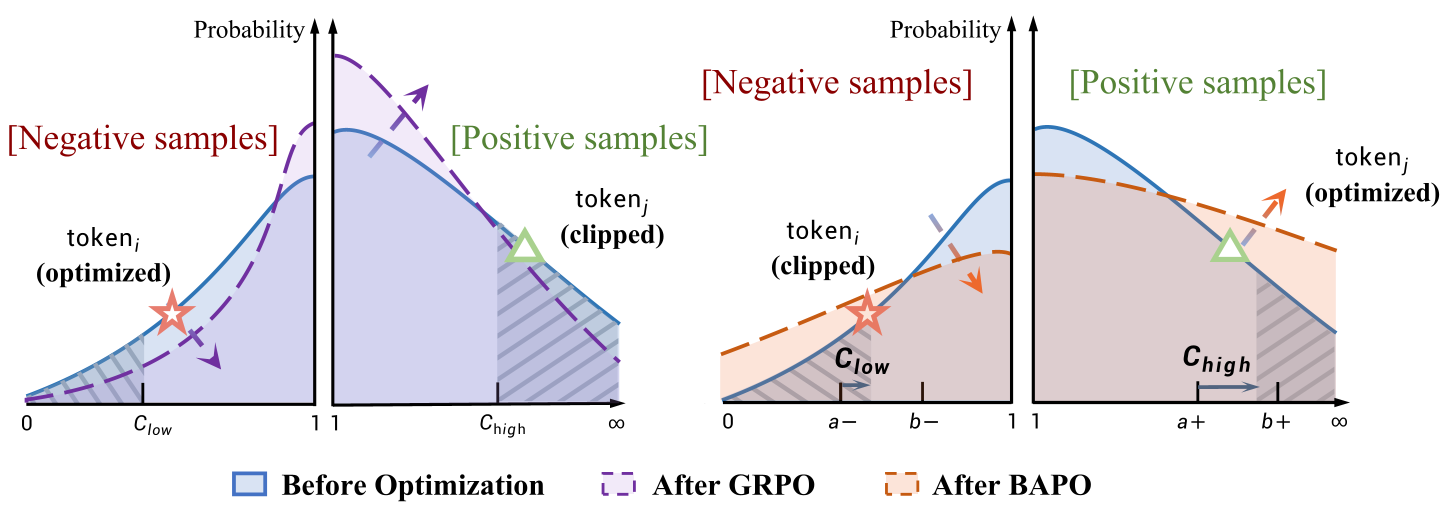 图 2:对比传统对称截断(左)与 BAPO 自适应截断(右)。BAPO 通过调节上下限,找回了被遗弃的熵增信号。
2. 数学背后的物理直觉
作者推导出的公式表明,策略熵的变化与“未截断样本的对数概率与优势值的协方差”正相关。这意味着,我们要想维持模型的“聪明度”(探索欲),必须保护那些具备正向提升潜力但当前概率尚低的 Token。
实验与结果:超越闭源巨头的表现
在最具含金量的美国数学邀请赛(AIME)基准测试中,BAPO 展现了恐怖的爆发力:
- SOTA 战绩:BP-Math-32B 在 AIME 2025 上达到 80.0 分,远超 DeepSeek-R1 (70.0) 和 Qwen3-32B (72.9)。
- 跨越规模的降维打击:7B 规模的 BAPO 模型成绩竟然与 32B 的顶级闭源模型 Gemini-2.0-Flash-Thinking 持平。
- 消融实验验证:实验显示,即使在“Partial Rollout”(部分采样复用)等极其不稳定的离策环境下,BAPO 依然能保持稳健的奖励增长和稳定的梯度。
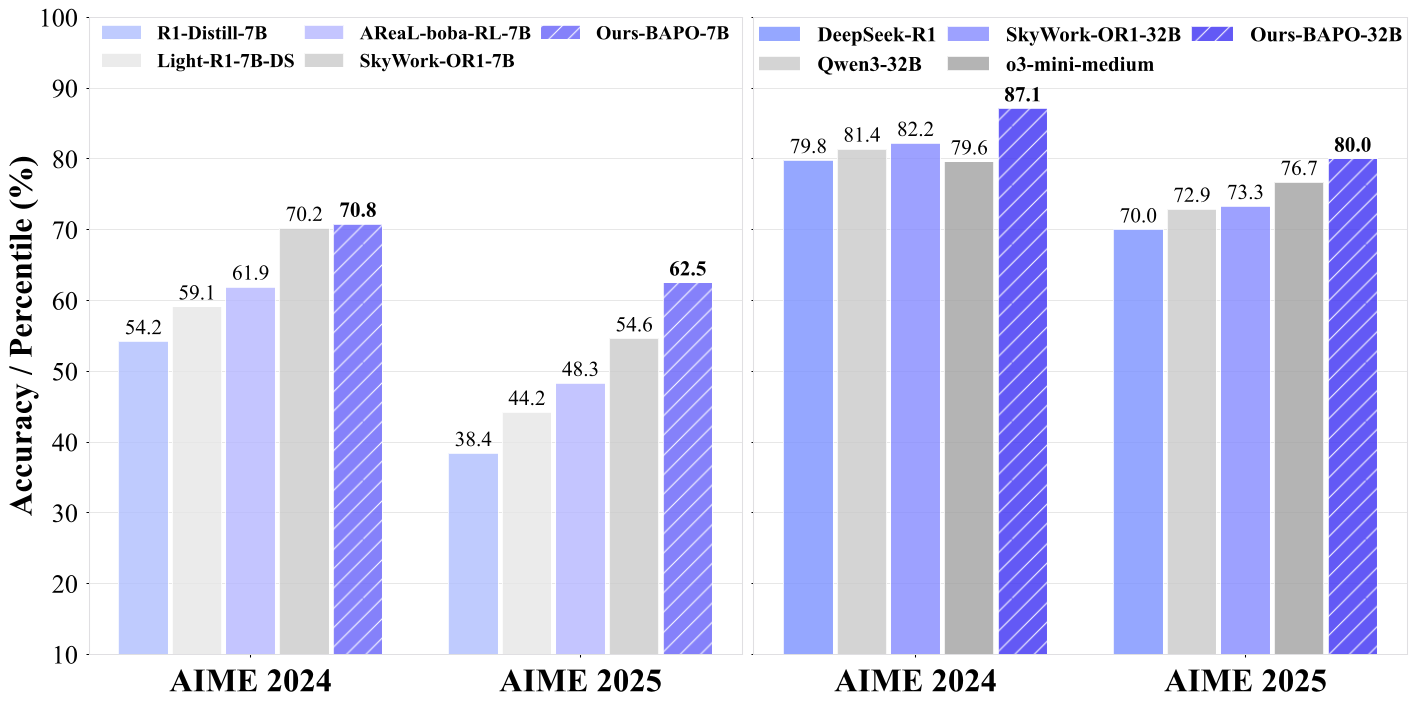 图 3:BAPO 在不同规模下的卓越表现。
深度洞察:RL 的未来在“自适应”
BAPO 的成功证明了:在 LLM 的大规模强化学习中,超参数的静态性是通往 AGI 的障碍。
过去我们习惯于手动调优 (截断系数),但模型在不同训练阶段、不同难度的问题下,其分布偏移是完全不同的。BAPO 这种基于目标贡献度()的自动化调整思路,不仅极大地减少了调参成本,更揭示了强化学习中“平衡”的本质——不是平均分配力量,而是动态地保护那些种子般的“正确直觉”(低概率正样本)。
总结
BAPO 为离策 RL 的稳定性提供了一个优雅的理论解释和易于实现的算法改进。它让中等规模模型(32B)通过高质量的强化训练,具备了挑战甚至超越顶级商用模型的能力,是推理模型进化的重要里程碑。
关键词: LLM RL, BAPO, Off-policy, AIME 2025, Adaptive Clipping, 熵坍塌