
BoostDream:分钟级打造高质量 Text-to-3D,多视图蒸馏告别“多头怪”
BoostDream: Efficient Refining for High-Quality Text-to-3D Generation from Multi-View Diffusion
本文提出了 BoostDream,一种高效的“插拔式”3D 资产优化方法。通过将前向生成模型的高速度与多视图 Score Distillation Sampling (SDS) 的高质量结合,在保持极快推理速度的同时,显著提升了 Text-to-3D 生成的精细度,并有效解决了 Janus(多头)问题。
TL;DR
在 3D 生成领域,速度与质量似乎总是一对“鱼和熊掌”。BoostDream 通过一种精妙的三阶段优化框架,将粗糙的 3D 模型作为起点,利用多视图一致的扩散模型进行精炼。它不仅在 30 分钟左右完成了传统方法一小时的工作,更通过引入 Multi-view SDS 彻底缓解了困扰 3D 领域的 Janus (多头) 问题。
背景定位:3D 生成的两条鸿沟
目前 Text-to-3D 社区被两大流派割裂:
- 前向生成派 (Feed-forward):以 Shap-E 为代表,主打“秒出”,但模型往往“糊成一团”,分辨率极低。
- 优化提炼派 (SDS-based):以 DreamFusion 为代表,通过不断迭代提升质量,但慢得惊人,且由于缺乏全局空间感知,经常生成具有多个头、多条腿的“怪物”。
BoostDream 的动机非常直观:能不能用前向生成的粗模型做“骨架”,再用优化方法做“整容”?
核心机制:三阶段“整容”流水线
BoostDream 的流程被设计为三个逻辑紧密的阶段:
1. 快速初始化 (Initialization)
系统首先利用 Shap-E 等模型生成一个粗糙的 3D 物体。为了让它具备可优化性,BoostDream 使用 L1 Loss 将这个显式 3D 模型“蒸馏”到可微渲染表示中(如 NeRF 或 3D Gaussian Splatting)。
2. 多视图引导提升 (Boost Stage)
这是本文最核心的创新。作者设计了一个 Multi-view Render System,在每次迭代中同时渲染四个正交视角的子图,并拼接成一张大的 2x2 图像。
- 关键点:文章不仅使用文本 Prompt,还利用了粗模导出的 Normal Maps (法线贴图) 作为 ControlNet 的输入。这意味着扩散模型在优化时,不仅在“猜”这里应该是什么颜色,还被明确告知了基本的几何走向。
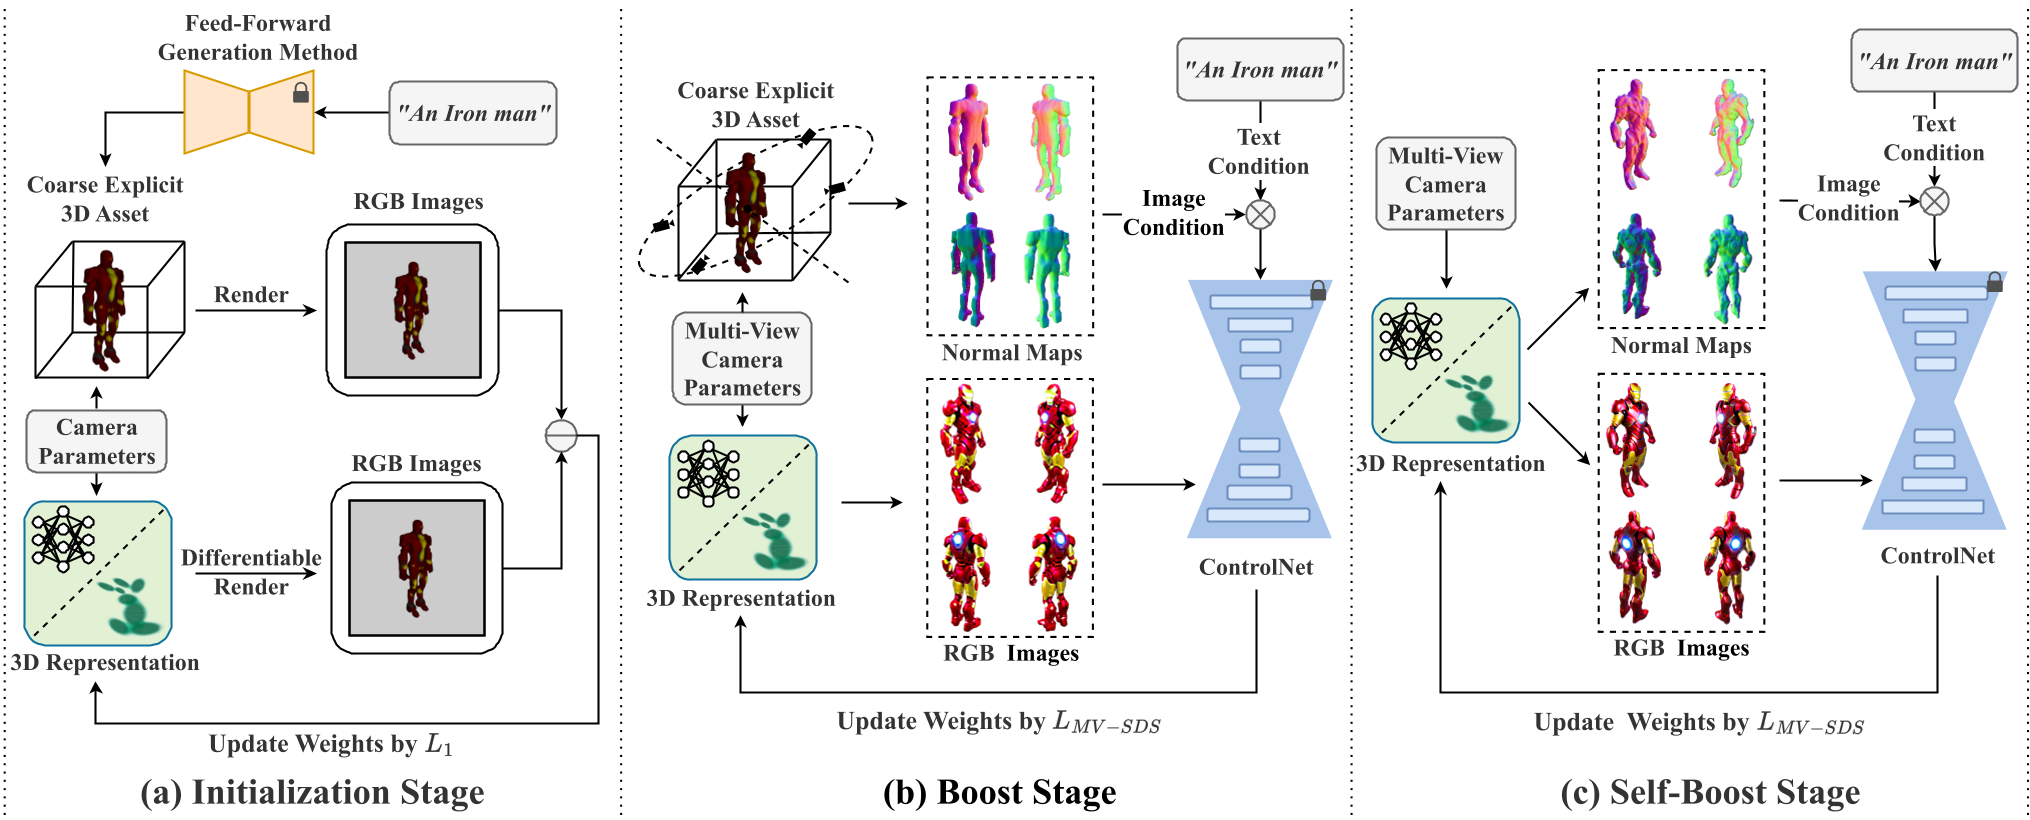 图 1: BoostDream 三阶段框架概览。从粗糙初始化到多视图正规化偏移,再到最后的细节自提升。
3. 自我提升阶段 (Self-boost Stage)
当模型已经长出基本样子后,引导条件从最初的“粗模法线图”切换为“由当前优化模型生成的渲染法线图”。这种自我监督机制允许模型突破初始资产的限制,长出更精细的纹理和褶皱。
核心技术:Multi-view SDS Loss
传统的 SDS Loss 是视角独立的,这导致了 Janus 问题。BoostDream 通过将四个视角合成一帧进行处理,并在计算梯度时使用 Dual-conditioned 机理(文本 + 视图一致的 Normal Maps),强制要求生成的像素在空间上能够闭合。
其梯度公式定义如下:
abla_{ heta} \mathcal{L}_{MV-SDS} = \mathbb{E}_{t, \epsilon} \left[ w(t) (\hat{\epsilon}_{\phi}(x_{t}; t, y, N) - \epsilon) \frac{\partial G}{\partial heta} \right]$$ 其中 $N$ 即为多视图拼接的法线图,它作为一种强约束,保证了优化过程不会偏离合理的几何结构。 ## 实验与结果对比 在针对 NeRF, DMTet 和 3D Gaussian Splatting 的各类 3D 表示实验中,BoostDream 展现了极强的泛用性。 * **效率对比**:在 V100 上,其完成时间缩短至 2038s,而 DreamFusion 需要 3519s。 * **质量对比**:通过图 4 可以清晰看到,面对“高达”、“战马”等复杂 prompt,对比方法大面积出现了肢体错乱,而 BoostDream 生成的结构极其稳定。 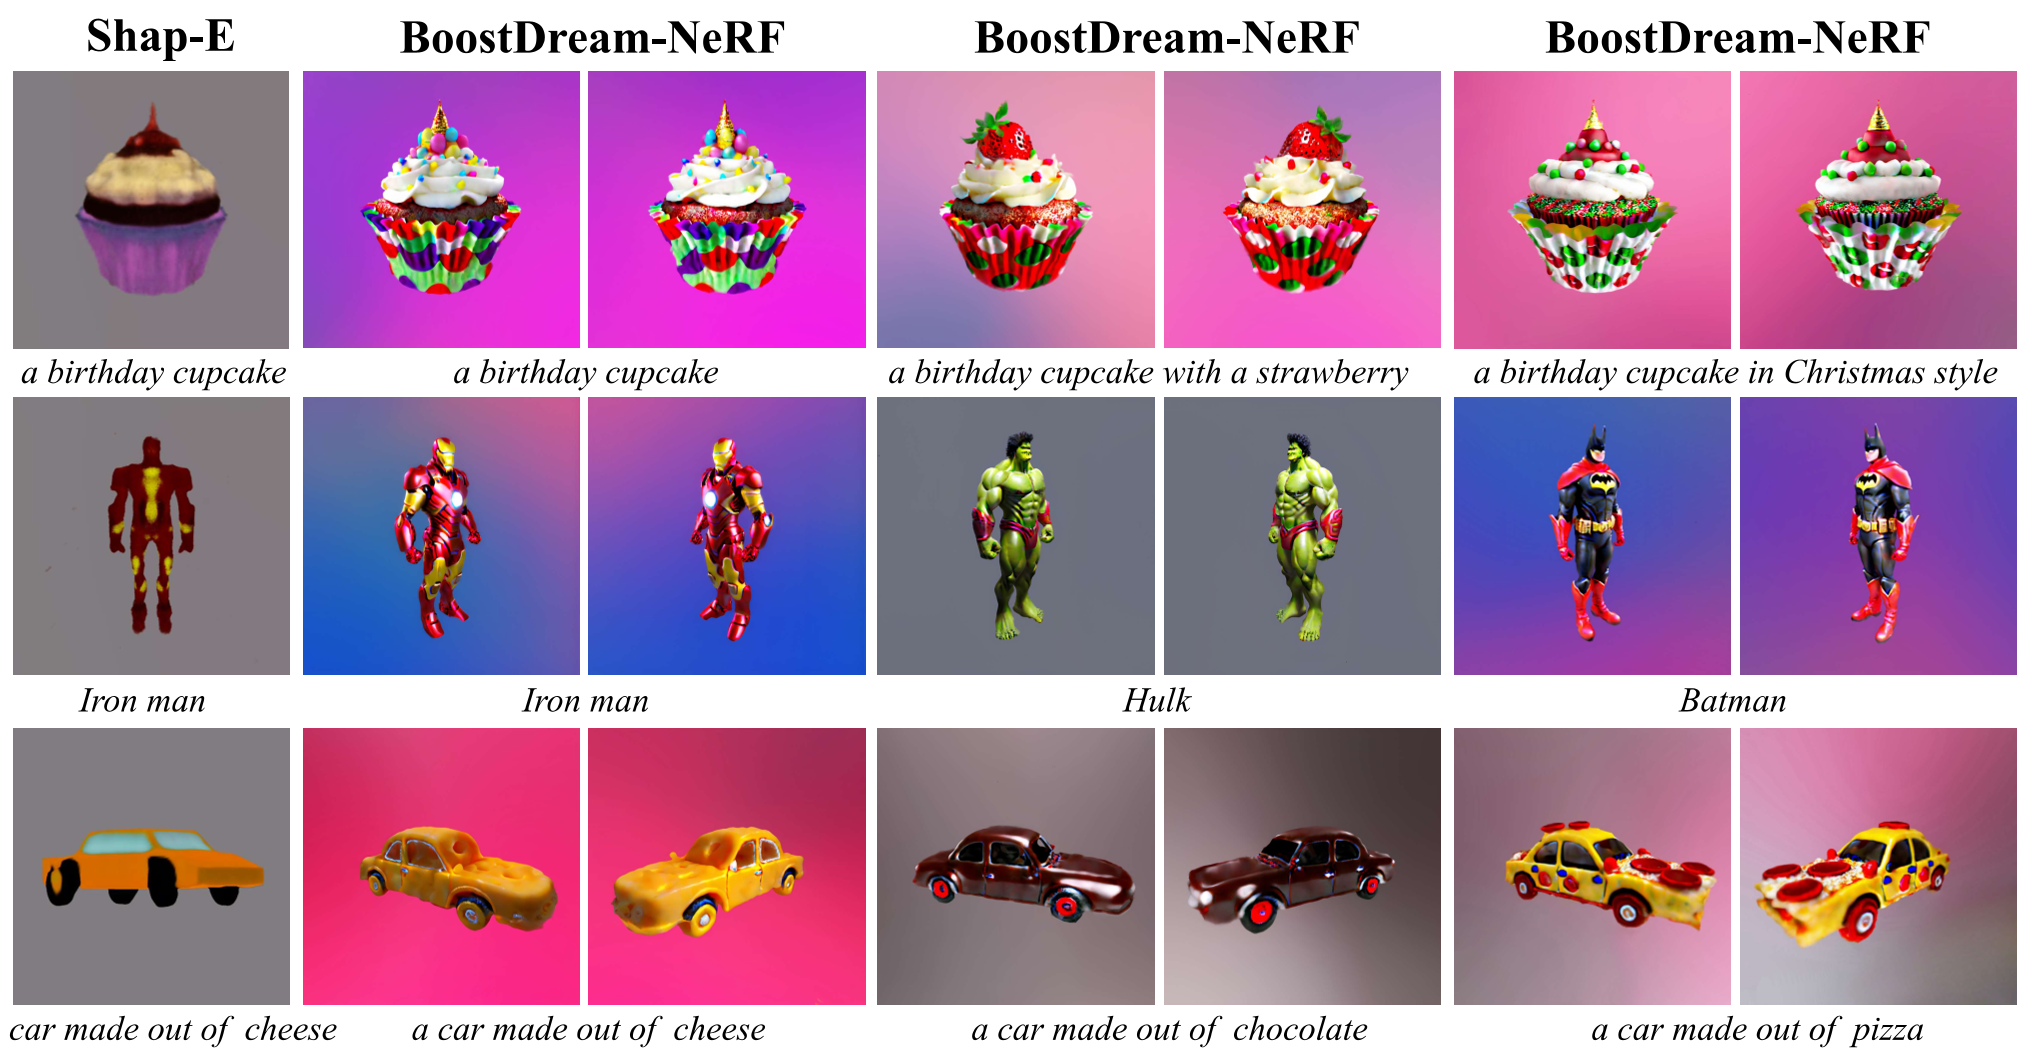 *图 2: 与 Shap-E, DreamFusion, Magic3D 的对比。BoostDream 在保持几何结构一致性的同时,纹理锐度更高。* ## 深度洞察与总结 ### 为什么法线贴图 (Normal Map) 优于 深度图 (Depth Map)? 在消融实验中,作者发现使用 Canny 边缘或深度图的效果均不如法线图。**物理直觉是**:深度图虽然描述了宏观轮廓,但对微观表面起伏(如蝙蝠侠铠甲的纹路、动物毛发)的表达极弱,而法线图能够捕捉到表面的微小偏转,这正是“高质量”纹理的来源。 ### 局限性 尽管解决了多头问题,但由于使用了 2D 扩散模型(如 Stable Diffusion 1.5),它仍可能继承 2D 模型的一些偏见或伦理局限。此外,该方法高度依赖初始粗模的质量——如果第一阶段生成的形状过于离谱,后续优化也难起死回生。 ### 结语 BoostDream 证明了:**2D 图像生成的强大能力可以通过多视图对齐这种“几何桥梁”高效迁移到 3D 领域**。这为 VR 和游戏行业提供了一个极具潜力的资产自动化生成工具。