
从 RLHF 到 RLAIF:Constitutional AI 如何重塑大模型对齐范式
c9f40df2-07ab-4304-90d1-15a6097288b3 (1)
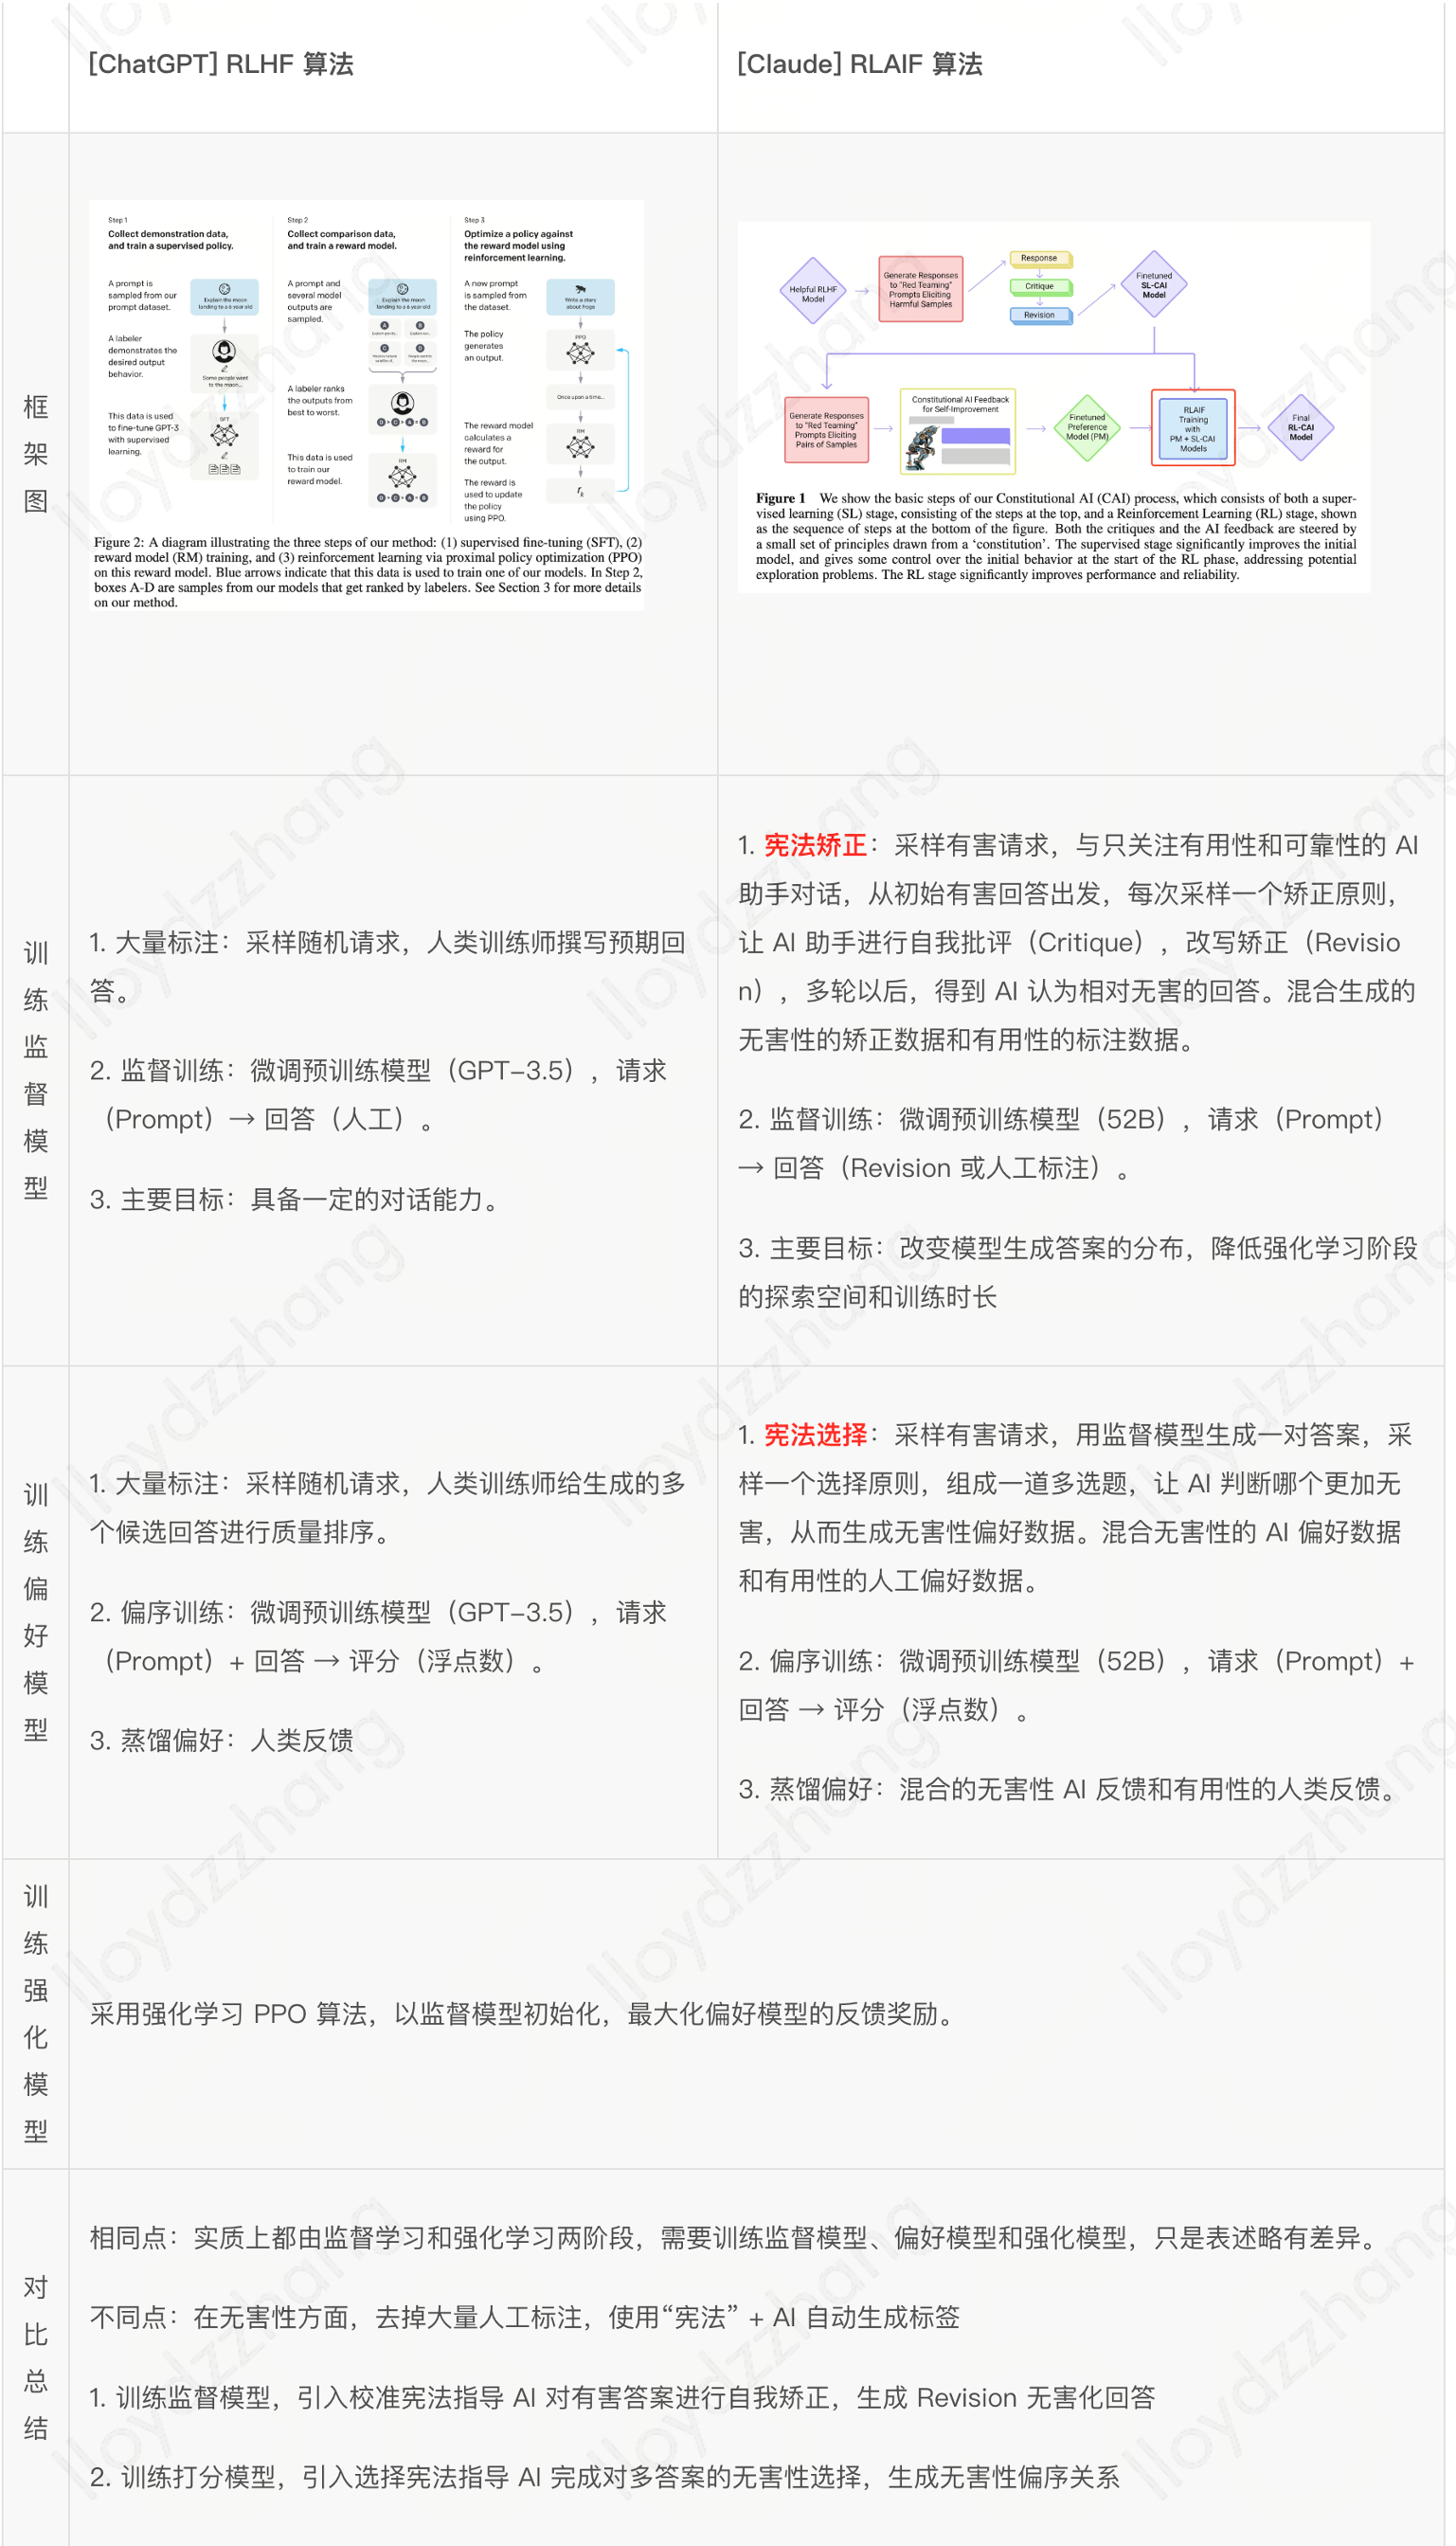
本文通过对比分析了以 ChatGPT 为代表的 RLHF(基于人类反馈的强化学习)与以 Claude 为代表的 RLAIF(基于 AI 反馈的强化学习,即 Constitutional AI)的技术路线。核心结论在于:通过引入“宪法”(Constitution)引导 AI 进行自我修正与偏好标注,可在显著减少人工标注依赖的同时,实现模型安全性和有用性的 Pareto 提升。
TL;DR
在大型语言模型(LLM)的对齐竞赛中,ChatGPT(OpenAI)与 Claude(Anthropic)分别代表了两种不同的演进路径。本文深度解析了从 RLHF(人类反馈)向 RLAIF(AI 反馈,又称 Constitutional AI)演进的技术逻辑。核心发现是:通过让模型遵循一套“宪法”进行自我判别,我们可以实现在更低人工干预下,获得更安全、更博学的 AI。
核心定位
本研究在 LLM 工业界坐标系中属于方法论革命。它不仅是性能的“刷榜”,更是对对齐效率(Alignment Efficiency)的重构。相比于 OpenAI 早期重度依赖人工标注的逻辑,Anthropic 提出的 CAI 架构成功地将 AI 从“被动接受指令”转变为“基于原则的自我约束者”。
痛点深挖:人工标注的瓶颈
在传统的 RLHF 流程中,我们面临三个致命缺陷:
- 可扩展性(Scalability):随着模型能力增强,人类标注者很难在短时间内判断出长文本或复杂逻辑中的细微有害信息。
- 成本管理:高质量的“红队测试(Red Teaming)”人工成本极高。
- 一致性:不同文化背景的标注者对“无害性”的解读存在天然差异。
方法论详解:Constitutional AI 的双螺旋结构
CAI 的核心在于将对齐分为两个透明的阶段,将人类的价值观抽象为一套**“宪法原则”**。
1. 监督学习阶段 (SL-CAI):自我改写
模型首先生成原始回复(可能带有有害倾向)。然后,系统通过 Prompt 提示模型:“请根据原则 X 批评你的回复并进行修正。”
- Critique:AI 指出回复中不符合宪法原则的地方。
- Revision:AI 生成一个更加温和、有用且安全的版本。 最终,使用这些 Revision 后的数据对预训练模型进行微调。
2. 强化学习阶段 (RL-CAI/RLAIF):AI 偏好实验
在这一阶段,我们不再需要人类去排队打分。
- 采样一个请求,生成一对答案。
- 让一个“反馈模型”根据宪法原则,判定 A 还是 B 更好。
- 利用这些 AI 自动生成的偏好数据训练 Reward Model (RM),最后通过 PPO 算法进行大规模强化学习。
实验与结果:Pareto 改进
实验结果证明了 CAI 的强大优势。在 Helpfulness Elo vs. Harmlessness Elo 的对比图中(见下方),RL-CAI 模型相较于传统 RLHF 展现了明显的 Pareto 改进。
- 关键结论:原本模型在提升“有用性”时往往会牺牲“无害性”,但引入 RLAIF 和思维链(CoT)后,模型能在保持极高知识产出的同时,将有害性降至接近于零。
- 量化提升:在相同的 Helpfulness 等级下,RL-CAI 的无害性指标提升了约 50 个 Elo 分位。
深度洞察:AI 监督 AI 的闭环
RLAIF 的本质是**“知识蒸馏”与“原则内化”。传统的 RLHF 是将人类的感性偏好蒸馏到模型中;而 RLAIF 是将人类的抽象原则(Constitution)**通过 AI 的逻辑推理能力内化到模型权重中。
局限性分析: 尽管 CAI 表现卓越,但它仍然高度依赖于起始“原则”的质量。如果提供的“宪法”本身存在偏见,AI 的自我修正可能会陷入另一种形式的偏执行为。此外,完全脱离人类反馈后的长期迭代是否存在“模型崩溃(Model Collapse)”风险,仍需更长周期的观察。
总结
Constitutional AI 证明了对齐不一定要靠“堆人头”。通过定义良好的顶层逻辑原则,LLM 具备极强的自我演化潜力。对于从业者而言,未来的关键不再是如何收集更多的标注数据,而是如何设计一套能够适应多变社会规则的“AI 宪法”。