
ChatGPT 正在重塑学术圈?100 万篇 arXiv 论文揭示的“词频真相”
Is ChatGPT Transforming Academics' Writing Style?
本文通过对 2018 年至 2024 年间 100 万篇 arXiv 论文摘要的词频统计分析,评估了 ChatGPT 对学术写作风格的影响。研究提出了一种基于仿真校准的统计模型,发现在计算机科学(CS)领域,约有 35% 的论文摘要呈现出显著的 LLM 写作风格,标志着 AI 已深度渗透学术出版。
TL;DR
通过对 2018-2024 年间百万级 arXiv 论文摘要的深度挖掘,研究人员发现了一个惊人的事实:自 ChatGPT 发布以来,学术论文的用词偏好发生了剧烈偏移。在计算机科学领域,超过 35% 的论文摘要已带有鲜明的“ChatGPT 风格”。
核心速览
本文是一篇揭示人工智能对科学共同体行为影响的实证研究。它不再纠结于“单篇论文是否为 AI 创作”的真假辩论,而是站在群体统计学的高度,通过追踪特定词汇(如 "significant", "is", "are")的使用波动,勾勒出 LLM 在学术界的渗透版图。
痛点与动机:检测器的失效与审美的同质化
传统的 AI 文本检测器正陷入“猫鼠游戏”的死胡同。由于作者往往只是让 ChatGPT “帮忙润色一下”,混合文本(Human-AI Mixture)的处理让二进制检测器心力交瘁。
作者由此产生了一个深刻的视角:我们可能无法 100% 确定某一篇论文是否用了 AI,但如果数以万计的论文突然集体偏爱某些词汇、冷落某些词汇,那一定有一种“隐形的力量”在重塑学者的写作习惯。
方法论详解:捕捉 LLM 的“指纹”
核心逻辑:从模拟到推断
作者并没有盲目寻找特征,而是通过一个三步走的策略:
- 基准建立:采集 2018 年至 2022 年(无 AI 干扰)的词频作为“自然语言”底色。
- 仿真模拟:使用 GPT-3.5 对历史摘要进行批量重写(Prompt: "Revise the following sentences"),观察哪些词的频率会“暴涨”(如形容词
significant)或“暴跌”(如连词is,are)。 - 影响力估算:建立 OLS(普通最小二乘法)回归模型,用真实数据集与模拟数据集的偏离度来计算
LLM Impact。
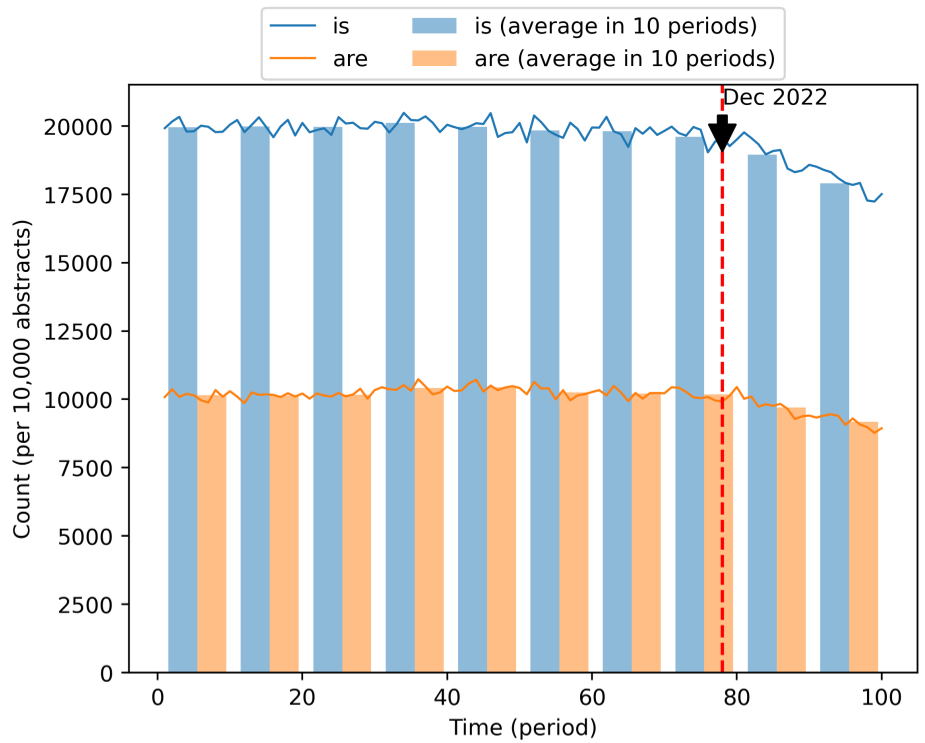 图中清晰展示了词汇 "is" 和 "are" 在 2023 年后的断崖式下跌,而某些形容词则显著上升。
噪声处理与自适应
为了排除“科研热点变化”导致的词频波动(例如论文中提到 "COVID-19" 变多并不是因为 AI),作者特意选取了非专业性的常用词汇,并引入了自适应机制,确保选取的词汇集合能最大程度过滤掉学科噪音。
实验与结果:CS 领跑,数学“定力强”
研究对不同学科进行了横向对比,结果非常耐人寻味:
- 计算机科学 (CS):AI 的绝对大本营,LLM 影响力估值高达 35.2%。
- 天体物理 (Astro) 与 凝聚态物理 (Cond-mat):处于中游,约在 10%-20% 之间。
- 数学 (Math):最为稳健,几乎看不到明显的 AI 侵蚀痕迹。这或许是因为数学写作对于逻辑严谨性的要求极高,目前 LLM 的润色往往难以触及核心公式层面的表达转换。
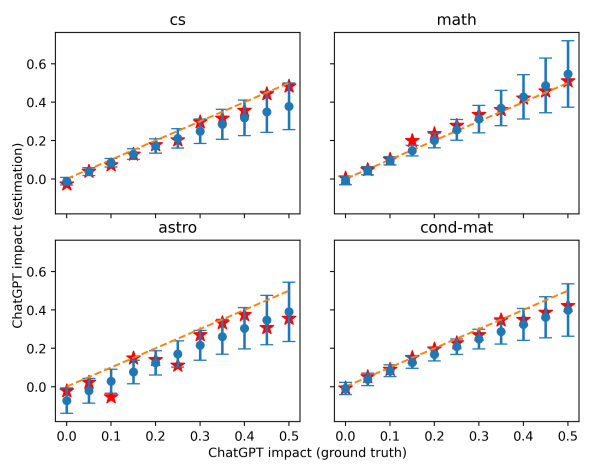 图表展示了各学科 ηj (t)(LLM 影响力)的时间趋势,CS 领域的斜率最为陡峭。
深度洞察:我们需要担心“学术同质化”吗?
洞察 1:非母语学者的福音
作者认为,LLM 在学术界是一种“伟大的平衡器”。对于非英语母语的学者,ChatGPT 大大降低了语言门槛,让他们能以更专业的姿态参与全球论文发表。这不仅是效率的提升,更是某种程度上的公平。
洞察 2:写作风格的坍缩
然而,副作用同样明显。如果全球 35% 的研究者都使用同样的工具进行润色,学术表达将走向严重的同质化(Homogenization)。那种各具特色的学术文风正在消失,取而代之的是极致平庸、充满“AI 范儿”的模板化表达。
局限性与未来
本研究主要基于摘要(Abstract),未来的研究可以铺开到全文、图表说明甚至是审稿意见中。作者也承认,随着 GPT-4 等更强模型的出现,其写作风格变得更加隐蔽,简单的词频分析可能需要结合更复杂的语义流模型。
总结
无论你是否接受,ChatGPT 已经事实性地参与了人类知识结晶的生产过程。正如 AlphaGo 改变了职业围棋的训练方式,LLM 正在完成对学术话语体系的“二次拓荒”。
关键词:LLM Impact, arXiv, 学术写作, 词频分析, ChatGPT.