
[金融科技] 结构化建模赋能长文生成:突破金融大模型的“上下文瓶颈”
Integrating context compression and structural representation in large language models for financial text generation
本文提出了一种结合上下文窗口压缩与结构感知建模的金融大语言模型框架,旨在解决金融长文本生成中的信息截断与逻辑丢失问题。该方法在 FinSum 数据集上取得了 SOTA 性能,ROUGE-L 指标显著优于 FinGPT 和 GraphRAG 等强基线模型。
TL;DR
在处理金融年报、审计报告等动辄万字的长文时,即使是强如 Llama 3 或 FinGPT 也会面临“顾头不顾尾”的尴尬。本文介绍了一种创新的方法:通过**上下文压缩(Context Compression)精炼信息,并结合结构感知模型(Structure-aware Modeling)**重构文档逻辑,在 FinSum 任务中实现了性能与稳定性的双重突破。
背景定位:这是一项针对金融垂直领域长文本处理的系统性优化工作,属于在 Transformer 架构上叠加“归纳偏置(Inductive Bias)”的实战型研究。
痛点深挖:金融文档的三大挑战
金融文本不同于文学作品或通用新闻,它具有极高的信息密度和显式结构:
- 窗口截断(Truncation):关键财务数据散落在文档末尾,一旦超出窗口上限就会丢失。
- 冗余干扰(Redundancy):合规性废话较多,容易稀释核心语义。
- 逻辑碎片化(Logical Fragmentation):传统自回归模型倾向于局部建模,难以理解跨段落的因果链条(如:前文的市场预测如何推导至后文的风险评估)。
核心方法论:压缩与结构的协同优化
1. 智能上下文压缩
作者不仅仅是简单截断,而是设计了一个 压缩函数。该函数利用注意力引导机制对句子进行评分: 通过保留得分最高的信息单元,将超长序列转换为 L 长度内的精炼表示,极大降低了推理过程中的计算压力。
2. 结构感知图表示(Structure-aware Graph)
这是本文的精华所在。作者将文档抽象为一个图 ,其中节点为句子/段落,边代表逻辑依赖。通过图注意机制(Graph Attention)进行状态更新:
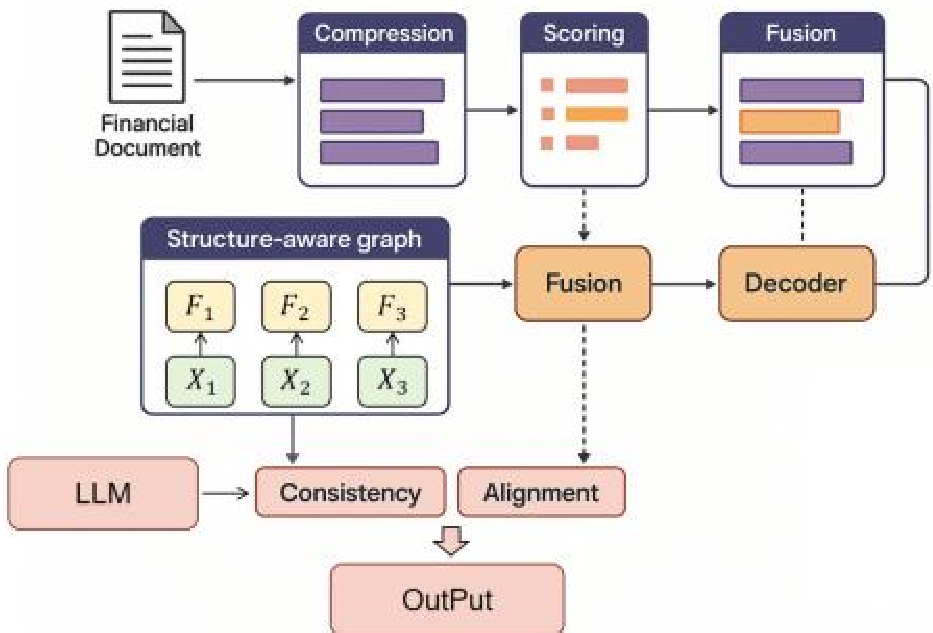 这种设计让解码器在生成每一句话时,不仅能看到“前文”,还能感知到整个文档的“逻辑骨架”。
实验与战果:全方位的 SOTA
在金融摘要数据集 FinSum 上的对比显示,该方法在 ROUGE 各项指标上均刷新了记录。
ROUGE 指标对比分析
| 模型 | ROUGE-1 | ROUGE-2 | ROUGE-L |
|---|---|---|---|
| FinGPT | 49.14 | 25.76 | 45.12 |
| Ours | 51.03 | 27.41 | 47.38 |
显著的 ROUGE-2 提升意味着模型生成的短语连续性极佳,克服了生成模型常有的“幻觉”和“逻辑跳跃”。
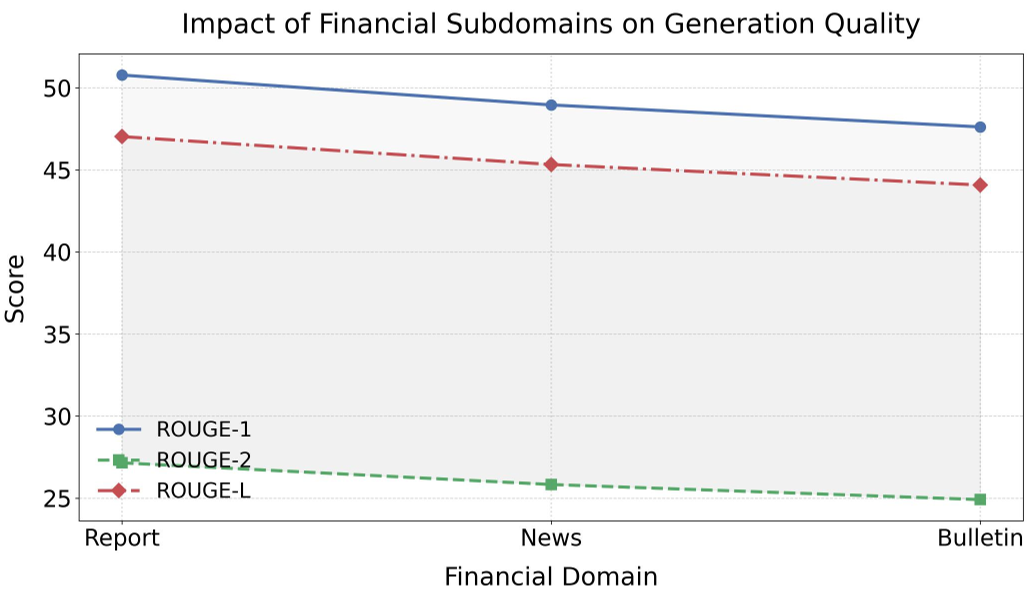
子领域稳定性分析
研究有趣的发现,该模型在**财报(Earnings Reports)**上的表现远好于新闻和公告。这印证了论文的初衷:文档的结构化程度越高,本文的“图建模”优势发挥得越充分。
深度洞察:为什么这很重要?
金融行业追求的不是语出惊人的“文采”,而是极高的事实准确性和论证逻辑的一致性。本文通过引入 (一致性损失)和 (语义对其损失),在数学层面上给模型加了“紧箍咒”,使其输出更符合金融专业人士的阅读习惯。
局限性:尽管在结构化文档中表现优异,但对于非结构化的社交媒体金融评论,图建模的构图难度会大幅增加。
总结与启示
这篇论文告诉我们,单纯堆规模(Scale)并不是解决长文本问题的万灵药。在特定领域,**“信息精简 + 逻辑重构”**的路线可能比无限扩大窗口更具性价比。对于正在开发复杂报告生成系统的团队来说,本文的图建模思路极具借鉴价值。