
CUDRT:重塑 LLM 生成文本检测的“五维”评估坐标系
Towards Reliable Detection of LLM-Generated Texts: A Comprehensive Evaluation Framework with CUDRT
本文提出了 CUDRT,一个旨在提升大语言模型(LLM)生成文本检测可靠性的综合评估框架和双语基准。该框架首创性地将 LLM 的文本操作细分为 Create(创建)、Update(更新)、Delete(删除)、Rewrite(重写)和 Translate(翻译)五大核心类别,涵盖了中英双语的多种现实应用场景。
TL;DR
随着大语言模型(LLM)的伪装性越来越强,如何可靠地实锤一份文档是否由 AI 生成?来自中国人民大学等机构的研究者提出了 CUDRT 框架。它不再仅仅关注简单的“问答对”,而是将 AI 的行为解构为 Create, Update, Delete, Rewrite, Translate 五大操作,并构建了目前最全面的中英双语基准测试。
背景定位:检测器也需要“压力测试”
目前的 AI 检测器(如 GPTZero, RoBERTa-based detectors)在实验室环境下表现尚可,但在现实应用中经常“翻车”。究其原因,是因为之前的基准测试(如 HC3)多集中在简单的 QA 模式,而忽视了 LLM 在现实中更常见的用法:即作为润色工具。AI 稍微改写一下、缩写一段话,现有的探测器可能就瞎了。CUDRT 的出现,就是为了给全球的探测器戴上“多功能校准镜”。
核心动机:探测器的“盲区”在哪?
研究者敏锐地发现,现有方法的局限性在于:
- 语种遮蔽:大部分探测器在英文上很猛,遇到中文就哑火。
- 操作维度缺失:如果 AI 只是对人类写的文字进行了“Expand(扩张)”或“Refine(精炼)”,这种人机混合文本极难识别。
- 泛化困境:在一个模型上练出来的探测器,换了另一个模型或另一种写作风格,准确率会断崖式下降。
methodology:CUDRT 的五大原子操作
CUDRT 框架的核心在于其对 LLM 行为的深度解构。作者将 LLM 对文本的加工抽象为五个维度:
- Create (C): 包括 Complete(补全)和 QA(问答)。这是最基础的生成。
- Update (U): 包括 Polish(润色)和 Expand(扩张)。这代表了人机协作的深度。
- Delete (D): 包括 Summary(摘要)和 Refine(精练)。通过精简信息来改变特征分布。
- Rewrite (R): 风格变换,语义保留但表达全变。
- Translate (T): 中英互译。
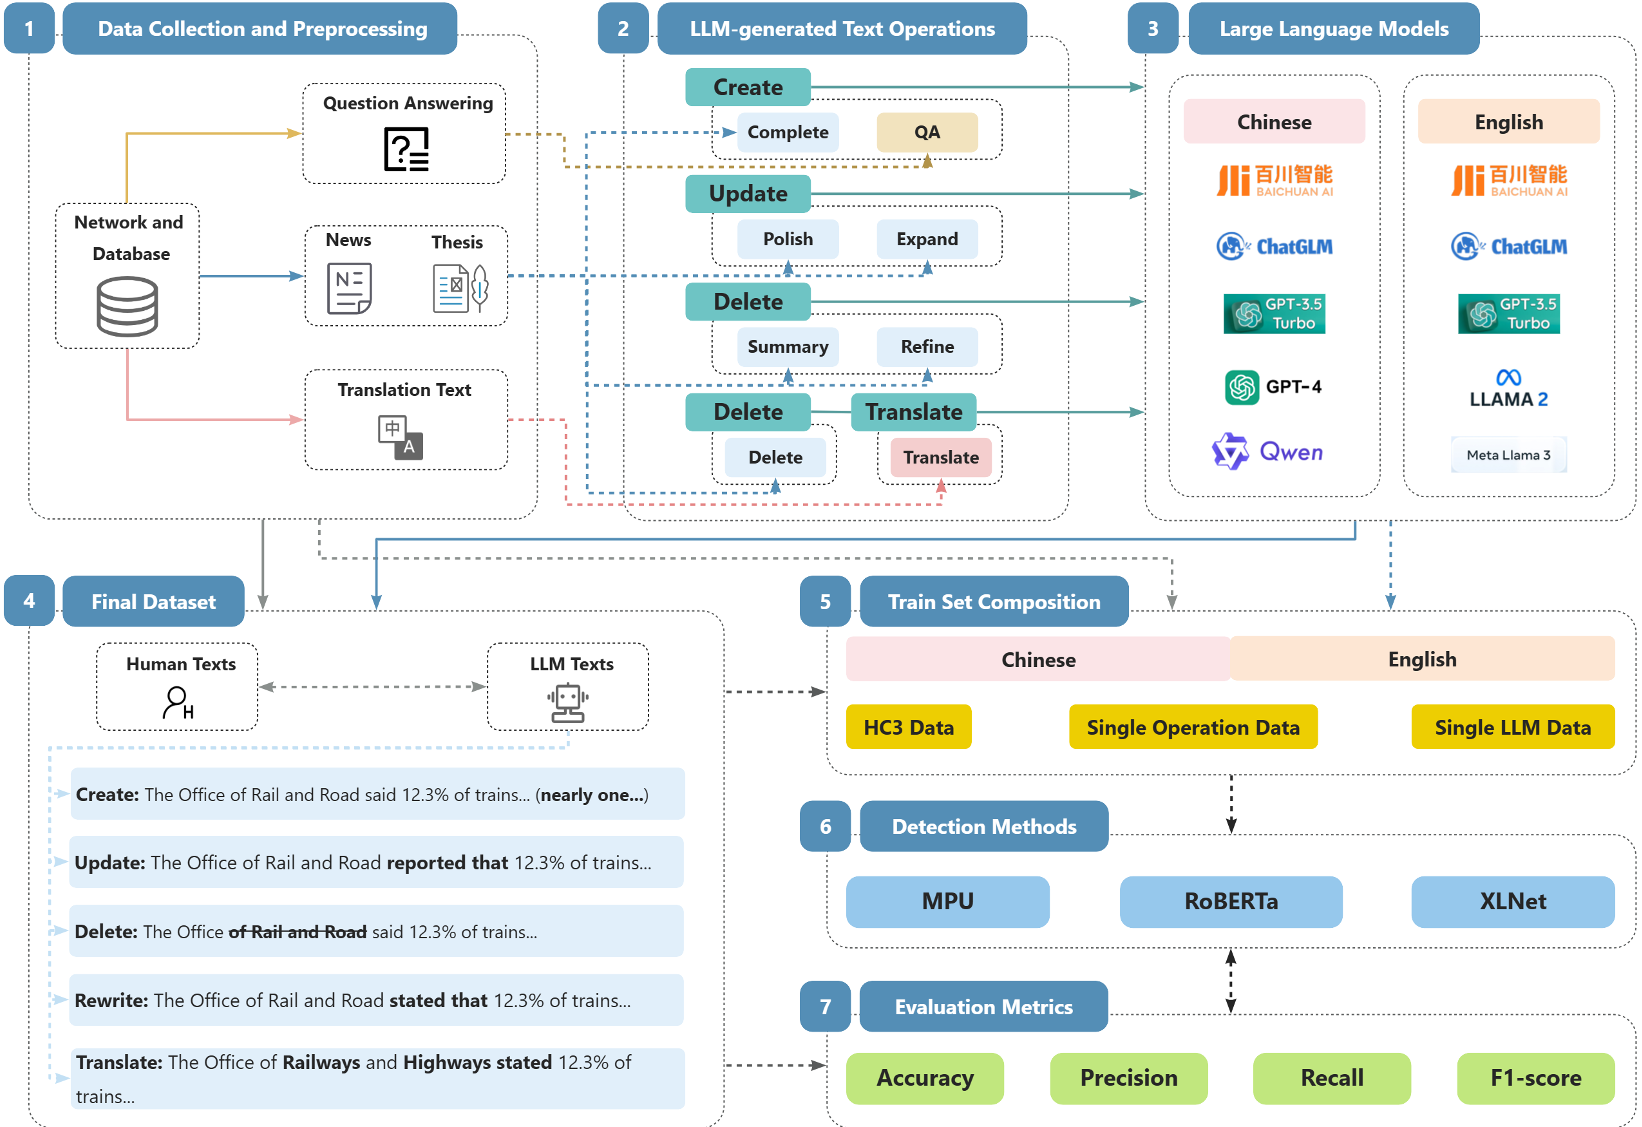 图 1:CUDRT 评估框架的逻辑流程图
深度洞察:谁是检测界的“泛化之王”?
通过对 RoBERTa, XLNet 和 MPU 等主流探测器的多维度测评,论文给出了几个反直觉的结论:
- “Delete” 数据的奇效:实验发现,使用“删除/摘要”操作生成的文本进行训练,能让探测器获得更强的跨任务泛化能力。作者推测,这是因为摘要操作在保留核心语义的同时,留下了最显著的 LLM 结构化特征特征。
- 中英差异显著:中文生成的检测难度普遍高于英文,这反映出中文 LLM 在模仿人类表达方面的复杂性更高,需要更细颗粒度的模型(如分词后的多尺度分析)。
- 困惑度(Perplexity, PPL)的骗局:如下图所示,AI 生成文本的 PPL 通常比人类文本更集中,但也说明了 LLM 倾向于生成“统计学意义上的安全文字”。
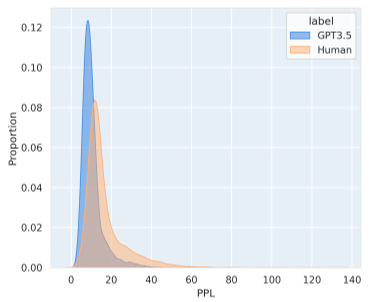 图 2:CUDRT 数据集中不同操作下的 PPL 指标特性
实验战绩与 SOTA 对比
在跨模型实验中,作者发现:
- 在 GPT-4 和 Qwen1.5 上训练的模型,在检测其他 LLM(如 Baichuan 或 Llama)时表现更稳健。
- Metric-based vs Model-based:虽然传统的深度学习分类器(RoBERTa)在特定任务上胜出,但基于指标的方法(如 MPU)在面对完全陌生的生成数据集时表现出了更强的跨数据集鲁棒性(Average Accuracy ~75%)。
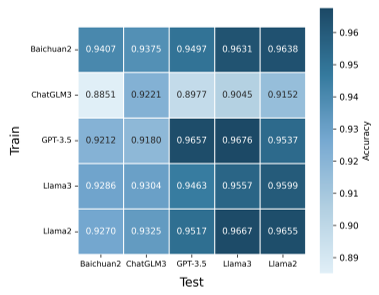 图 3:RoBERTa 在跨模型检测场景下的热力图,展示了明显的泛化衰减
总结与局限
CUDRT 填补了 LLM 生成检测领域缺乏多任务、多语种评估的空白。它告诉我们,要识破 AI 的伪装,不能只看它“写了什么”,更要看它如何“修改”。
局限性:尽管 CUDRT 已经非常全面,但面对目前日益流行的 Agent 协作和自适应提示词(Adaptive Prompting)生成的动态文本,检测器依然面临巨大的压力。未来的研究方向应进一步探索如何将检测逻辑嵌入到这种原子操作的微小指纹中。
启示:对于内容创作者和审核平台,CUDRT 证明了:混合式编辑文本是目前的检测盲区,加强针对“润色”行为的检测训练是未来的重中之重。