
Deep Delta Learning:让 Transformer 的残差流从“只加不减”走向“精准重写”
Deep Delta Learning
本文提出了 Deep Delta Learning (DDL),一种全新的 Transformer 残差连接机制。它将传统的“加法累加”更新规则重构为基于 Delta-rule 的“读-写-擦除”操作,允许模型在保持恒等路径的同时,能够选择性地重写或覆盖残差流中已过时的信息。
TL;DR
在传统的 Transformer 中,残差流(Residual Stream)就像一个只能不断叠加的记事本,信息只能被“加”进去,却很难被“擦除”。普林斯顿和 UCLA 的研究者提出的 Deep Delta Learning (DDL) 改变了这一现状。它引入了一种基于 Delta-rule 的更新机制,赋予了每一层网络“精准覆盖”旧信息的能力。实验显示,在不增加核心计算量的前提下,DDL 显著提升了语言模型的建模精度和下游任务表现。
痛点深挖:ResNet 的遗产与 Transformer 的枷锁
自 ResNet 诞生以来, 成了深度学习的黄金法则。在 Transformer 中,这意味着所有 Attention 和 MLP 层的输出都会被简单地加到残差流中。
然而,这种纯加法累加存在一个严重的物理直觉缺陷:如果模型在第 5 层产生了一个后来被证明是错误的推论,第 6 层无法直接“删掉”它。模型必须通过复杂的向量运算,产生一个抵消信号来中和旧信息,同时写入新信息。这种逻辑上的繁琐增加了模型管理的难度。
核心直觉:深度方向上的 Delta Rule
作者受序列模型(如 DeltaNet)的启发,将通常用于循环神经网络(RNN)时间步更新的 Delta Rule 搬到了神经网络的深度维度上。
1. 读-比较-写 (Read-Compare-Write) 机制
DDL 的核心公式如下:
- (方向):模型决定要在残差空间的哪一个维度进行编辑。
- (差值):计算目标值与当前选定方向上内容的差异。
- (门控):同步控制“擦除”旧内容和“写入”新内容的强度。
当 时,旧的方向分量被完全抹除,代之以新的 。这实现了从“盲目加法”到“语义覆盖”的跃迁。
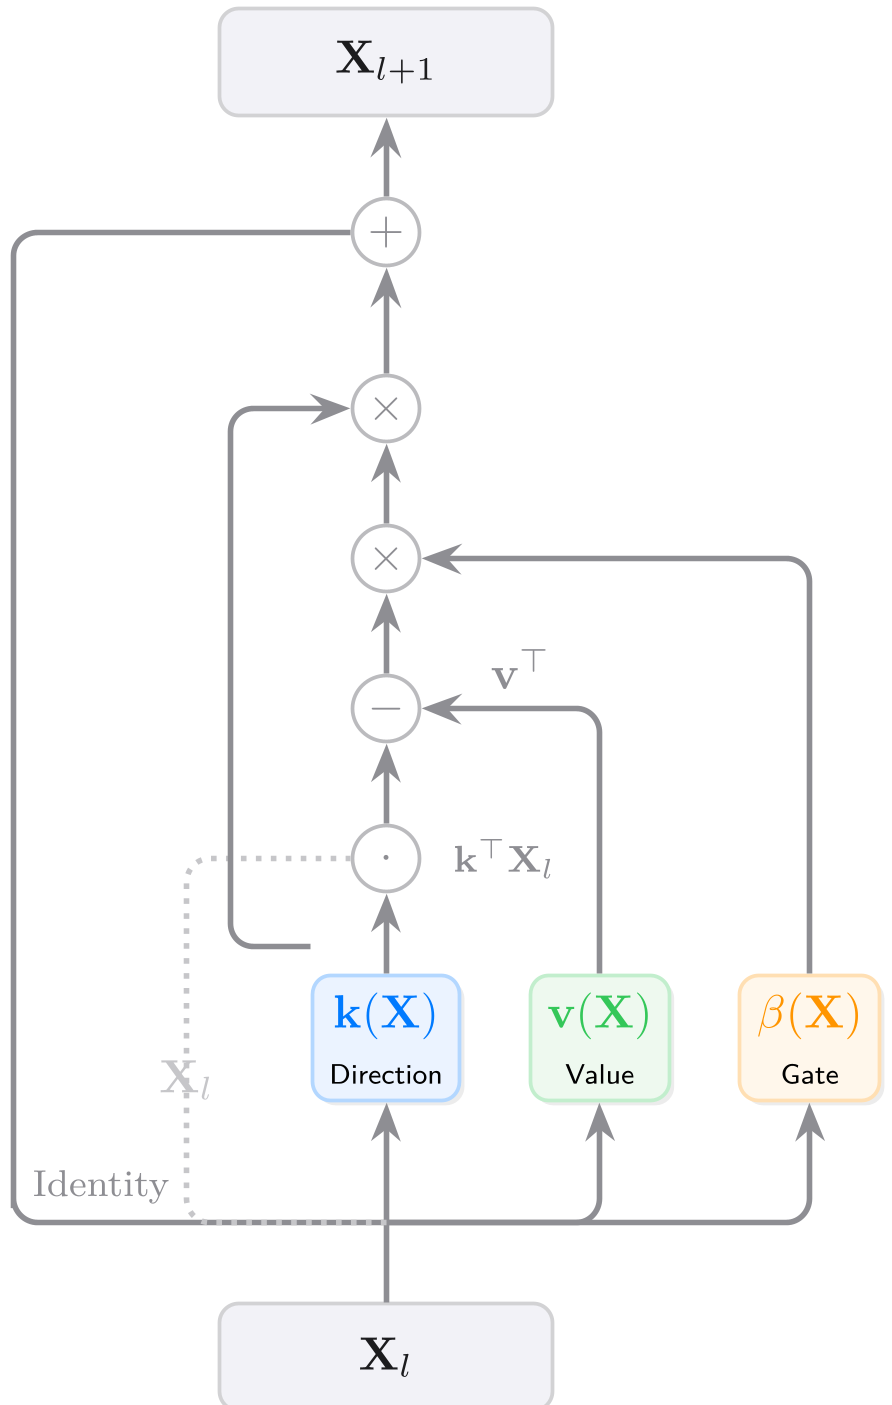 图 1: DDL 概览。左图展示了 gated rank-1 重写操作,右图展示了 DDL Transformer 的整体结构。
2. 存储与计算的解耦:扩展残差状态
DDL 进一步提出了 Expanded Residual State。通常 Transformer 的残差流宽度 与计算宽度一致,而 DDL 可以让残差流拥有 的空间(例如 )。
- Compress (压缩):将庞大的残差流投影回 维进入 Attention 层。
- Process (处理):标准计算,维持原有的计算复杂度。
- Rewrite (重写):将计算结果更新回 的存储空间。 这种设计让模型拥有了更肥沃的“记忆土壤”,而不必增加昂贵的注意力计算开销。
实验与结果:小参数下的“降维打击”
研究团队在 GPT-2 Small (124M) 和 Medium (353M) 规模上进行了严格的受控实验。
关键战绩
- 验证集 Loss:在 Medium 规模下,DDL-CC (Channel-axis Compression) 变体将训练 Loss 从 2.605 降低到了 2.576,提升效果极为显著。
- 推理效率:虽然引入了扩展状态,但通过优化的通道维卷积压缩(DDL-CC),其推理速度仍保持在基线的 75% 以上,内存占用仅增加约 2%-5%。
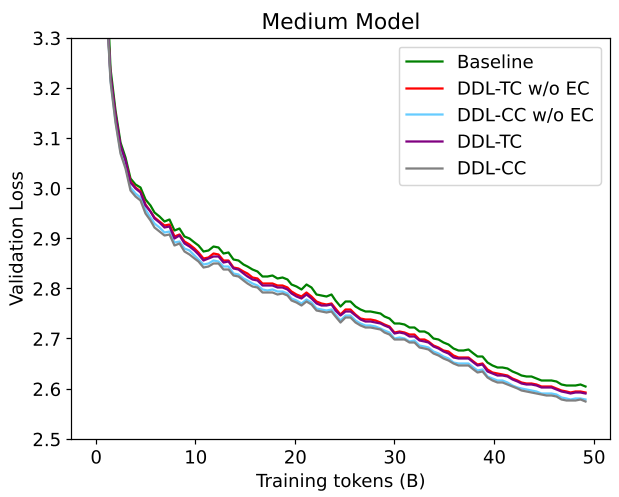 图 2: 不同 DDL 变体在 Medium 规模下的训练曲线。可以看到 DDL-CC (蓝色) 持续优于基线。
在下游任务 1-shot 评测中,DDL 在 ARC-E、SciQ 等逻辑推理类问题上表现尤为突出,平均得分提升了超过 1 个百分点。
深度洞察:为什么 DDL 有效?
DDL 的本质是引入了一种可学习的线性代数算子。从光谱分析(Spectral Analysis)可见,DDL 实际上在选定的特征方向上执行了一个算子 :
- 当 时,它是恒等变换(Identity),保证了深层网络易于训练。
- 当 时,它是正交投影,实现内容替换。
- 当 时,它变成了豪斯霍尔德变换(Householder Transformation),实现内容的镜像反射。
这种比纯加法更丰富的几何变换能力,使得每一层都能更高效地清理残差流中的噪音,保持信息的“纯净度”。
总结与局限
Deep Delta Learning 成功地向我们展示了:即使是像残差连接这样“神圣不可侵犯”的基石,依然存在巨大的优化空间。它不仅提升了模型性能,还为残差流的动态管理提供了理论支撑。
局限性:在大规模(10B+ 参数)模型上的扩展性仍需验证,且扩展残差状态()在 KV Cache 之外引入了一定额度的额外存储开销,这在显存敏感的场景下需要权衡。
展望:DDL 的设计理念非常契合当前追求“无限长上下文”的趋势。如果能将残差流看作一种动态更新的外部存储,Transformer 的推理深度和广度或许将迎来新的突破。