
DeepSeek-V3.2:开启开源模型“暴力推理”与“Agent 合成”的新纪元
DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models
DeepSeek-AI 发布了 DeepSeek-V3.2,这是一款在推理和智能体(Agent)性能上取得重大突破的开源大模型。该模型引入了原生稀疏注意力机制(DSA),并大幅提升了强化学习(RL)训练的计算预算,其高配置版本 DeepSeek-V3.2-Speciale 在 IMO 和 IOI 等顶尖竞赛任务中达到了金牌水平,性能足以抗衡 GPT-5 和 Gemini-3.0-Pro。
TL;DR
DeepSeek-V3.2 不仅仅是一次常规的版本迭代,它是对开源模型能力边界的一次强力拓宽。通过引入 DeepSeek Sparse Attention (DSA) 架构解决长文本效率问题,并投入超过预训练成本 10% 的资源进行强化学习(RL),DeepSeek 成功在推理能力上对齐了 GPT-5。更重要的是,它通过大规模合成环境(Synthesis Pipeline)解决了 AI Agent 的泛化难题,在 IMO 和 IOI 等人类顶级智力竞赛中斩获金牌战绩。
痛点深挖:开源模型的“效率”与“智力”天花板
在过去几个月中,尽管开源社区奋起直追,但闭源模型(如 OpenAI o1, Gemini 2.5)在复杂逻辑和 Agent 任务上的加速领先趋势愈发明显。DeepSeek 团队认为开源模型存在三个核心瓶颈:
- 架构低效:原生 Attention 在处理长序列时复杂度呈平方增长。
- 算力欠账:RL 阶段的投入远不足以激发出模型的潜在推理逻辑。
- 数据枯竭:真实的 Agent 交互数据稀缺且难以覆盖长尾场景。
方法论详解:DSA 与大规模 RL 扩展
1. DeepSeek Sparse Attention (DSA)
为了在长文本场景下保持高性能且不牺牲效率,DeepSeek-V3.2 在原有 MLA(Multi-head Latent Attention)的基础上实例化了 DSA。其核心是一个 Lightning Indexer(闪电索引器)。
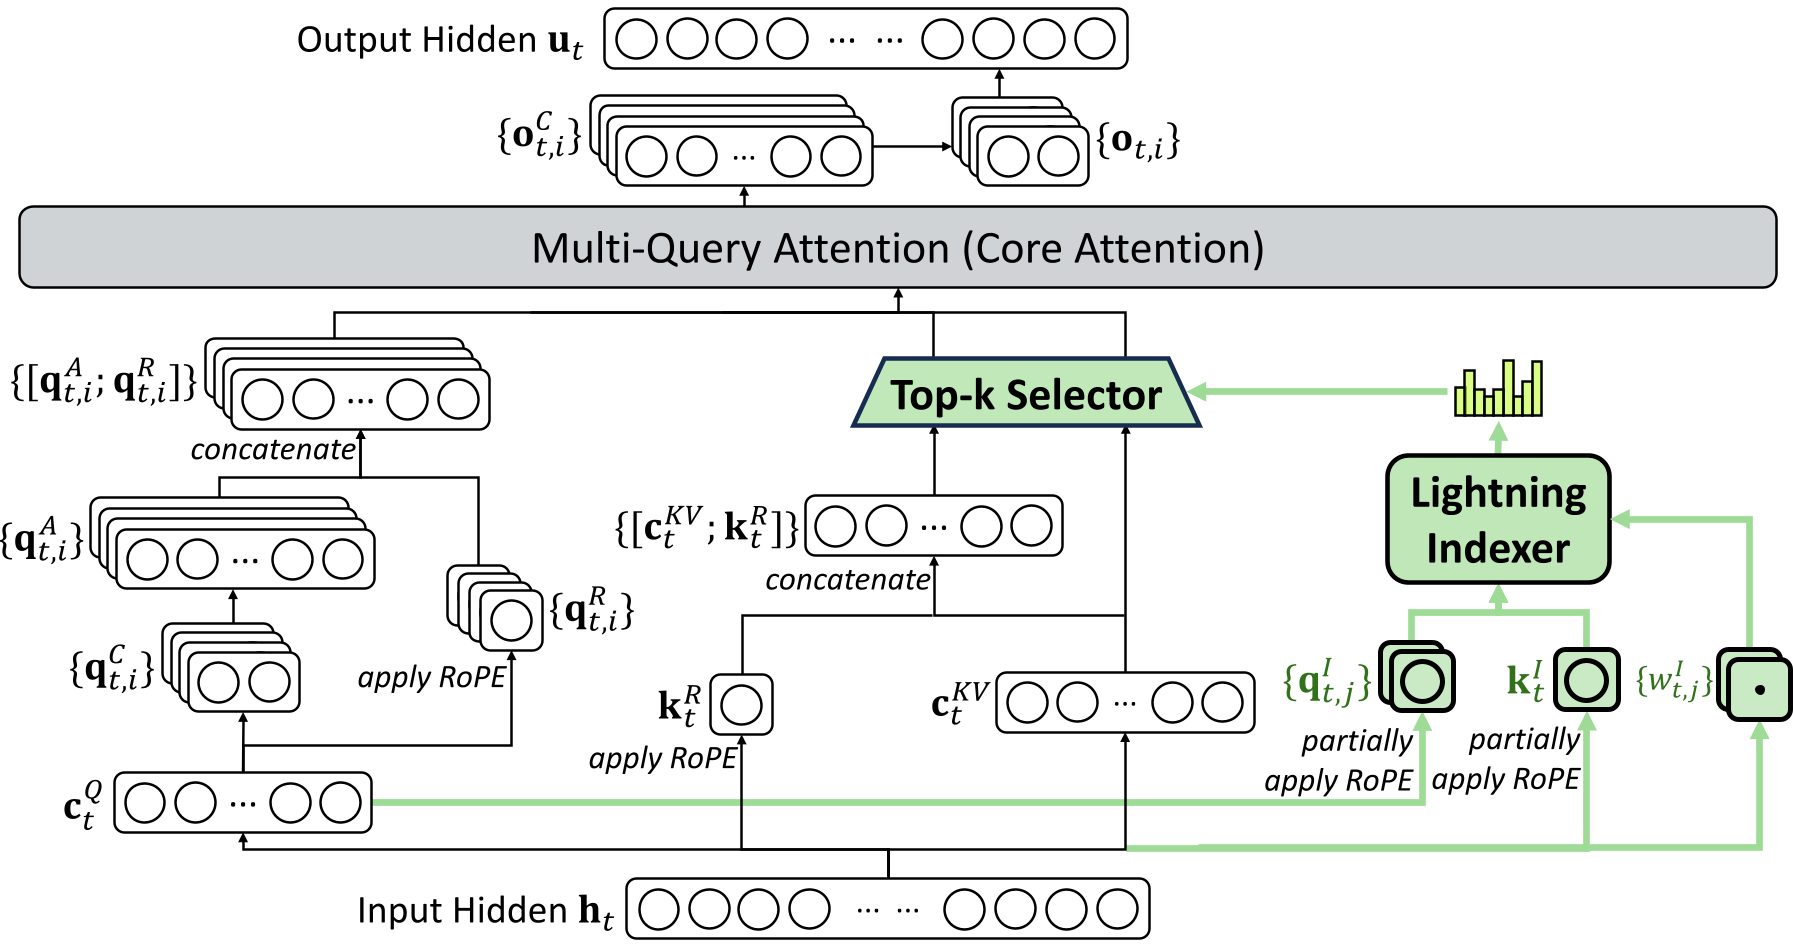
- 计算逻辑:Indexer 先计算 Query 与 Key 的相关性得分,仅选择前 个最相关的 Token 进行注意力计算。
- 训练策略:采用两阶段法。首先是“密集热身(Dense Warm-up)”,冻结主模型仅训练 Indexer;随后进入“稀疏训练阶段”,全面释放 128K 上下文的稀疏处理能力。
2. SCALING GRPO:稳定的大规模强化学习
DeepSeek 并没有止步于传统的 RLHF,而是将 GRPO 算法 扩展到了极致。为了解决超大规模 RL 下的训练不稳定性,他们引入了:
- 无偏 KL 估计:修正了常用的 K3 估计器,避免在策略大幅偏离时产生异常梯度。
- Off-Policy 序列掩码:主动屏蔽掉那些因策略发散而产生的负面样本。
- 保持专家路由(Keep Routing):在 MoE 架构中,确保推理与训练时的专家路由路径一致,防止优化震荡。
Agent 的进化:从“复读机”到“思想家”
DeepSeek-V3.2 在 Agent 领域的提升得益于一套创新的 合成流水线(Synthesis Pipeline)。
- 持续推理(Thinking in Tool-Use):模型在调用工具(如 Python 解释器、搜索 API)之前和过程之中都会进入
<think>模式。为了节省 Token,DeepSeek 设计了精妙的上下文管理:只有新用户消息进入时才清理思考轨迹,而工具交互产生的中间逻辑会被保留。 - 环境合成:由于真实 Agent 数据有限,团队开发了“环境合成智能体”,自动生成了 1827 个可验证的任务导向环境(如行程规划、代码调试),显著提升了模型的泛化性。
实验与结果:金牌级别的推理性能
在各项硬核指标中,DeepSeek-V3.2 展示了其统治力:
- 数学与编程:在 AIME 2025 达到 93.1%,Codeforces Rating 达到 2386。
- 竞赛神话:其 Speciale 版本在 IOI 2025 中获得 492 分,达到了国际金牌水平。
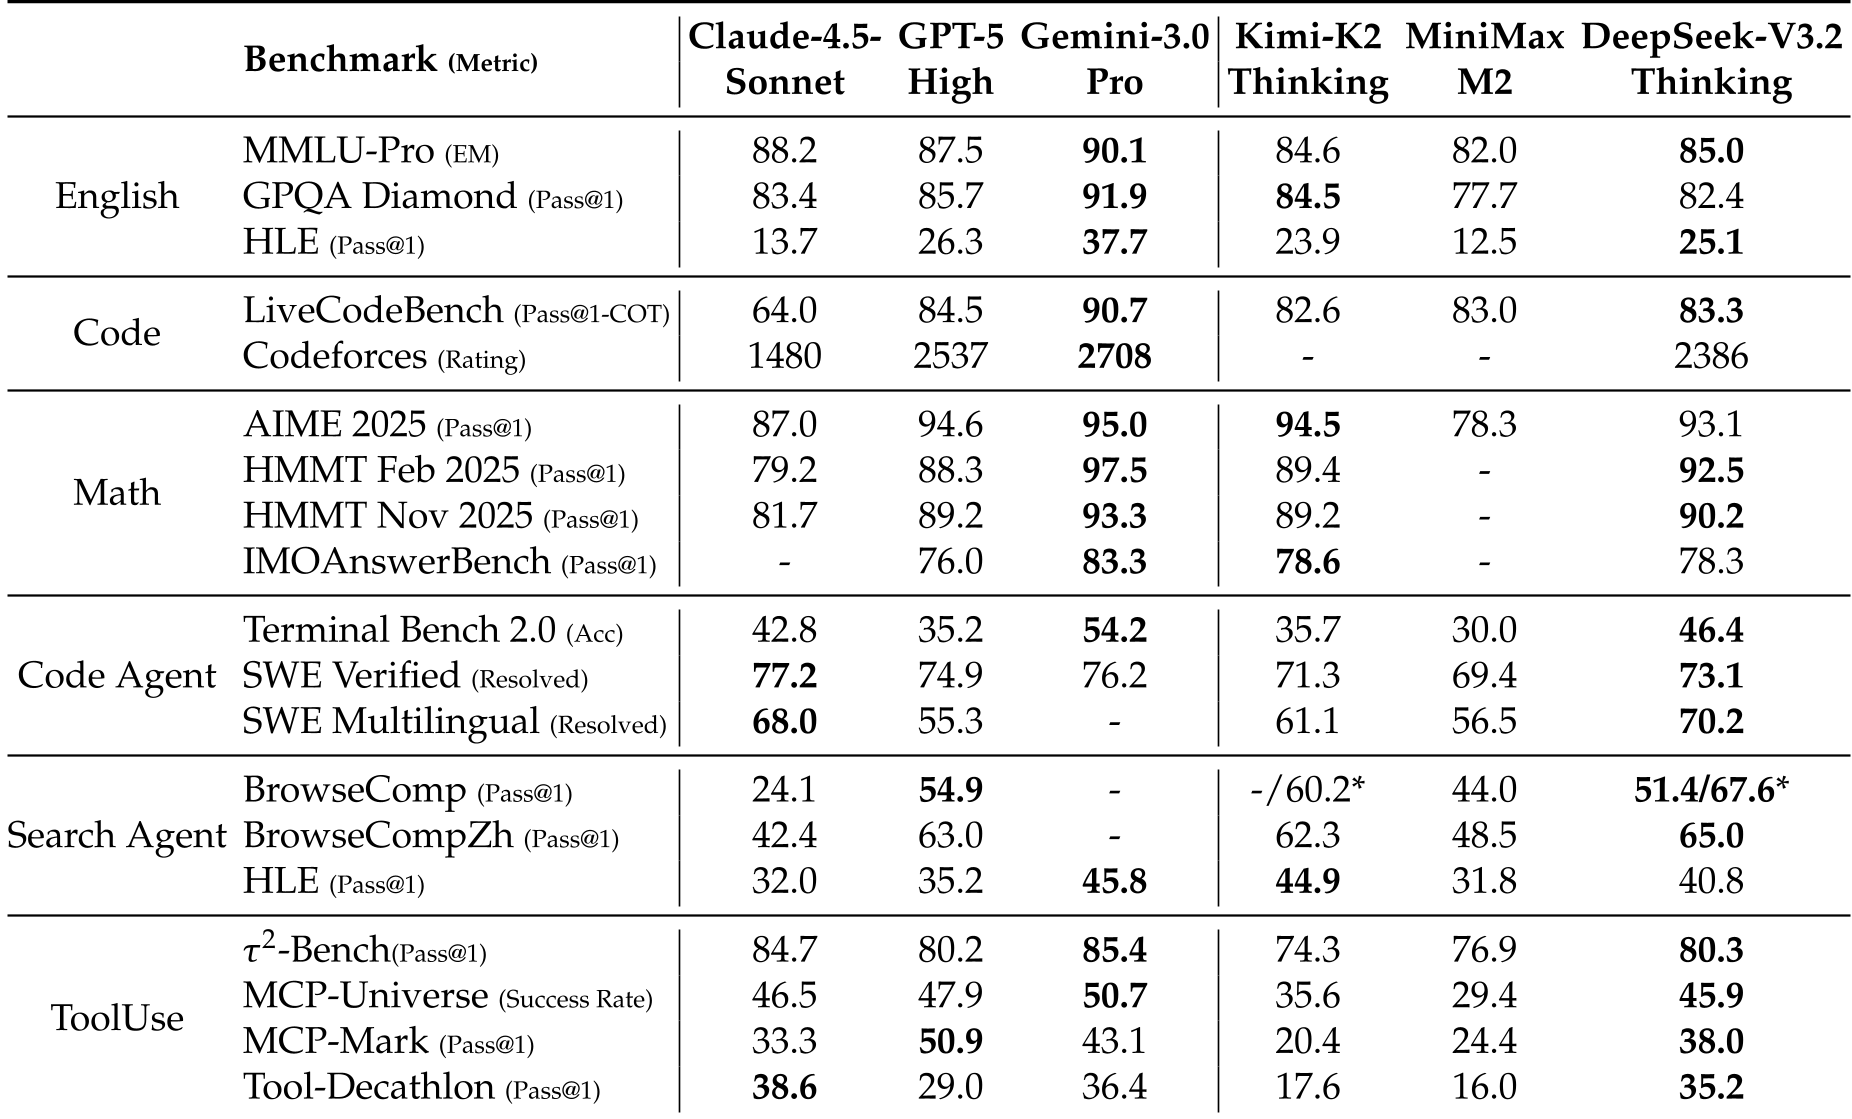
在 Agent 专属测试(如 MCP-Mark, Tool-Decathlon)中,DeepSeek-V3.2 的表现远超其他开源对手,甚至在部分任务上逼近 Claude 4.5 Sonnet。
深度洞察与总结
Takeaway: DeepSeek-V3.2 的成功证明了,在大模型竞赛的下半场,“推理架构(DSA)+ 强化学习强度(Compute-Heavy RL)+ 合成环境训练” 是开源逆袭闭源的最佳路径。
局限性与未来: 尽管推理能力惊人,但 DeepSeek 坦言其知识密度(World Knowledge)受限于总训练 FLOPs,仍略逊于 Gemini 全家桶。此外,虽然引入了稀疏注意力,但在达到同等智能水平时,其生成的推理 Token 长度依然偏多。未来的方向将聚焦于提升“智能密度”,让模型用更少的思考达到更深的逻辑结论。
这不仅是一个模型的发布,更是对“测试时计算(Test-time Compute)”与“合成训练数据”结合范式的又一次有力回响。