
DeepSeek-V4:架构革命下的百万上下文效率之王
DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
DeepSeek-V4 系列是 DeepSeek-AI 推出的新一代混合专家模型(MoE),包含 1.6T 参数的 V4-Pro 和 284B 参数的 V4-Flash,支持百万级(1M)Token 上下文,在推理和知识任务上达到或超越了 GPT-5.4 性能。
TL;DR
DeepSeek-V4 系列(V4-Pro 与 V4-Flash)标志着开源模型正式进入“百万 Token 高效推理”时代。通过CSA(压缩稀疏注意力)与HCA(重度压缩注意力)的混合设计,配合mHC(流形约束超连接),DeepSeek 在大幅降低 KV Cache 占用的同时,在推理、编程和知识问答上与 GPT-5.4 等顶尖闭源模型分庭抗礼。
痛点深挖:超长上下文的“内存墙”
在处理长文本时,传统 Transformer 的 Self-Attention 复杂度随长度呈平方增长。对于百万级上下文,KV Cache 的显存占用会迅速撑爆 GPU,导致推理成本高不可攀。即便采用了 MoE(混合专家模型)来增加参数量而不增加计算量,注意力的“底座”负担依然沉重。DeepSeek-V4 的动机很明确:通过不对称压缩,彻底重构注意力公式。
方法论详解:混合注意力与流形约束
DeepSeek-V4 的核心贡献在于其对模型“脉络”的重塑:
1. 混合注意力架构 (Hybrid Attention)
模型不再对每一个 Token 进行平等的全量计算,而是交替使用两种压缩策略:
- CSA (Compressed Sparse Attention):将序列每 个 Token 压缩为一个条目,再利用 DeepSeek Sparse Attention (DSA) 仅关注其中 Top-k 的部分。
- HCA (Heavily Compressed Attention):进行更激进的压缩(压缩率 ),但在压缩后保持稠密关注,确保全局信息的低功耗留存。
在这种设计下,KV Cache 大小被压缩至基准配置的 2% 左右。
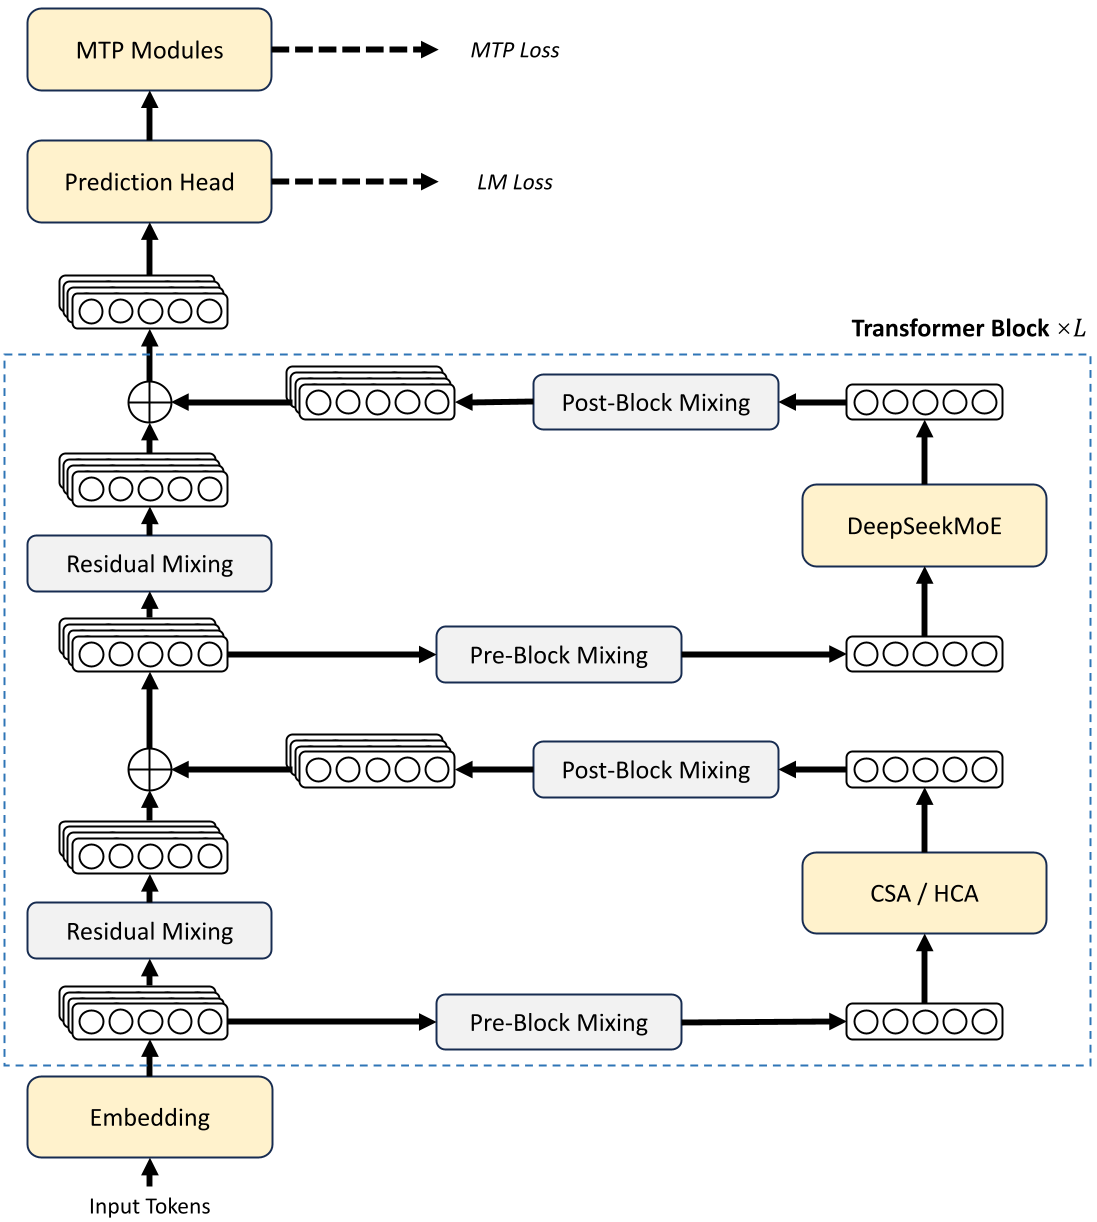 图 1:DeepSeek-V4 总体架构,展示了 CSA、HCA 与 mHC 的集成
2. mHC:让信号更稳健
为了解决超深、大规模模型训练中的数值崩溃,作者引入了 mHC (Manifold-Constrained Hyper-Connections)。通过 Sinkhorn-Knopp 算法将残差映射约束在双随机矩阵流形上,确保信号传播的非膨胀性(Non-expansive),极大地提升了训练稳定性。
3. Muon 优化器
弃用部分 AdamW 路径,改用 Muon 优化器。其核心在于利用 Newton-Schulz 迭代进行正交化更新,实验证明其收敛速度远超传统优化器。
实验与结果:效率与智能的双重飞跃
DeepSeek-V4-Pro 在多个维度展现了 SOTA 实力:
- 编程巅峰:在 Codeforces 评测中获得 3206 分,追平 GPT-5.4,成为最强编程开源模型。
- 推理效率:在处理 1M 上下文时,V4-Pro 的 KV Cache 仅占 V3.2 的 10%,显著降低了 API 服务成本。
- 知识问答:SimpleQA 表现优异,大幅拉开了与 Kimi-K2.6 和 GLM-5.1 的差距。
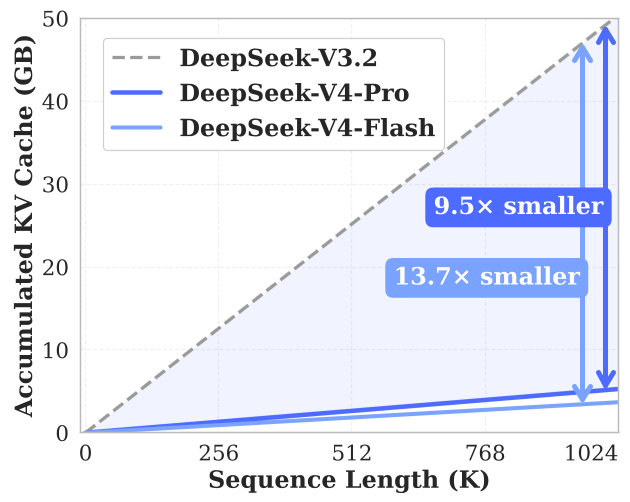 图 2:相比 V3.2,DeepSeek-V4 系列在长文本下的 FLOPs 和 KV Cache 优势巨大
深度洞察与总结
Takeaway: DeepSeek-V4 的成功在于它并不是盲目追求“暴力美学”,而是针对性地对 Transformer 架构的低效部分(Attention)和不稳定部分(Residual Connection)进行了精密的外科手术。
局限性: 虽然模型在 1M 上下文表现出色,但文中提到其架构由于集成了多种预研技巧而显得相对“复杂”。此外,Anticipatory Routing(预见性路由)虽然稳定了训练,但其底层物理机制(Why it works)仍有待进一步理论解释。
展望: 随着 DeepSeek-V4 普及,开发者将在极低成本下处理海量代码库、全书分析或复杂的 Agent 任务。这种“高智能+低成本长文本”的组合,将是未来 AI 应用爆发的真正催化剂。