
DeTeCtive:重新定义 AI 文本检测——从“非黑即白”到多级风格表征
DeTeCtive: Detecting AI-generated Text via Multi-Level Contrastive Learning
本文提出了 DeTeCtive,一个通用的 AI 生成文本检测框架。该框架引入了名为多级对比学习(Multi-Level Contrastive Learning)的核心机制,不仅能区分人类与 AI,还能精细化辨别不同 LLM 之间的写作风格差异,在多项基准测试及 OOD 场景下均达到 SOTA。
TL;DR
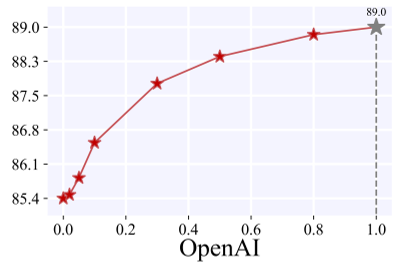
针对日益泛滥的 AI 生成文本,字节跳动与国科大的研究团队提出了 DeTeCtive 框架。它摒弃了传统的“二元分类”思维,转而通过多级对比学习去捕捉 AI 模型特有的“写作风格”。该方法不仅在常规测试中刷新 SOTA,更在分布外(OOD)检测中表现惊人,并支持一种名为 TFIA 的黑科技:无需重新训练模型,只需更新特征库即可识别最新的 AI 模型。
核心动机:模型也是有“笔迹”的
过去,我们倾向于寻找 AI 文本中所谓的“统计破绽”(如 Perplexity)。但随着 LLM 进化的日益完美,这些破绽正在消失。作者提出了一个深刻的直觉:每一个 LLM 都可以被看作是一个具有特定风格的“作者”。
因为架构、训练数据和对齐策略的不同,Llama 产生的文本总会带有 Llama 的“味道”,这与 GPT-4 的风格存在显著边界。如果能让模型学习这种精细的风格空间,那么检测 AI 生成文本就变成了:识别这段话是否落入了已知的“AI 风格簇”中。
方法论:多级对比学习(Multi-level Contrastive Learning)
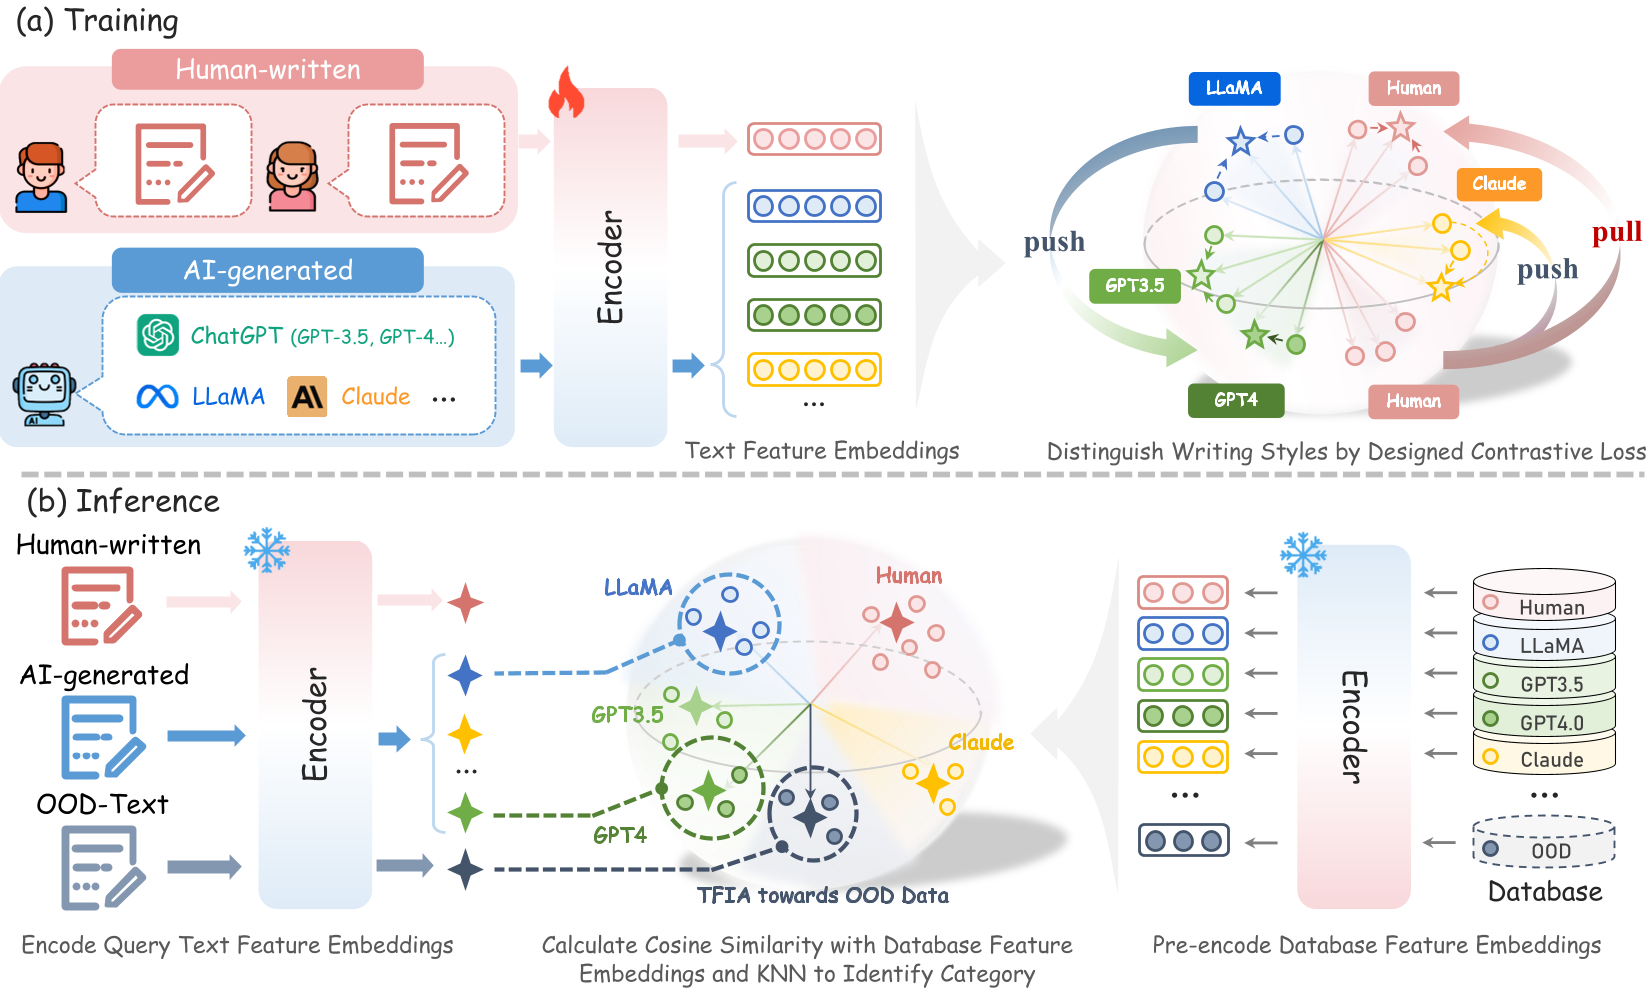
DeTeCtive 的核心是一个精心设计的损失函数。它不只告诉模型“这是 AI”,还告诉模型“这是 GPT 系列里的 GPT-3.5”。
1. 亲缘关系校准
作者确立了一个四级相似度约束(Hierarchy Constraint):
- P1(同模型) > P2(同公司/同系列模型) > P3(任意 LLM 之间) > P4(人类文本)。
通过这种方式,特征空间被拉伸得更有层次感。
2. 免训练增量自适应 (TFIA)
这是本文最具商业价值的贡献。当市面上出现了一个全新的模型(如 GPT-5)时,传统的检测器需要重新收集数据并进行全量微调。而 DeTeCtive 只需要:
- 用现有的 Encoder 对少量新模型文本进行特征提取(Embedding)。
- 将这些特征向量存入数据库(Vector DB)。
- 推理时通过 KNN 检索新特征,即可实现对新模型的识别。
实验与结果:全方位吊打基准
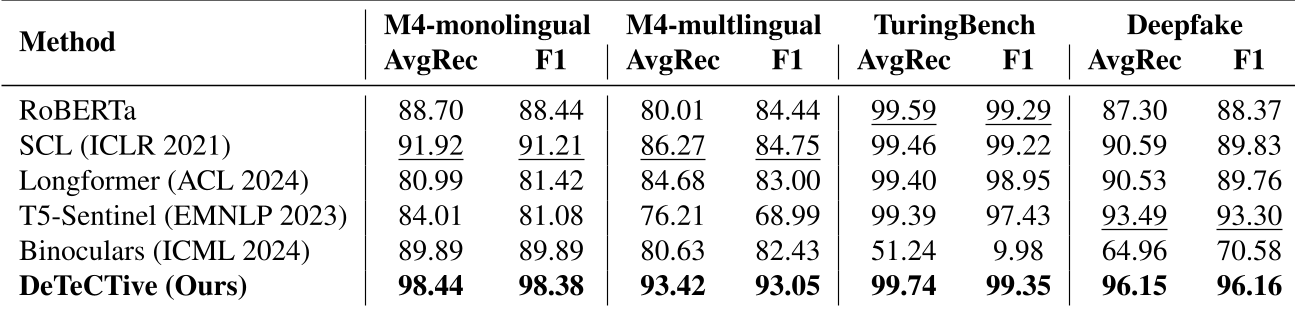
研究人员在 Deepfake、M4 和 TuringBench 三大主流数据集上进行了压测。
关键战绩:
- 跨领域与跨模型检测:在最难的 Deepfake 子集上,AvgRec 达到 96.15%,高出第二名(T5-Sentinel)近 3 个百分点。
- 对抗改写攻击:面对 DIPPER 或 OUTFOX 等复杂的改写攻击,传统 RoBERTa 检测器的性能会腰斩,而 DeTeCtive 依然能保持 97% 以上的准确率,证明了其捕获的是底层风格特征而非表面词汇。
可视化证据
通过 UMAP 降维可以清晰看到,经过 DeTeCtive 训练后,原本混沌的文本特征空间变得井然有序,人类文本(Human)与各大 LLM 家族(OpenAI, Llama, OPT 等)形成了明显的聚类边界。
深度洞察
DeTeCtive 的成功证明了:对比学习在处理极其模糊的分类边界时,比交叉熵(Cross-Entropy)更具鲁棒性。 它的“检索式”推理逻辑让检测器从一个“死板的裁判”变成了一个“博学且可扩展的图书馆”。
局限性:虽然 TFIA 表现优异,但其性能高度依赖于特征数据库的质量。如果针对极短的文本(如社交媒体状态),风格特征可能难以充分展开,这仍是该领域的通用难题。
总结
DeTeCtive 为 AI 治理提供了一个高效的工具。它告诉我们,与其死磕“人类文本长什么样”,不如去深入研究“AI 留下的风格指纹”。这种从分类到表征的范式转移,或许是赢下这场“猫鼠游戏”的关键。