
谁才是“伪装大师”?深度剖析 LLM 文本检测的难点与真相
Which LLMs are Difficult to Detect? A Detailed Analysis of Potential Factors Contributing to Difficulties in LLM Text Detection
本文对不同大语言模型(LLM)生成文本的可检测性进行了细致研究,提出了一个新的学生作文重写数据集 RIP。通过使用 LibAUC 库训练了 92 个分类器,研究发现 OpenAI 家族(如 GPT-4o)生成的文本由于在熵值和 OOV 比例上更接近人类,成为跨领域最难检测的模型。
随着大语言模型(LLM)的普及,从学术竞赛到新闻评论,AI 生成的内容(AIG-Text)几乎无处不在。然而,一个关键的技术点往往被忽视:并非所有的模型都一样容易被识破。
近日,来自剑桥大学和德州 A&M 大学的研究团队发布了一项深入分析,揭示了不同 LLM 家族在检测难度上的显著差异。
TL;DR
- 最强伪装者:OpenAI 家族(GPT-3.5, GPT-4o)生成的文本最难与人类作品区分。
- 领域差异:科学写作(Scientific Writing)比故事创作或观点陈述更难检测,检测器的失效率更高。
- 技术洞察:OpenAI 文本之所以难测,是因为其在**信息熵(Entropy)和未登录词比例(OOV)**上与人类极其相似,成功“借用”了人类的写作特质。
痛点深挖:检测器并非“万灵丹”
在教育和科研领域,误判 AI 写作的代价极大。然而,现有的检测研究往往将所有 AI 文本混为一谈。作者指出,如果不考虑模型家族(Llama, GPT, Claude 等)和文本领域(科学、创意、日常)的差异,检测器的评估结果将具有极大的误导性。特别是当用户使用“重写(Rewrite)”指令模仿人类习惯时,传统的检测手段往往会失效。
方法论:LibAUC 与跨模型对抗
为了公平评估,研究人员开发了 RIP (Rewritten Ivy Panda) 数据集,其核心在于“重写攻击”:要求 LLM 模仿学生作文的用词习惯。
1. 实验架构
研究人员使用了 DistilRoBERTa 分类器。不同于常规的交叉熵损失,本研究引入了 LibAUC 库。
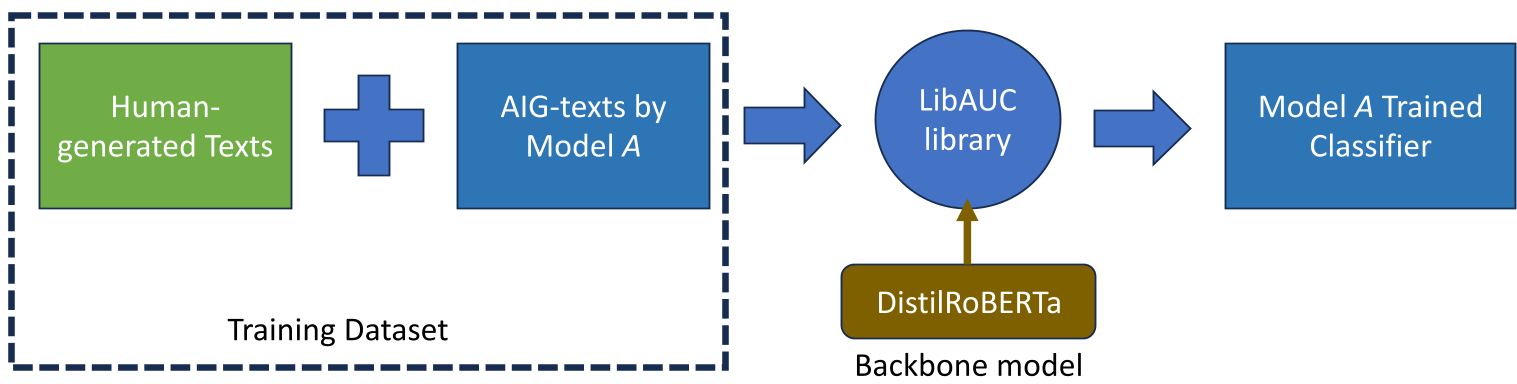 图 1:分类器训练框架。通过变换 Model A 的模型家族,测试各检测器对特定模型的敏感度。
关键技术点:
- 直接优化 AUC:由于人类文本与 AI 文本往往不成比例,优化 AUC 比优化 Accuracy 能更有效地降低误报率。
- DualSampler:确保每个迷你批次中人类和 AI 样本平衡。
实验结果:OpenAI 的统领地位
实验揭示了一个令人警醒的现象:如果你用 Llama 生成的数据训练检测器,它在面对 GPT-4o 时几乎会“致盲”。
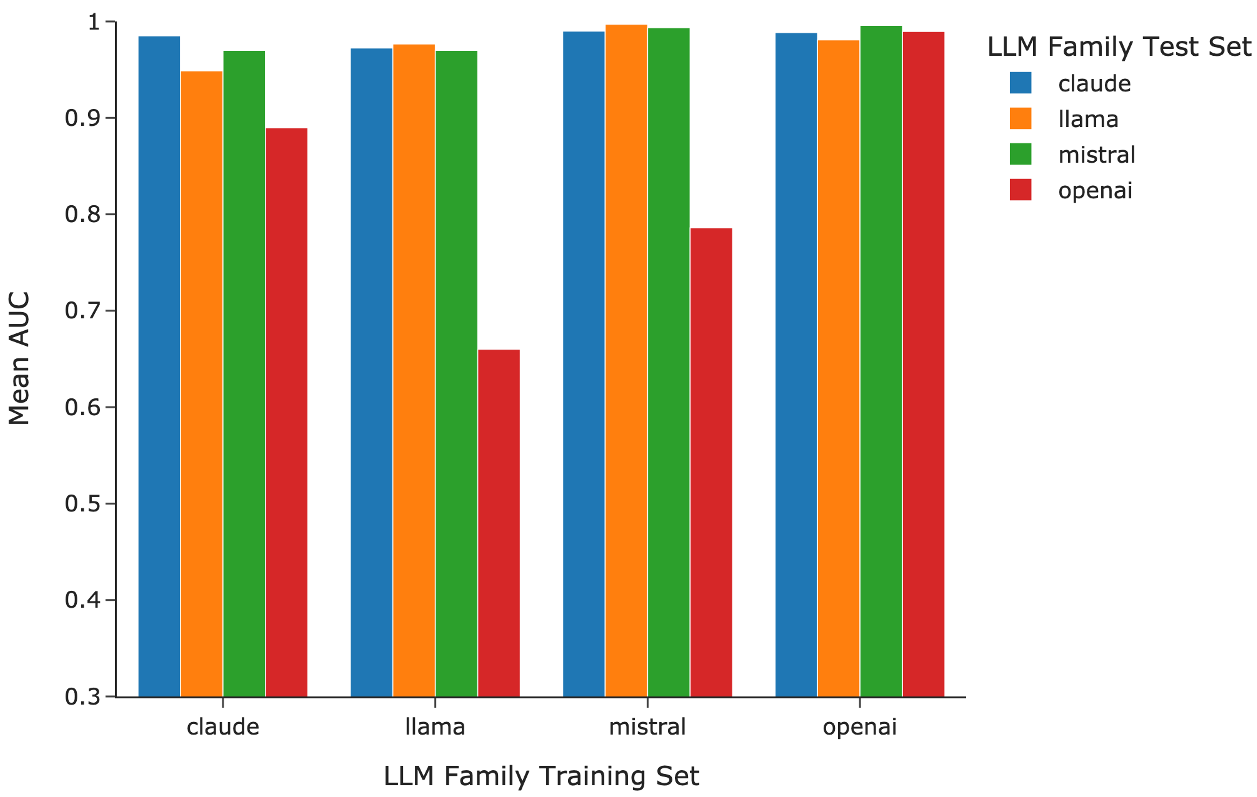 图 2:不同模型训练出来的分类器在各测试集上的平均 AUC。可见测试集为 OpenAI 时,曲线显著向下凹陷。
- 科学领域的陷阱:在 Deepfake 文本数据集中,Scigen(科学写作)领域的平均 AUC 仅为 0.975,且方差很大,说明某些科学模型已经能生成极具迷惑性的虚假论文。
- GPT-4o 的强大:在 RIP 数据集中,GPT-4o 在所有非同族分类器面前表现出了最强的抵抗力。唯一的例外是 Claude Haiku 训练的分类器,展现了一定的跨模型检测潜力。
深度洞察:为什么 OpenAI 难以检测?
研究团队通过语言学分析给出了答案。
1. 熵值的“人类化”
文本熵衡量了预测下一个单词的不确定性。通常 AI 文本的熵值较低(更可预测)。但研究发现,OpenAI 模型的熵分布曲线相比其他模型更偏向右侧,即向人类的复杂度靠拢。
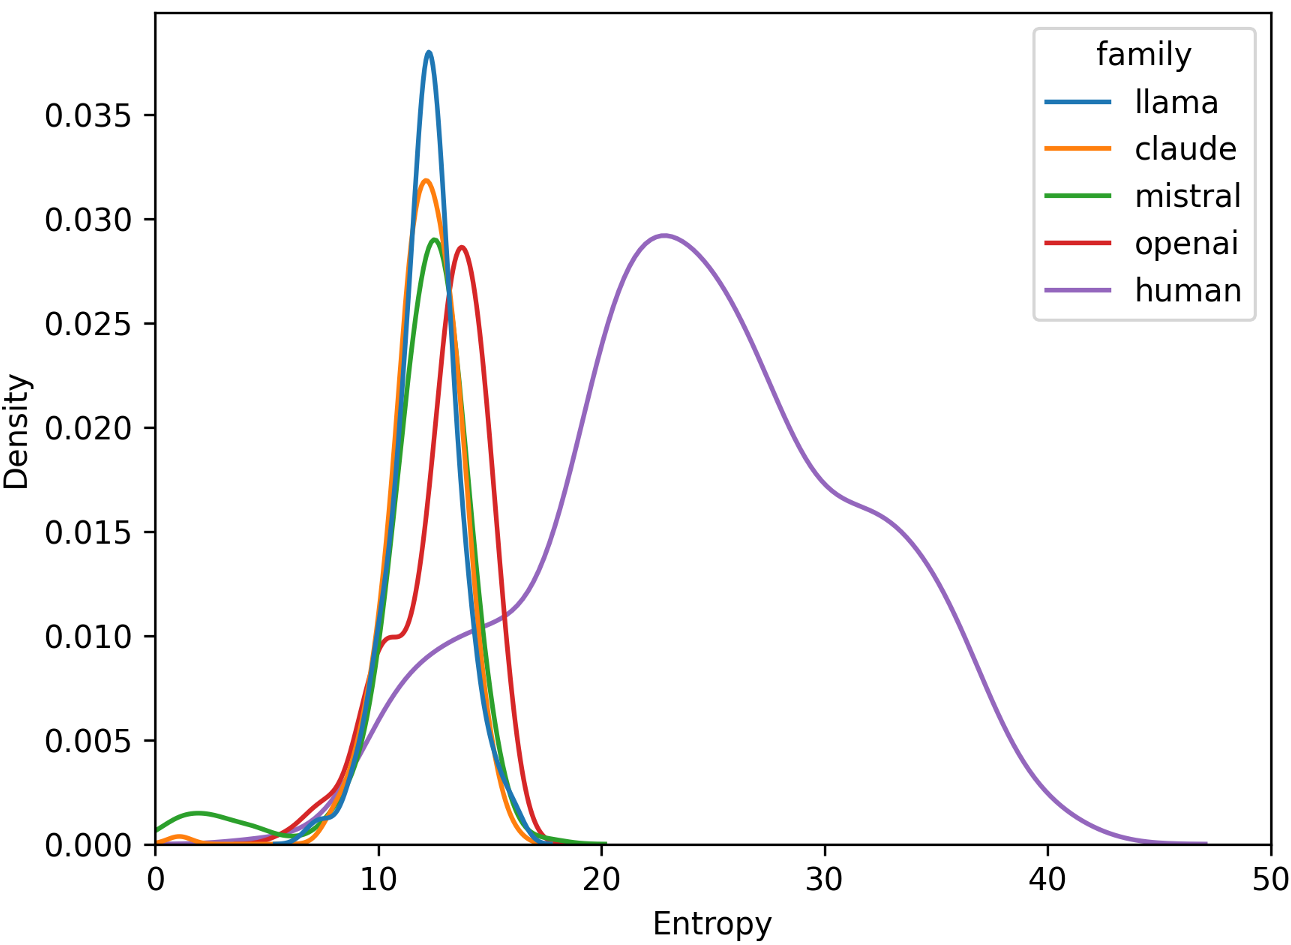 图 3:OpenAI 处理的文本在熵分布上不仅高于 Llama 和 Mistral,且形状与人类分布(右侧橙色实线)高度重合。
2. 未登录词(OOV)的巧妙运用
人类在写作时常用一些不常见的特定词汇。OpenAI 模型在重写任务中,能够精准地保留并利用这些词汇,使其 OOV 比例分布几乎与人类一致。这种对人类“瑕疵”和“独特性”的模仿,是其躲避检测的关键。
总结与启示
这项工作告诉我们:
- AI 检测没有一劳永逸:一个针对 GPT-3.5 优化的检测器,在 GPT-5 面世后可能迅速失效。
- 多样化的必要性:开发者在构建检测工具时,必须包含来自不同云厂商(AWS Bedrock, OpenAI)和不同参数规模模型的混合语料。
- 关注语言复杂度:未来的检测逻辑或许不应仅关注概率,更要关注文本在复杂语义结构和稀有词汇上的分布特征。
结论: 随着 LLM 进一步演进,检测器与生成器之间的“猫鼠游戏”将进入更精细化的统计博弈阶段。