
谁是文本伪造之王?深入解析 LLM 文本检测的“硬骨头”
Which LLMs are Difficult to Detect? A Detailed Analysis of Potential Factors Contributing to Difficulties in LLM Text Detection
2024-10-18
总结
问题
方法
结果
要点
摘要
本文通过构建 Deepfake Text 和 RIP 两个大规模数据集,系统评估了不同 LLM 家族(如 OpenAI, Llama, Claude)在四个写作领域中的检测难度。研究采用 LibAUC 库训练了 92 个 DistilRoBERTa 分类器,旨在识别 AIG 文本检测中的“难点”模型及其影响因素。
TL;DR
随着大语言模型(LLM)的普及,区分“人写的”和“AI写的”已成为学术诚信和内容安全的核心战场。本文对 27 个 LLM 模型生成的文本进行了深度体检,发现 OpenAI 家族(如 GPT-4o)是目前的检测盲区,它们通过模拟人类的词汇选择和复杂的文本熵值,成功在检测器面前修成了“隐身术”。
背景定位:这是一篇典型的“防御侧深度基准测试(Benchmarking)”论文,它不仅刷新了 AIG 探测的 SOTA 基准,更从物理直觉上解释了 OpenAI 为何能欺骗大多数分类器。
痛点深挖:为何有的 AI 文本“一眼假”,有的却天衣无缝?
目前的 AIG 文本检测器面临两个致命问题:
- 领域敏感性:一个在新闻数据上训练的检测器,在处理科学论文(Scigen)时表现极差。
- 泛化能力缺失:开发者往往用 Llama 生成的数据训练模型,结果遇到 GPT-4o 瞬间“哑火”。
作者提出,目前的检测难点在于我们不清楚各个 LLM 的 Inductive Bias(归纳偏置)。不同的模型架构和训练语料库导致了生成文本在统计分布上的差异,这种差异正是分类器赖以生存的土壤。
核心方法论:LibAUC 与跨家族评估架构
为了彻底摸清 LLM 家族的底细,作者采用了 DistilRoBERTa 这一轻量化但强大的 Transformer 模型作为骨干,并配合 LibAUC 库进行训练。
1. 架构解析
作者采用了一种全矩阵式的测试方法:在 A 家族上训练,在 B-Z 家族上测试。这种方法能清晰揭示模型间的“亲缘关系”及其检测溢出效应。
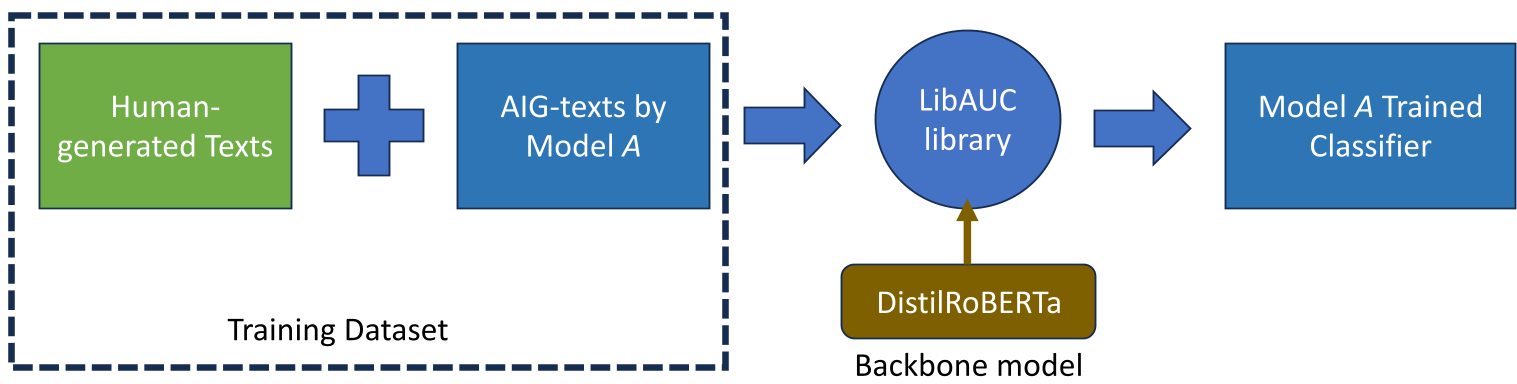
2. AUC 极大化
考虑到实际应用中正负样本(AI 与人类文本)比例经常失衡,作者放弃了传统的 Cross-Entropy 损失函数,转而采用 损失函数:
abla L_{CE} (\mathbf{w}))$$ 这种方法能强制模型在假阳性率(False Positive Rate)较低的情况下,依然保持极高的灵敏度。 ## 实验战绩:谁是最难啃的骨头? 研究发现,**科学撰写(Scientific Writing)** 是检测的重灾区。由于科学文本本身就具有一定的结构化和严谨性,AI 的模仿成本极低,导致平均 AUC 仅为 0.975,且方差巨大。 而在 LLM 横向对比中,OpenAI 展现出了统治级的伪装能力。 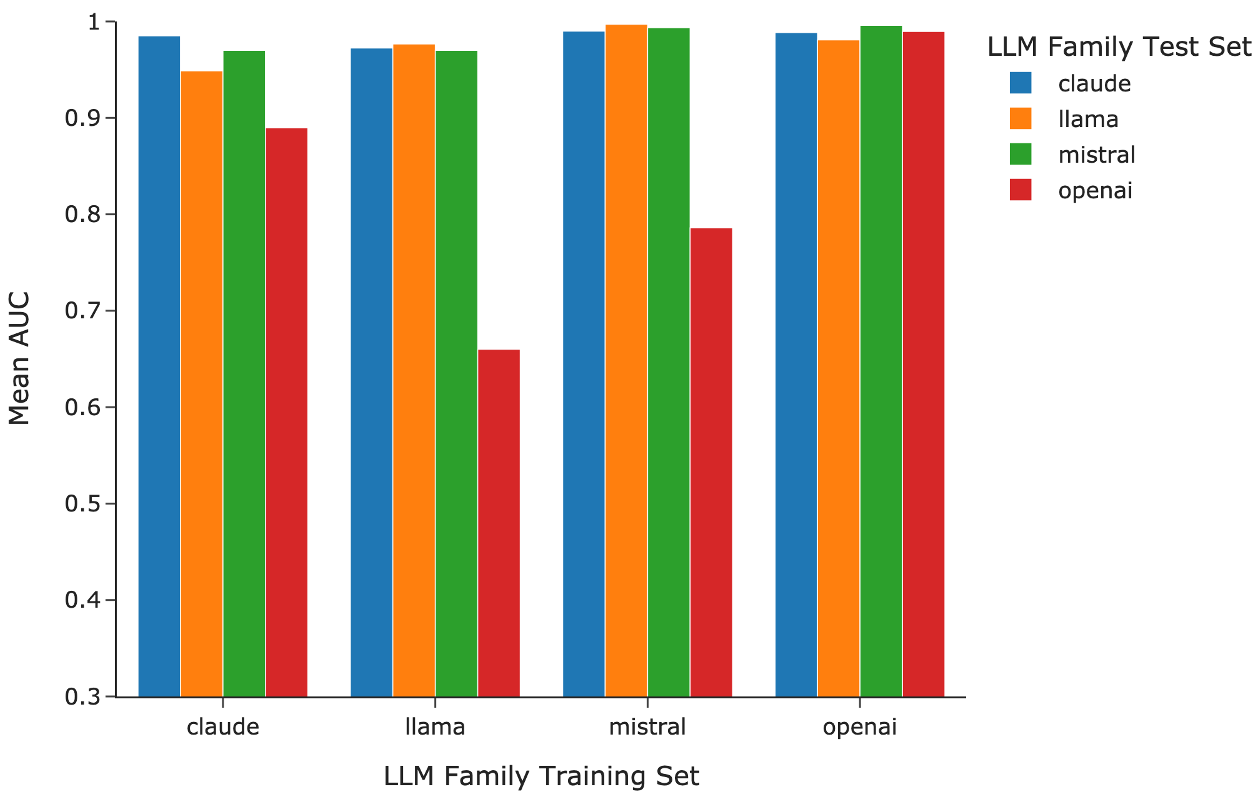 从上图可以看出,除了 OpenAI 亲自下场“左右互搏”(用 OpenAI 数据训练检测器),其他所有非 OpenAI 家族(如 Llama2, Mistral)训练出来的检测器在面对 GPT-3.5/4o 时,性能都出现了断崖式下跌。 ## 物理直觉:OpenAI 赢在哪? 作者通过 **Shannon Entropy(香农熵)** 和 **OOV Ratio(词汇外比例)** 揭示了底层特征: 1. **高熵特征**:人类文本的熵值通常很高,意味着词汇选择丰富多样。如图 4 所示,OpenAI 的文本熵曲线比其他 AI 模型显著向右(高熵方向)偏移,疯狂向人类靠拢。 2. **词汇模仿**:OpenAI 似乎学会了“借用”人类写作中的不常用词汇(低 OOV 比例),使其文本在统计学特征上几乎与人类论文重合。 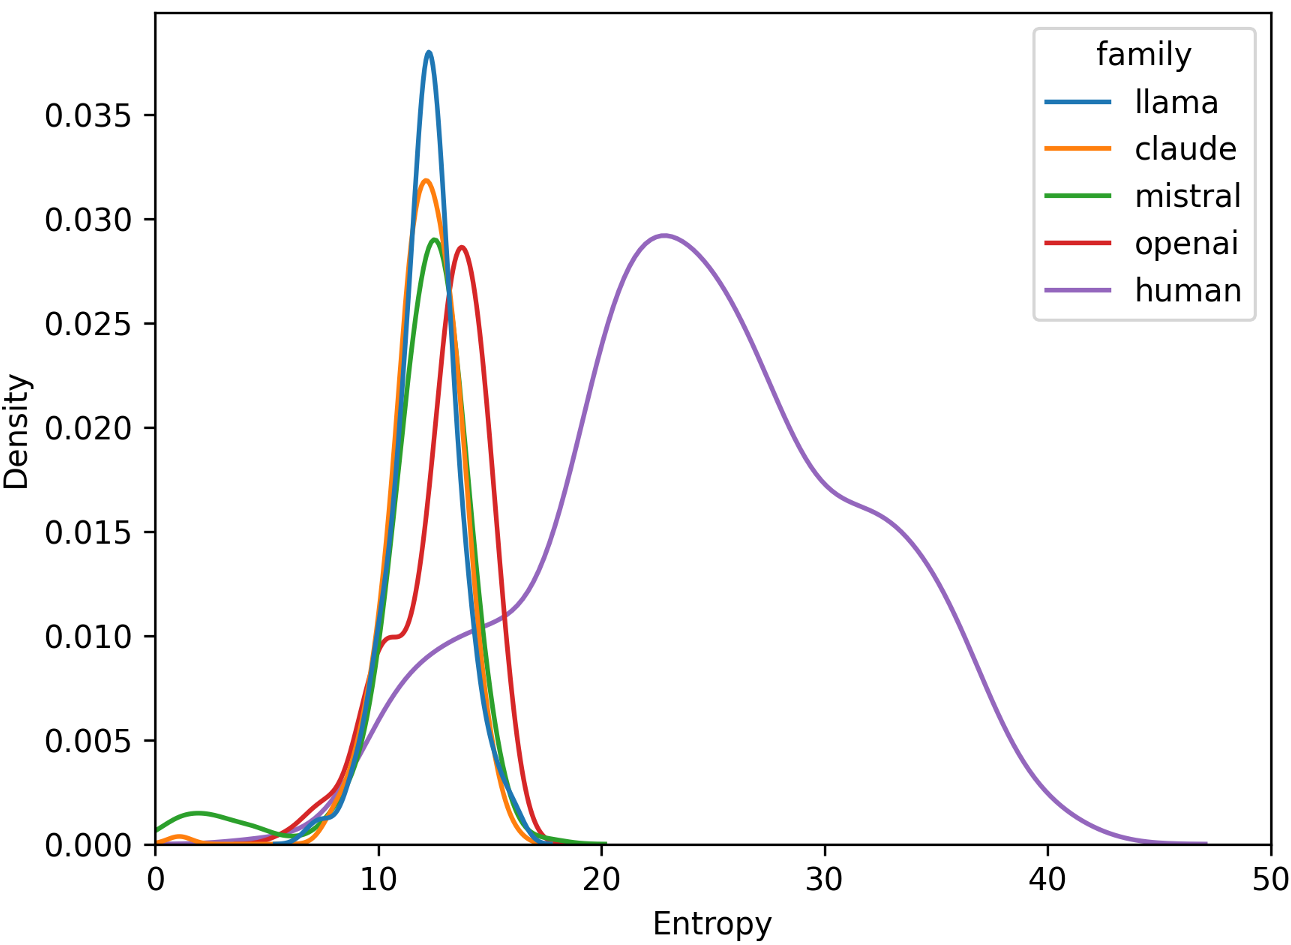 ## 总结与未来展望 **核心贡献**:本文证明了 AIG 检测具高度的模型特异性。仅仅训练一个通用的分类器是不够的,必须针对性地引入像 OpenAI 这种“高智商模仿者”的数据。 **局限性**:实验主要针对长文本(论文、故事)。对于 Amazon 评论、Twitter 贴文等短文本,其熵值分布会更加重叠,检测难度可能进一步飙升。 **未来启示**:未来的研究不应仅停留在黑盒分类,更应探索如“数字水印(Watermarking)”等主动防御技术,单纯依靠统计特征的二分类器在面对日益进化的高熵 LLM 时,防线正在崩溃。