
[ACL 2025] DiningBench:挑战 VLM 的“美食家”修养,从识别到营养推理的深度进化
DiningBench: A Hierarchical Multi-view Benchmark for Perception and Reasoning in the Dietary Domain
本文推出了 DiningBench,这是一个用于评估视觉语言模型(VLMs)在饮食领域感知与推理能力的层级化多视图基准。该基准涵盖细粒度分类、营养估计和视觉问答(VQA)三大任务,并在多个 SOTA 模型上揭示了视觉辨析与精确营养推理的显著瓶颈。
TL;DR
尽管当前的 Vision-Language Models (VLMs) 在通用场景下表现惊艳,但在面对一盘“烟熏三文鱼沙拉”和“鲜虾三文鱼沙拉”时,它们往往会陷入迷茫。本文提出的 DiningBench 是目前最严苛的饮食领域基准,通过层级化任务(分类 -> 营养估计 -> 逻辑推理)、多视角图像以及基于真实菜单的硬负样本,彻底暴露了模型在细粒度感知、体积推理和多图融合上的短板。
1. 为什么我们需要一个“更难”的食物基准?
传统的食物识别数据集(如 Food-101)通常只是让模型做简单的“连连看”。但在真实餐厅场景中,AI 助理需要解决的是更复杂的问题:
- 细粒度辨析:同一家餐厅的两种沙拉,配料可能只有 10% 的差别,模型能否通过视觉特征而非标签名称来区分?
- 多视角融合:从正面看是一盘沙拉,从侧面看才能发现藏在底部的厚实牛排。模型能否整合多张图的信息?
- 量化推理:估计卡路里不是靠猜,而是需要从 2D 效果图中推断出 3D 物理体积(Volumetric Reasoning),这对现有的 Transformer 架构是巨大挑战。
2. DiningBench 的核心架构:三层认知塔
作者设计了一个严谨的认知层级,逐步测试 VLMs 的极限:
- Fine-Grained Classification (识别):
- 创新点:不再随机抽样。利用 Gemini 辅助,从同一商户的菜单中提取视觉和语义最相似的菜品作为干扰项(Hard Negatives)。
- Nutrition Estimation (量化):
- 创新点:回归任务。要求模型输出热量、碳水、蛋白质和脂肪的定量数值。这测试了模型的物理感知能力。
- Visual Question Answering (推理):
- 创新点:涉及烹饪工艺判断、饮食建议、反事实推理等高阶逻辑。
 图 1:DiningBench 的层级评价体系:从识别到量化,再到高阶推理
3. 实验发现:VLM 的“软肋”在哪里?
研究团队评估了包括 GPT-4o, Gemini 3 以及 Qwen-2.5-VL 在内的 29 个顶尖模型,得出了几个打破直觉的结论:
3.1 营养估计:目前的 VLM 仍是“视觉盲区”
即使是表现最好的 Gemini-3-Pro-Preview,在营养估计任务上的平均误差(MAPE)也达到了 24.45%,而 GPT-4o 的误差甚至高达 42.43%。模型往往分不清“小食”和“主菜”的体积差异,经常在 2D 到 3D 的映射中产生幻觉。
3.2 视角越多越好吗?
实验显示(见图 4),当输入视角从 1 张增加到 2 张时,性能有质的飞跃(由于通过侧面解决了遮挡问题)。然而,当图像超过 3 张时,由于当前的 Architecture 难以有效聚合冲突信息,冗余的图片反而可能变成“噪声”,导致性能平台期甚至下降。
 图 2:DiningBench 的数据构建流水线
3.3 CoT 并不总是灵丹妙药
在 VQA 任务中,链式思考(Chain-of-Thought, CoT)能帮助模型梳理逻辑;但在营养估计这种直接依赖视觉感知(Visual Grounding)的任务中,CoT 往往会导致模型“想太多”——模型会通过错误的推理步骤,把自己带入误区,导致性能崩溃(Performance Collapse)。
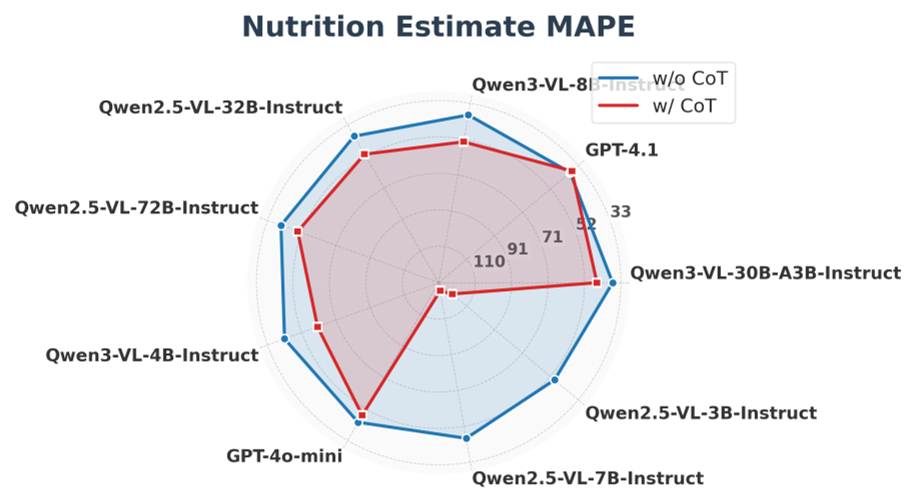 图 3:雷达图显示 CoT 往往会增加回归任务的 MAPE 误差
4. 深度洞察:为什么 VLM 会失败?
作者总结了五个主要的失败模式(Failure Modes):
- Bag-of-features 陷阱:模型只是检测到了“红色的肉”和“土豆”,但忽略了切块方式、烹饪成熟度等关键细粒度信息。
- 参数知识偏见:模型倾向于选择预训练语料中出现频率高的菜名(如烤鸡),即使图片中明显是更少见的葱油鸡。
- 空间体积推理匮乏:缺乏对物理世界的尺度感(Scale Awareness)。
5. 总结与未来启示
DiningBench 的意义在于它不仅仅是一个榜单,它为多模态模型指明了方向:
- 视觉接地(Visual Grounding)需强化:模型必须从“语义匹配”转变为真正的“物理观察”。
- 多视角聚合方案:如何处理多图之间的冗余与互补?
- 领域知识集成:饮食建议不仅是视觉问题,更是领域知识图谱与视觉特征的深度解耦。
DiningBench 为下一代具备物理常识的 AI 助手铺平了道路。对于开发者而言,如何在模型容量受限的情况下,通过有效的多图 Token 压缩和空间编码来提升体积推理能力,将是下一个技术高地。