
别再被 Pass@k 误导:Bayes@N 开启 LLM 评估的贝叶斯时代
Don't Pass@k: A Bayesian Framework for Large Language Model Evaluation
本文提出了 Bayes@N,一个基于狄利克雷分布(Dirichlet Prior)的贝叶斯 LLM 评估框架。该框架旨在替代不稳定的 Pass@k 指标,通过后验估计模型成功概率及置信区间(Credible Intervals),实现了在数学推理任务(如 AIME, HMMT)中更快速的排名收敛与鲁棒的性能评估。
TL;DR
在 LLM 领域,Pass@k 是衡量推理能力的“金标准”,但它极其昂贵且不稳定。近日,来自凯斯西储大学的研究者提出了 Bayes@N 框架。它通过贝叶斯推断取代了简单的频率统计,不仅收敛速度比 Pass@k 快了近一倍,还能通过闭式解直接给出置信区间(Credible Intervals),一举解决了“排行榜刷榜水分多”和“评估计算成本高”两大痛点。
痛点深挖:Pass@k 的“数字游戏”
目前的 LLM 评估(尤其是数学推理 AIME 或编程任务)存在三个核心局限:
- 高方差:当采样次数 较小时,Pass@k 估计值抖动剧烈,模型排名经常随随机种子变化。
- 信息流失:传统的 0/1 判定忽略了模型的中间过程。一个“答案正确但格式错误”的模型和一个“完全胡言乱语”的模型在 Pass@k 眼里是一样的。
- 缺乏显著性结论:当两个模型得分相差 1% 时,评估者很难判断这是真实能力差距还是噪声。
核心机制:从计数到推断
作者的直觉非常精妙:将每一次模型生成的评估看作是从一个多维分布中抽样。
1. Dirichlet 建模
不同于二项分布,作者采用了 Dirichlet 分布(多项分布的共轭先验)。这意味着评估不再仅仅是“对”或“错”,而是可以划分为 个类别(如:完全正确、部分正确、格式错误、拒答等)。
2. 闭式解的高效性
由于使用了共轭先验,计算后验均值 和方差 不需要任何 Monte Carlo 采样,直接套公式即可得出。这使得在推理过程中实时监控“置信区间”成为可能:如果两个模型的区间重叠,我们就知道还没比出胜负,需要继续采样。
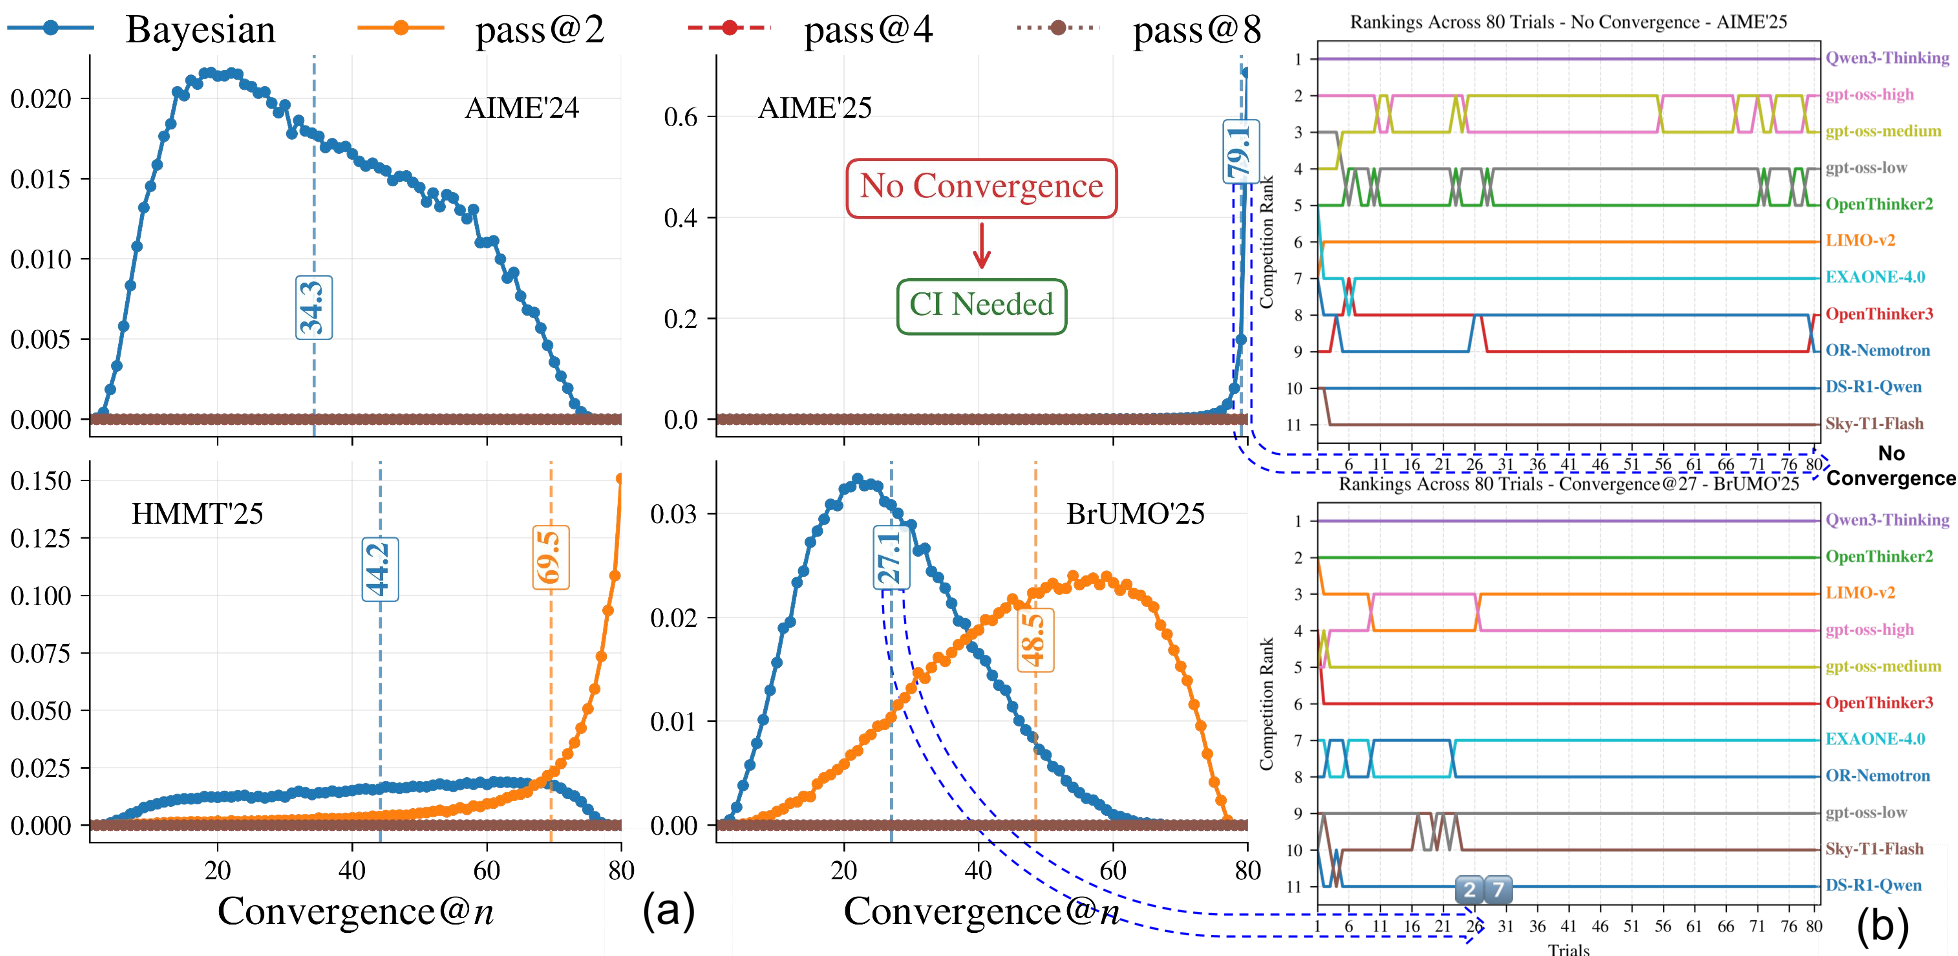 图中展示了在不同数学数据集下,Bayes@N (绿色) 的排名相关性收敛速度显著快于 Pass@k 系列。
实验战绩:更少样本,更稳排名
研究团队在 AIME'24/25, HMMT'25 等高难度竞赛数据集上测试了包括 Qwen3、DeepSeek、GPT-OSS 在内的 20 个模型。
- 收敛效率:在 HMMT'25 数据集上,Bayes@N 平均只需 44.2 次试验即可稳定排名,而最好的 Pass@k 变体需要约 69.5 次。
- 排名稳定性:Bayes@N 能够清晰识别出统计学上的“平局”。如下图所示,虽然某些模型点估计得分略高,但置信区间的重叠提醒我们这种领先并不稳固。
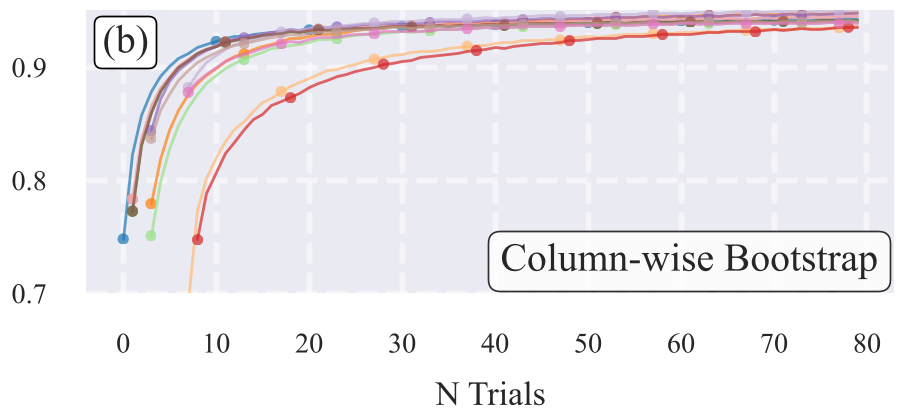 实验对比证明,引入非均匀先验(Non-uniform Prior,如在微调前使用 base 模型的数据作为先验)能进一步提升收敛速度。
深度洞察:Rubric-Aware(多维维度评价)
这是本文最具启发性的部分。通过自定义权重向量 ,Bayes@N 允许开发者定义自己的评估偏好。
- 效率权重:如果模型推理字数过多,可以给予一定的惩罚。
- 格式检查:未按 Boxed 格式输出答案的正确项将被降权。 这种灵活性对于研发“推理型 LLM”(Reasoning LLMs)至关重要,因为它能更精细地引导 RLDF(基于发现的强化学习)的方向。
总结与局限
Bayes@N 为 LLM 评估提供了一套工业级的、数学严密的工具箱。它告诉我们:评估不只是看最终得分,更要看得分背后的不确定性。
然而,该方法也存在局限:它高度依赖于 Rubric 的设计。如果评估标准(评价脚本或判分模型)本身存在偏见,贝叶斯框架也无法修补这种偏差。
未来,该技术路线有望与“推理侧 Scaling Law”结合,通过动态调整采样次数,在保证评估精度的前提下极大降低算力成本。
关键词:LLM Evaluation, Bayesian Inference, Dirichlet Distribution, Pass@k, Math Reasoning.