
EMBODIEDBENCH:具身智能体的“期末考试”,MLLM 真的能读懂物理世界吗?
Embodiedbench: Comprehensive benchmarking multi-modal large language models for vision-driven embodied agents
本文推出了 EMBODIEDBENCH,这是一个针对多模态大语言模型(MLLMs)具身智能体设计的综合评测基准。它涵盖了从高层语义任务到低层原子操作的 1,128 个测试任务,横跨家政、导航、操纵等四个环境,是目前评估视野驱动(Vision-Driven)具身智能体最完善的架构之一。
TL;DR
尽管多模态大模型(MLLM)在图文对话上表现惊艳,但在真实的具身(Embodied)环境下,它们表现如何?来自多所顶尖高校的研究团队推出了 EMBODIEDBENCH。通过对 24 款主流模型(如 GPT-4o, Claude-3.7, InternVL3)的深度测评,发现即便是最强大的模型在面对机械臂操纵时准确率也惨不忍睹(不足 30%)。本文不仅提供了一个高难度的评测集,还揭示了具身智能体设计中的核心痛点。
具身智能的迷思:擅长规划,败于执行
长久以来,LLM 被用作具身机器人的“大脑”负责高层规划(例如:把洗好的生菜放进冰箱)。然而,当任务下放到具体的“低层动作”(Low-level Actions)时,如“向左旋转 10 度”或“移动机械臂至坐标 (x, y, z)”,纯语言模型就显得捉襟见肘。
现有评测工具(如 ALFWorld)往往禁用了多模态输入,或者仅仅考察模型的语义理解。EMBODIEDBENCH 的出现填补了这一空白,它强调 视野驱动(Vision-Driven),要求智能体必须通过第一视角(Egocentric View)图像来实时感知环境并做出动作响应。
核心方法:统一的具身架构与能力解耦
为了科学评测,作者将任务细分为 6 种核心能力:基础任务、常识推理、复杂指令理解、空间意识、视觉感知以及长时程规划。
1. 任务分级:高层 vs 低层
- High-level (EB-ALFRED, EB-Habitat): 侧重语义分解,如“清理厨房”。
- Low-level (EB-Navigation, EB-Manipulation): 侧重物理精度,需要模型输出离散化的坐标和旋转矢量。
2. 智能体管线设计
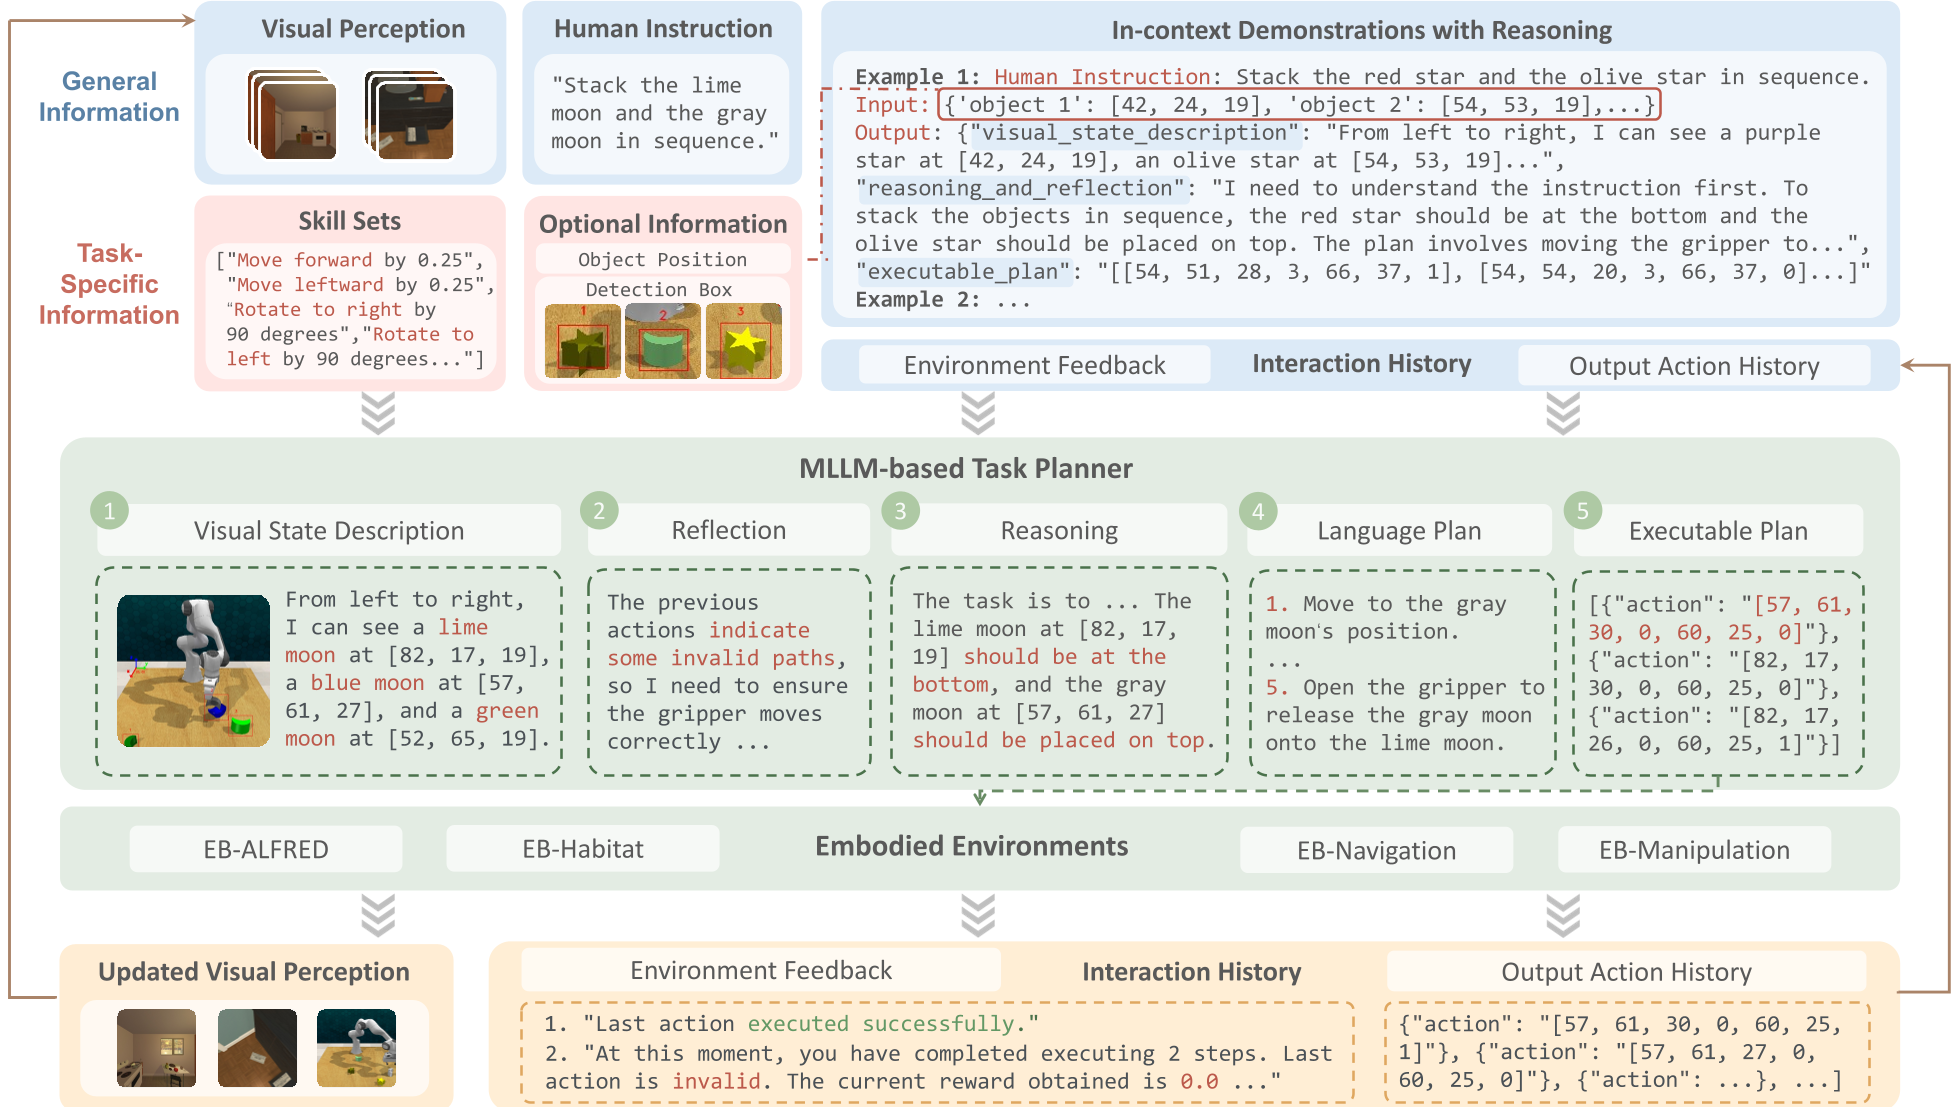
作者设计了一个标准的具身 Planner 流程(见下图):
- 视觉描述:模型先用文字描述看到的画面(状态提取)。
- 反思与推理:结合历史失败反馈。
- 输出规划:生成 JSON 格式的可执行指令流。
实验发现:谁才是最强“打工人”?
评估涉及了从 7B 到 90B 的开源模型(如 Qwen2.5-VL, InternVL3)以及顶级商业闭源模型。
关键结果对比:
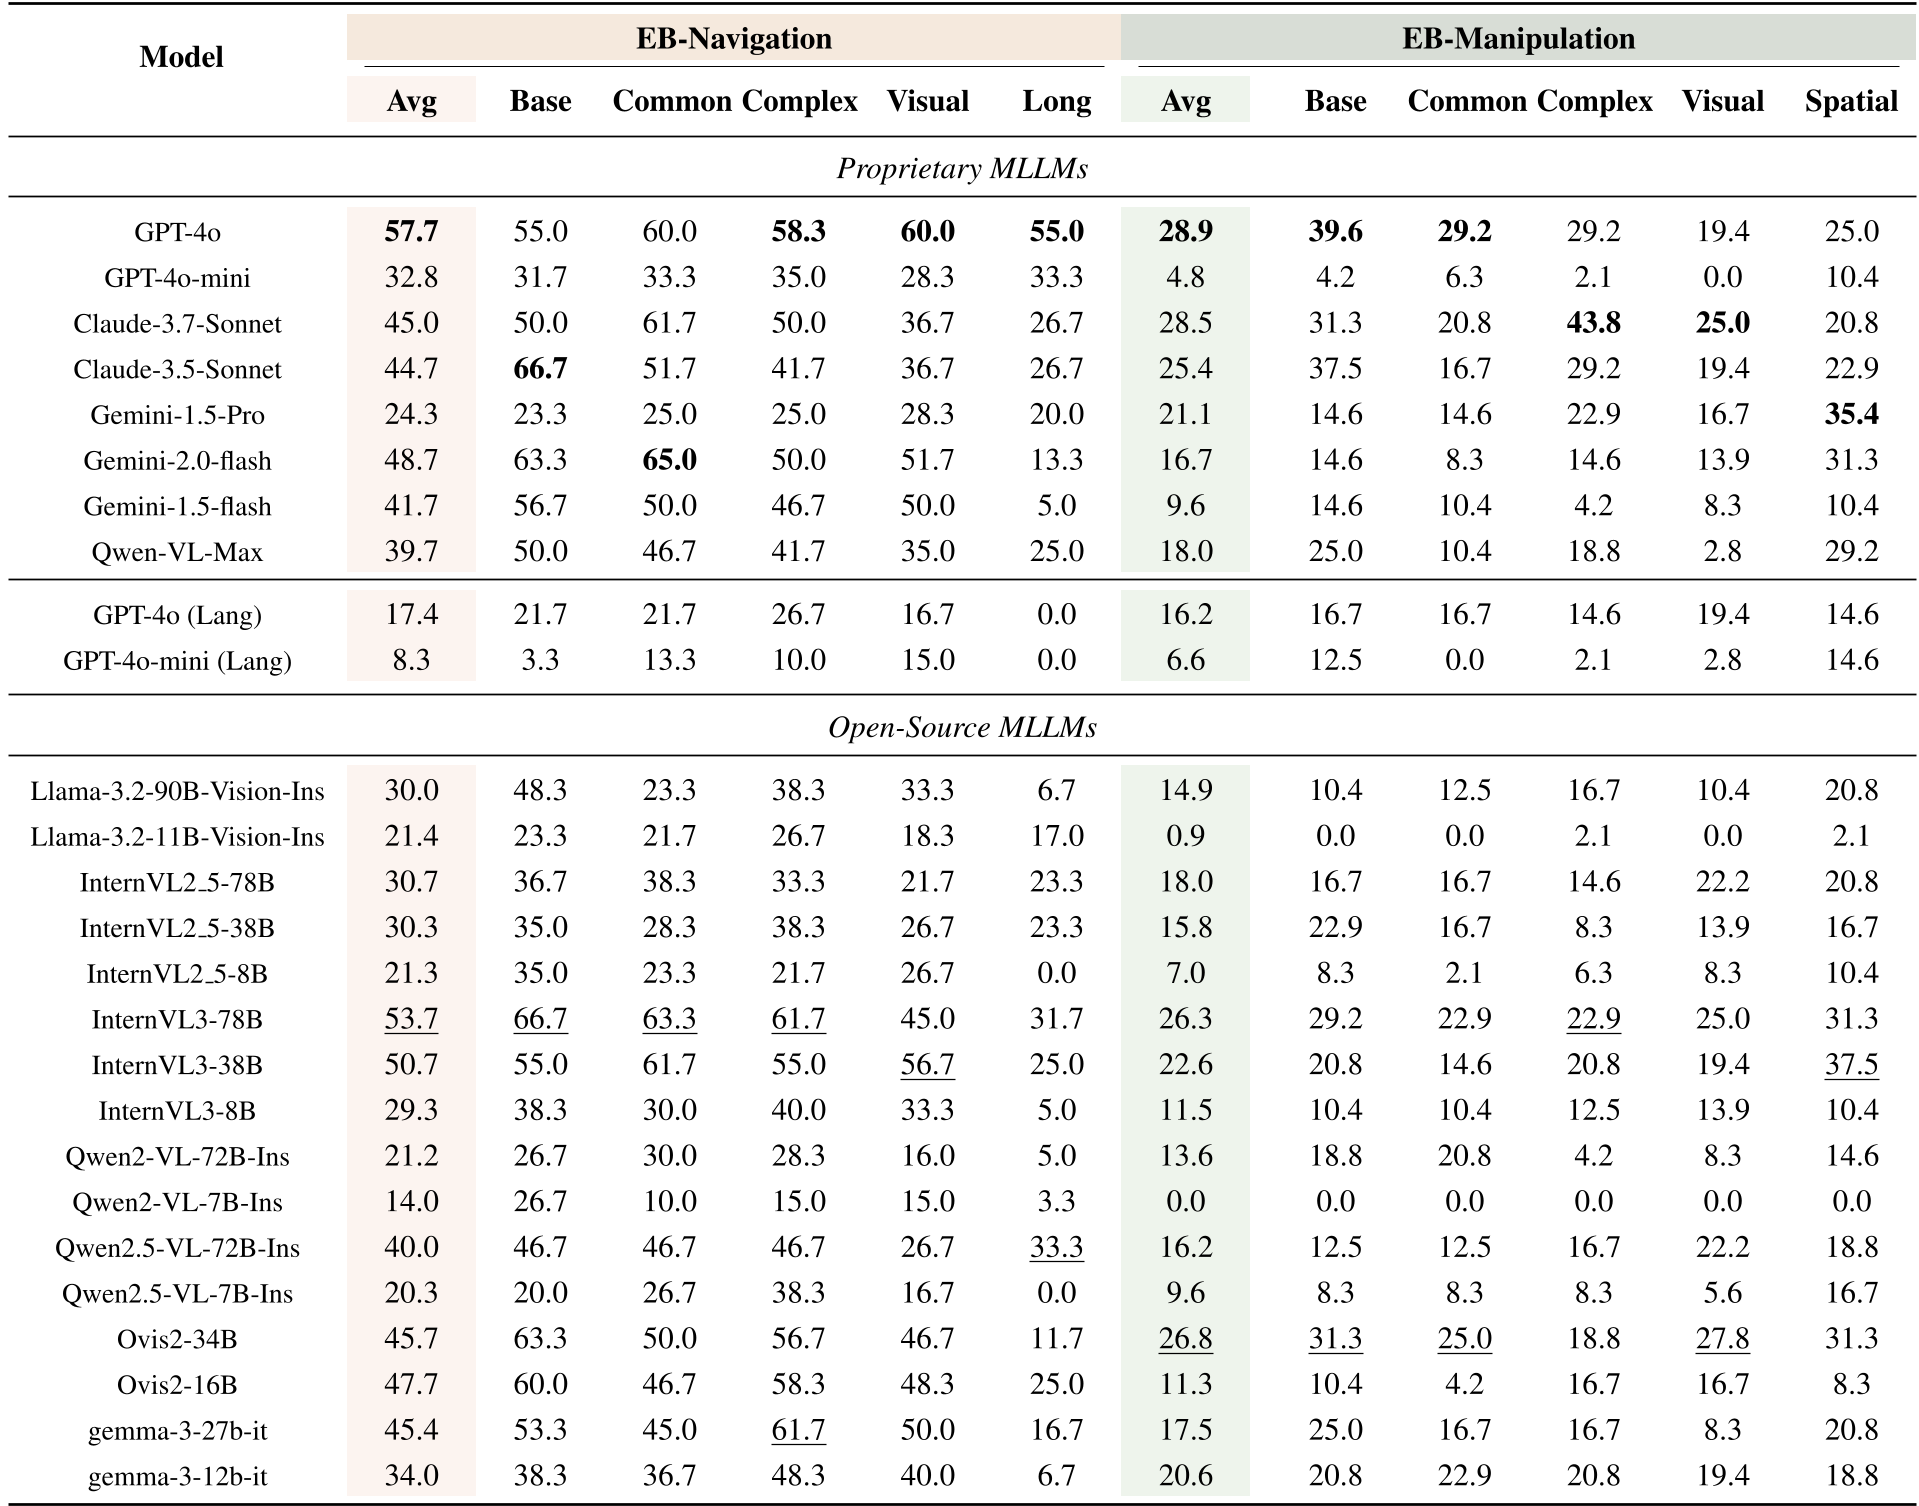
- 商业模型统治力:Claude-3.5-Sonnet 是“语义大师”,在高层任务中夺冠;GPT-4o 则是“操作之王”,在需要物理感知的低层任务中领先。
- 开源力量追赶:InternVL3-78B 展现了极强的性价比,在多个低层指标上直逼 GPT-4o。
深度洞察:
- 视觉重要性非对称:在低层任务中,禁止视觉输入会导致性能彻底“崩盘”(下降 70%);但在高层任务中,纯文字描述(Lang-only)有时甚至比带图模型表现更好——这反映了当前 MLLM 在高层任务中倾向于依赖语义先验而非视觉实况。
- 长时程规划之痛:随着任务步数增加,模型出错率呈指数级上升。GPT-4o 在长时程任务下也经常出现“过早终止”或“循环动作”的逻辑错误。
- 视觉 ICL 的惊喜:实验发现,在 Prompt 中加入带图片的示例(Visual In-context Learning)比纯文字示例更能显著提升机械臂操纵的成功率。
深度思考:未来的具身智能体需要什么?
通过对失败案例的分析(Error Analysis),作者指出当前最严重的错误来源是 感知错误(Perception Error)。即使提供了检测框(Detection Box),模型仍会认错颜色、误判深度。
这篇工作告诉我们:
- 不要盲目追求高分辨率:实验显示 500x500 的分辨率性能最稳,过高分辨率反而会引入噪声干扰模型推理。
- 多视角与时序理解仍是难点:同时输入多张历史图片或多视角图片(如腕部相机),往往会把现在的模型“绕晕”,性能不升反降。
总结
EMBODIEDBENCH 不仅仅是一个更难的榜单,它实际上为具身模型提出了明确的进化方向:更强的空间表征能力、更敏锐的闭环反馈机制、以及能够从物理演示中直接学习的 Visual-ICL 能力。对于想要开发实用机器人的团队来说,这篇论文是理解 MLLM 落地局限性的必读之作。