
[ICLR 2025 潜力作] 进化策略 (ES) 的逆袭:大模型微调跳出强化学习的“梯度陷阱”
Evolution strategies at scale: Llm fine-tuning beyond reinforcement learning
本文提出了第一个将进化策略(Evolution Strategies, ES)扩展至数十亿参数规模 LLM 全参数微调的方法。通过这种无须反向传播(Backpropagation-free)的零阶优化范式,该方法在推理任务及复杂谜题求解上达到了与主流强化学习(RL)微调方法持平或更优的性能。
TL;DR
长期以来,大语言模型(LLM)的微调被认为是强化学习(RL)的天下,而**进化策略(ES)**因其“不借助梯度”的特性被贴上了“无法扩展”的标签。本文打破了这一偏见,首次证明了直接在数十亿参数空间进行 ES 搜索不仅可行,而且在稳定性、抗奖励作弊和处理复杂逻辑(如 ARC-AGI)方面完胜传统 RL。
背景定位
在 LLM 的后训练(Post-training)阶段,无论是 PPO 还是最近火热的 GRPO,本质上都是在动作空间(Token 概率分布)进行探索。而本文将目光回溯到零阶优化——进化策略,直接在参数空间进行“抖动”。这篇文章是该领域的里程碑,标志着 ES 正式具备了与梯度派系在高参数维度上一较高下的能力。
痛点深挖:RL 微调的“阿喀琉斯之踵”
- 梯度方差灾难:在面对只有最终结果(Outcome-only)的稀疏奖励任务时,基于动作空间的采样会导致梯度估计波动剧烈。
- 奖励作弊 (Reward Hacking):RL 往往会为了高分产生一些无意义的符号(如在追求简洁性任务中退化为乱码)。
- 脆弱的稳定性:同样的超参数,换个随机种子可能结果天差地别。
核心方法:如何在内存不足的情况下“进化”几十亿参数?
作者提出了一套极其精妙的工程实现:
- 种子即噪声:不直接存储扰动后的庞大参数,而是通过重置随机种子动态生成高斯噪声。
- 层级原位更新:逐层进行参数扰动、评估、再还原,确保显存占用仅略高于推理。
- 参数空间的平滑化:不同于 RL 在每个 Token 步注入噪声,ES 在参数空间注入噪声相当于对奖励函数进行了“高斯卷积”,本质上平滑了崎岖的 Loss Landscape。
 上图展示了算法伪代码:通过简单的随机种子管理和层级更新实现大规模扩展。
实验战绩:突破 ARC-AGI 的天花板
实验结果不仅在 Countdown、Sudoku 等逻辑谜题中碾压 RL,最令人振奋的是在 ARC-AGI(被公认为衡量通用人工智能灵活性的最难基准之一)上的表现。
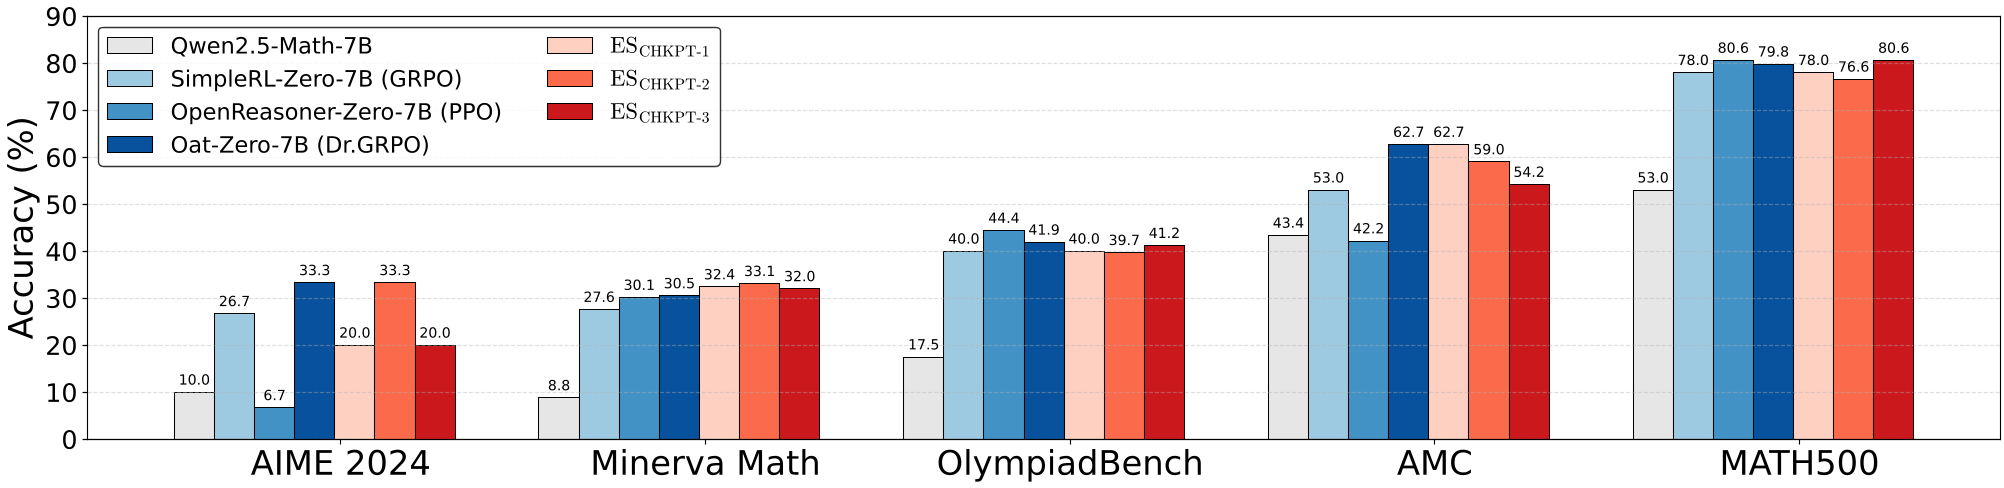 可以看到,即使是未经复杂调优的 Vanilla ES,在多项数学推理任务上也达到了 SOTA RL 基线(如 Oat-Zero, OpenReasoner)的水平。
为什么 ES 表现更好?
- 不“作弊”:在简洁性微调实验中,ES 生成的答案不仅简练且逻辑正确,而 GRPO 在相同参数下往往会崩溃成乱码。
- 低方差:参数空间探索通过一次采样决定整条回答路径,极大地降低了训练的波动。
深度洞察:30 个样本就能优化 70 亿参数?
本文最让人困惑也最兴奋的发现是:以往 ES 需要上万种群数量,但微调 LLM 竟然只需要 N=30。 主编点评:这很可能与 LLM 的“低本征维度(Intrinsic Dimensionality)”有关。尽管预训练模型有几十亿参数,但任务适配所需的有效自由度其实极低。ES 正好避开了高维梯度的噪声,直接在低维流形上捕捉到了有效的搜索方向。
总结与未来展望
本文建立了一个关键里程碑:分布式进化策略是 LLM 后训练的第二选择,且可能是通往超人工智能(Superintelligence)的必经之路。 由于 ES 只需要推理(Inference-only),它与未来专门优化的推理内核、大批量并行推理硬件完美契合。
局限性:目前的 ES 还是 Vanilla 版本,尚未引入 Adam 优化器等动量更新机制。一旦结合这些成熟的优化工具,其上限不可估量。
Takeaway:如果你在处理稀疏奖励、长逻辑推理任务且被 RL 的不稳定性折磨,是时候尝试 Evolution Strategies 了。