
EMF:打破一步生成瓶颈,实现高保真文本到图像合成
Extending One-Step Image Generation from Class Labels to Text via Discriminative Text Representation
本文提出了 EMF (Extending MeanFlow to T2I),首次将基于 MeanFlow 的一步生成框架从简单的类别标签扩展到了复杂的文本条件。通过引入具有高判别性和解耦性的 LLM 文本编码器,该模型在 1-4 步推理下达到了与 30 步基线模型 BLIP3o-NEXT 相当的 SOTA 图像质量。
TL;DR
在生成式 AI 领域,如何在保持高画质的同时缩短采样步骤一直是“圣杯”问题。来自南开大学和阿里巴巴的研究团队提出了 EMF (Extending MeanFlow to T2I),成功将原本仅适用于简单分类标签的 MeanFlow 框架扩展到复杂的文本到图像(T2I)任务。实验表明,EMF 在 1-4 步内的生成效果即可比肩传统模型 30 步的表现。
背景定位:从 Class 到 Text 的鸿沟
传统的 MeanFlow 方法在 ImageNet 类别的生成上表现优异,因为类别标签在嵌入空间中是离散且易于区分的。然而,文本输入(Natural Language)是连续且高度耦合的(例如“蓝色茶壶”与“红色茶壶”在向量空间非常接近)。这种“语义密集性”导致生成模型的**速度场(Velocity Field)**变得极其扭曲,在极少步骤下模型极易“迷路”,产生模糊或语义错误的图像。
核心洞察:什么样的文本特征适合一步生成?
作者提出了评估文本编码器的两个核心维度:
- Discriminability (判别性):文本向量必须与对应的图像向量高度对齐,能够区分细微的语义差别。
- Disentanglement (解耦性):文本向量应保留原始语言的结构,在缩减文本长度时依然能保持核心语义。
研究发现,BLIP3o-NEXT 的文本编码器在这两项指标上远超传统的 CLIP 或 T5,这为 MeanFlow 适配文本任务奠定了理论基础。
方法论:EMF 的架构改进
为了让模型学会预测“平均速度”,EMF 对基础模型进行了微调:
- 双时间调节:不仅输入当前时间 ,还输入目标结束时间 。通过两个独立的时间嵌入层 和 来捕捉区间长度和位置。
- 自洽性学习:利用 Jacobian-vector products (JVP) 技术高效计算导数项,确保模型输出的速度场与真实的平均速度场一致。
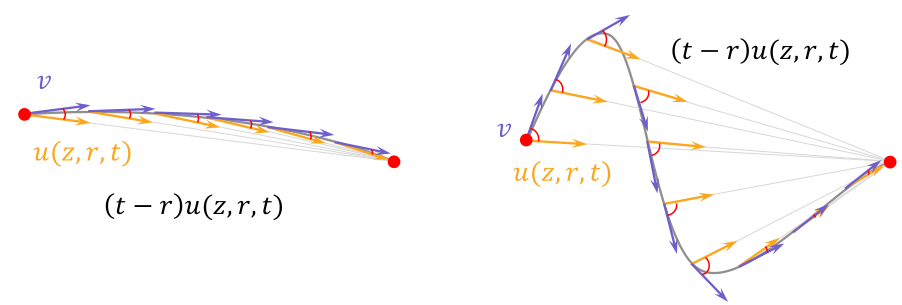 上图展示了类别标签(左)与复杂文本(右)在去噪轨迹上的差异:文本轨迹更加曲折,需要更强的编码器来维持方向。
实验结果:速度与质量的飞跃
EMF 在多个权威榜单上展现了降维打击般的实力:
- GenEval (语义忠实度):EMF 在 4 步采样下获得 0.90 分,而传统蒸馏模型如 Hyper-SDXL 仅为 0.58。
- DPG-Bench (复杂指令遵循):1 步生成的整体得分比基线模型提升了超过 20%。
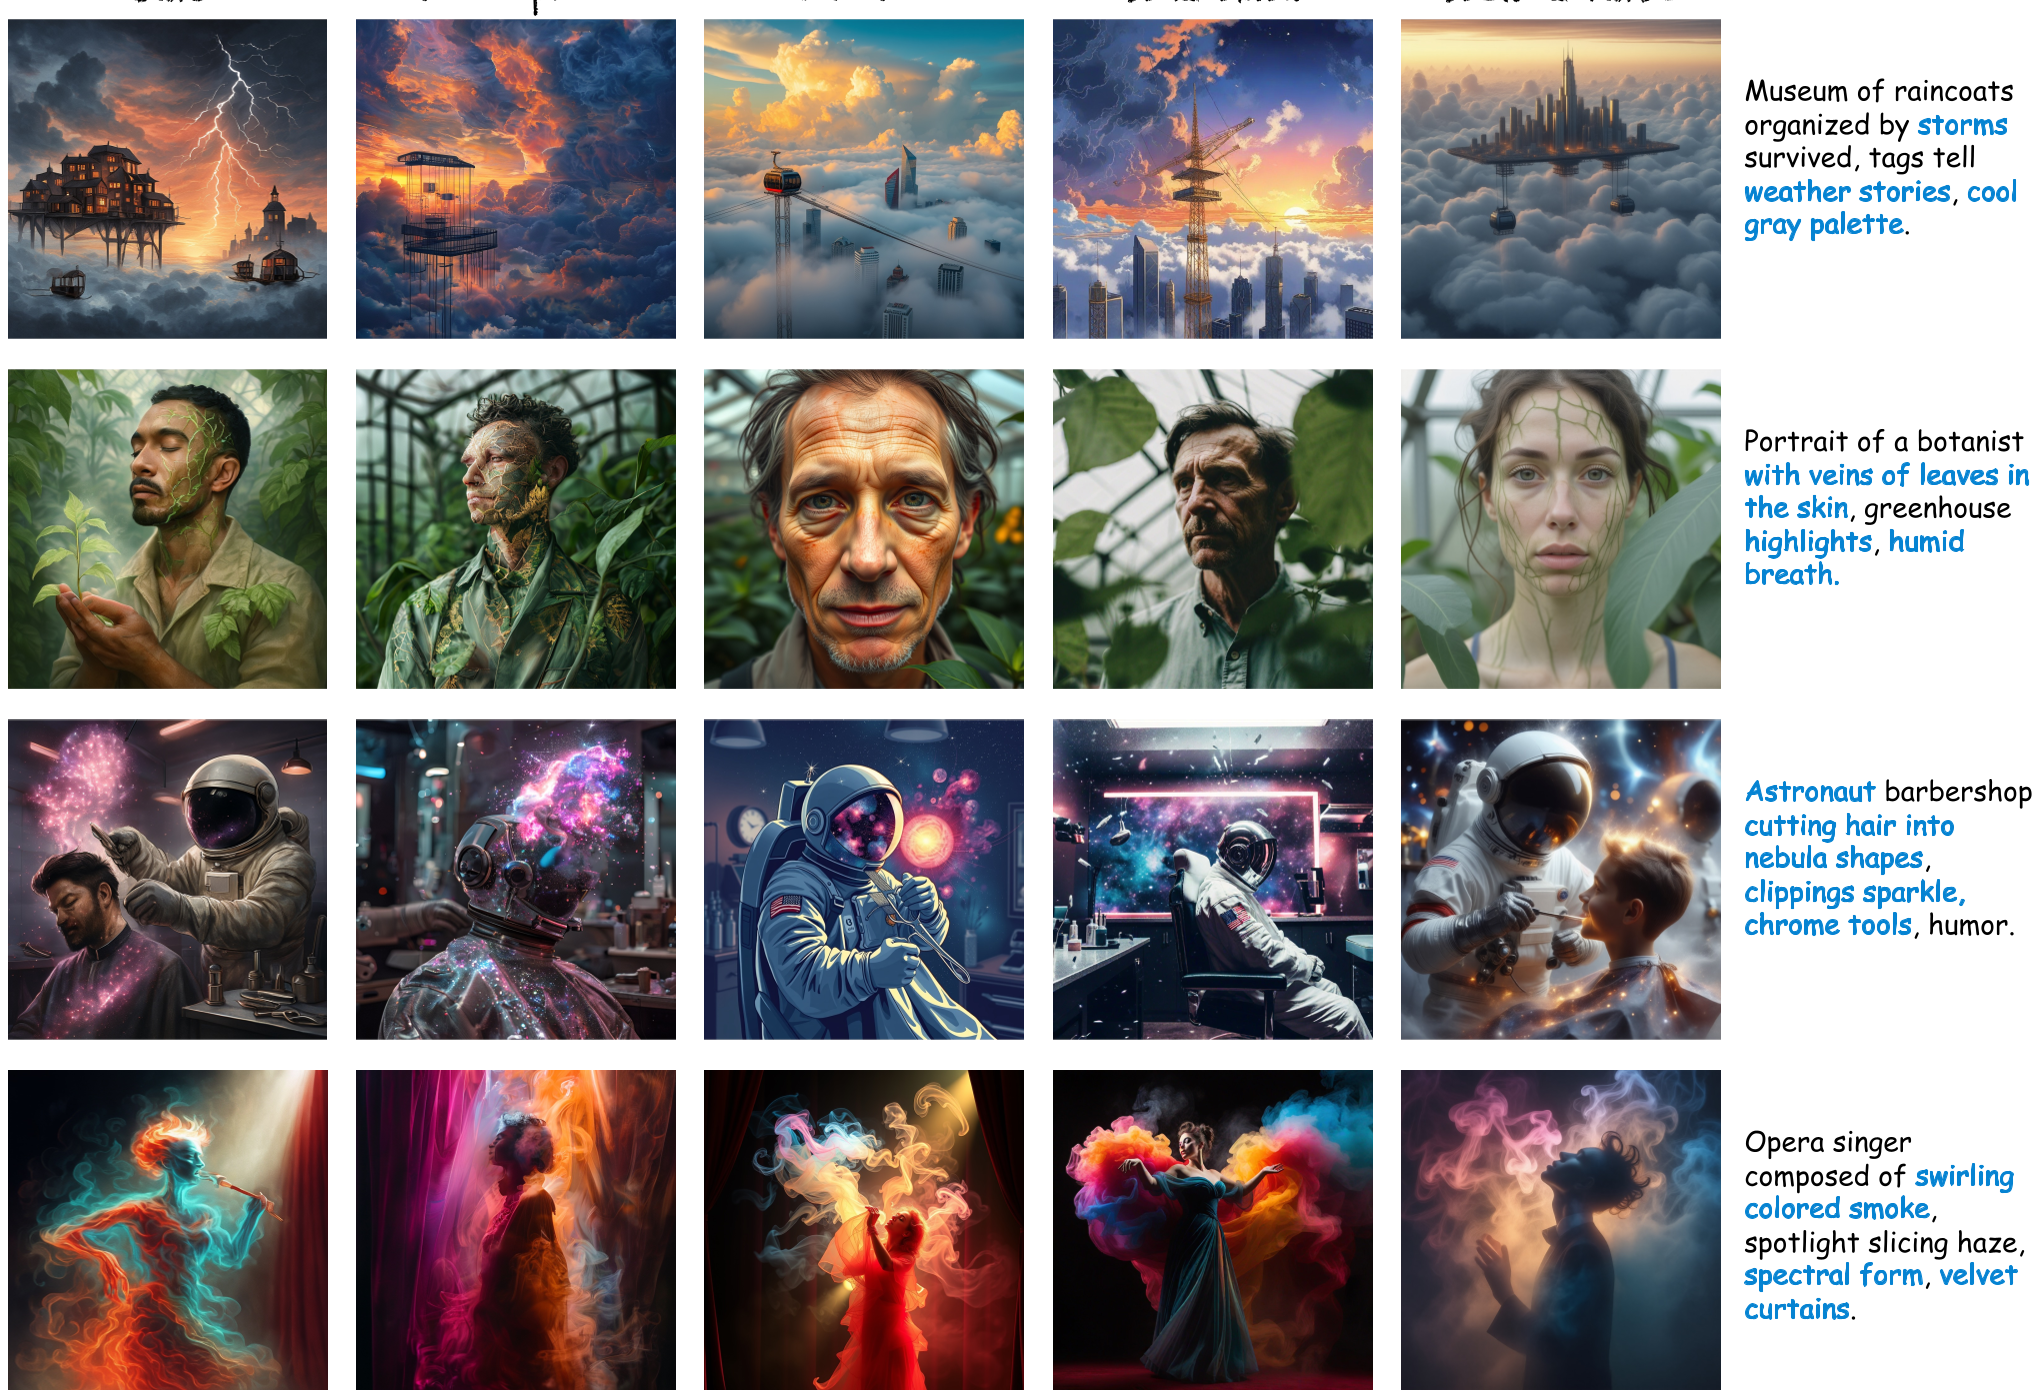 对比图显示,在 4 步推理下,EMF 在处理复杂长描述(如“高空热气球视角的火山喷发”)时,其细节丰富度和属性绑定准确性显著优于 SANA-Sprint 等同行。
总结与局限
EMF 的出现证明了:一步生成的上限很大程度取决于文本理解的底座。
优点:
- 推理速度极快(H200 上仅需 0.08s - 0.22s)。
- 具备良好的可扩展性,增加步数(如 8 步)能持续提升画质,不会像某些蒸馏模型那样出现性能饱和。
局限性:
- 生成总耗时中,文本编码器的自回归生成时间占了大头(约 9s),未来的优化重点可能在于如何加速 LLM 文本特征的提取。
EMF 为未来高效、高语义鲁棒性的生成模型设计提供了清晰的路径:强编码器 + 精准平均速度场建模 = 极致的推理效率。