
FS-Researcher:突破上下文封锁,基于文件系统的深度研究 Scaling 范式
FS-Researcher: Test-Time Scaling for Long-Horizon Research Tasks with File-System-Based Agents
本文提出了 FS-Researcher,一种基于文件系统(File-System)的双智能体框架,旨在解决长程深度研究任务中的上下文限制问题。该方法通过引入持久化工作区,实现了超越模型原生窗口的 Test-time Scaling,在 DeepResearch Bench 和 DeepConsult 等基准测试中达到了 SOTA 水平。
TL;DR
传统的 AI 调研(Deep Research)智能体常常受困于“有限的内存”——Context Window 一旦溢出,之前的思考和证据就会丢失。FS-Researcher 另辟蹊径,借鉴了人类专家的做法:给 AI 配置一个硬盘(文件系统)。通过将任务拆分为“构建知识库”和“撰写报告”两个阶段,FS-Researcher 不仅突破了 Token 限制,还实现了性能随推理成本增加而提升的 Test-time Scaling 效应。
核心速览
- 定位:SOTA 级别的长路径任务智能体框架。
- 痛点:长路径任务(Long-horizon tasks)导致的 Context Window 溢出。
- 方案:基于文件系统的双智能体框架(Context Builder + Report Writer)。
- 成就:在 DeepResearch Bench 击败 OpenAI、Claude 及 Google 的原生 Deep Research 产品。
1. 为什么深度研究不能只靠“大窗口”?
尽管 LLM 的 Context Window 正在向百万级别迈进,但在处理“写一篇 PhD 级别调研报告”这类任务时,依然显得捉襟见肘。
- Token 竞争:原始网页、思维链(CoT)、工具反馈和最终草稿都在抢占有限的 Token,导致深度不足。
- 状态易失:单次推理结束后,智能体之前的思考过程随之消失,无法像人类一样“第二天早上接着写”。
- 缺乏结构:简单的线性对话难以有效组织数百个来源的复杂事实。
2. 核心架构:离线存储与双智能体解耦
FS-Researcher 模仿了人类学者的分工,将其分为两个主要阶段:
2.1 架构设计
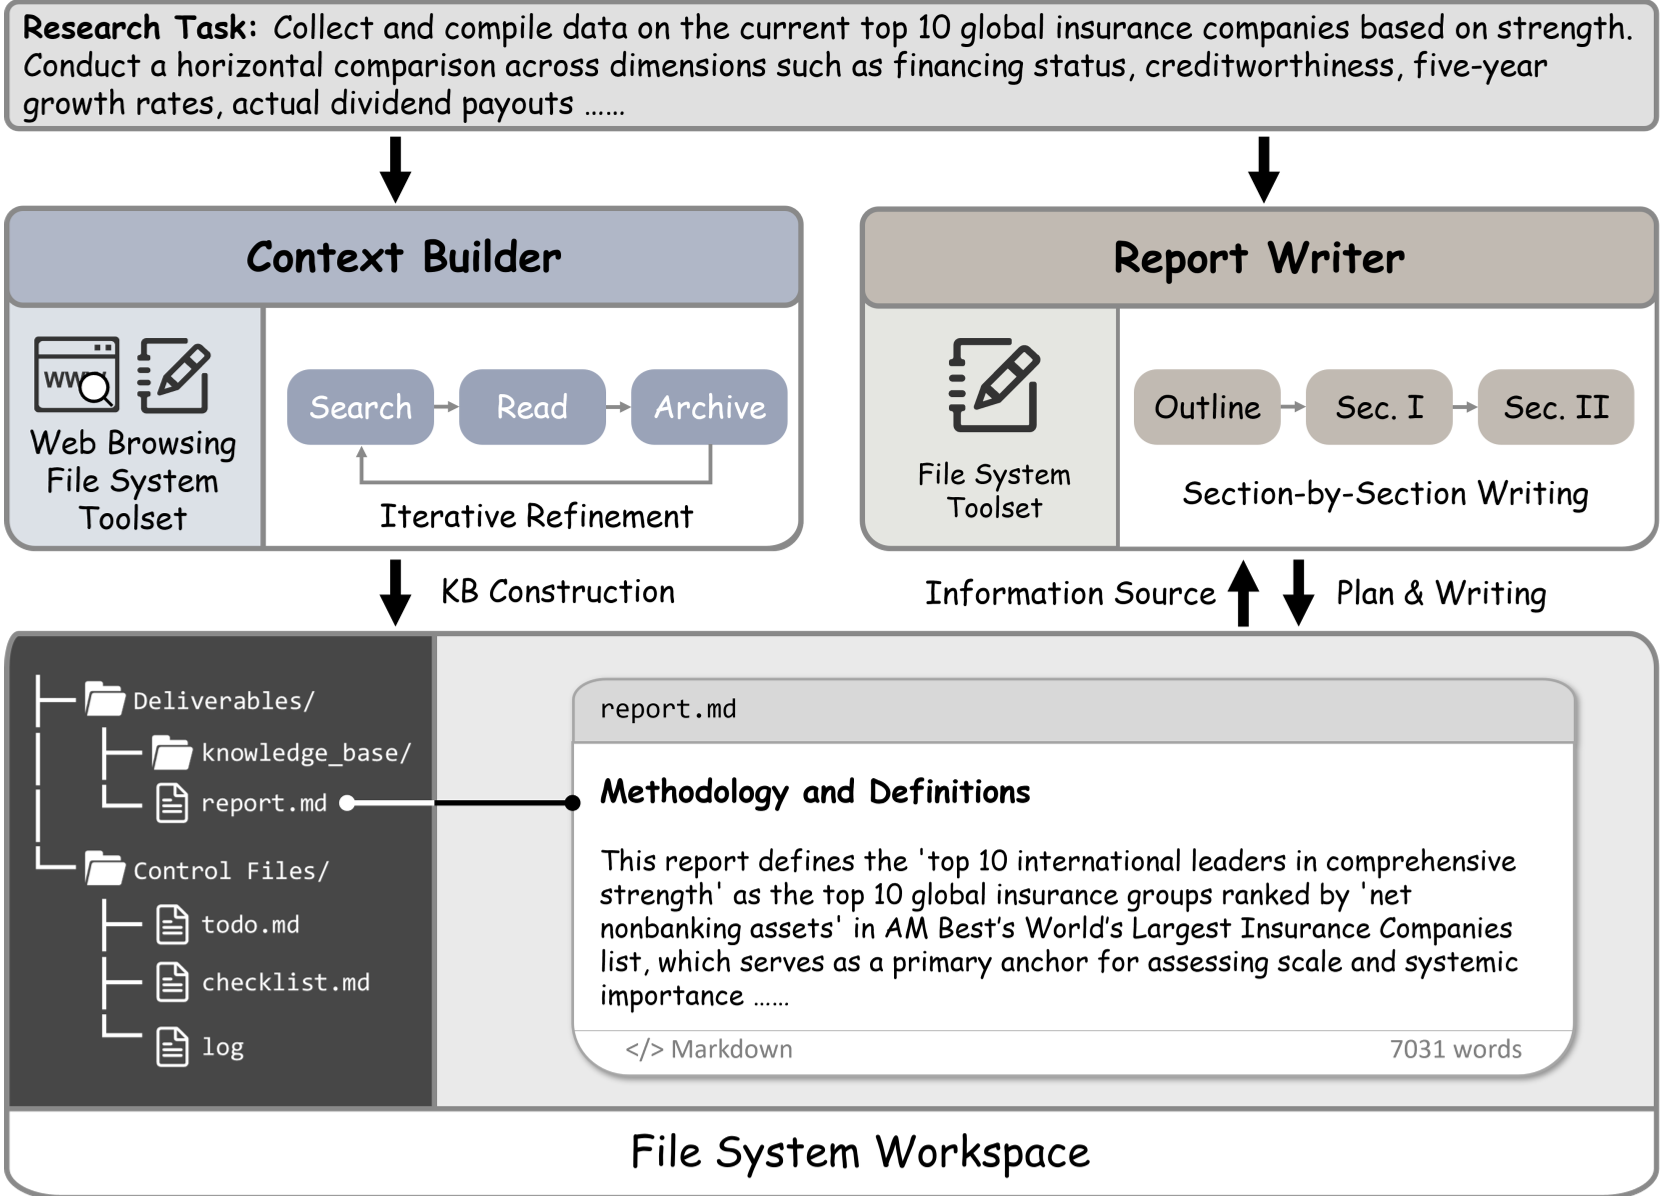
- Context Builder (数字图书馆员):通过 Web 搜索并读取内容,提取核心事实并写入 Markdown 格式的知识库。它不仅下载原始网页(Sources),还撰写分层级的摘要笔记(Notes)。
- Report Writer (资深分析师):从文件系统中按需读取知识库,唯一专注于撰写逻辑严密的报告。
下图展示了 FS-Researcher 与现有范式的本质区别:
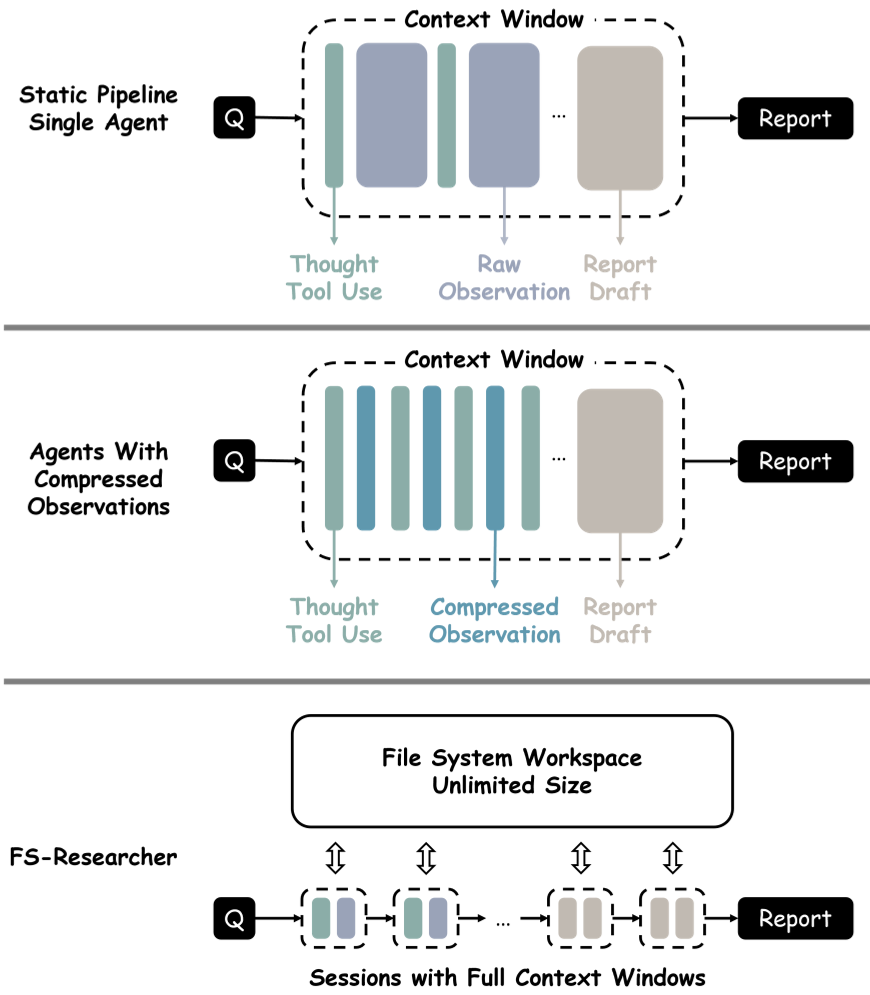 (底部展示了 FS-Researcher 如何利用无限大小的外部文件系统作为上下文外延。)
2.2 持久化工作区
文件系统(Workspace)包含了两类关键文件:
- 成果物(Deliverables):分层生成的知识库索引和 Markdown 报告。
- 控制文件(Control Files):包括
Todos(跟踪进度)、Checklist(自查标准)和Logs(运行日志)。这让智能体哪怕崩溃重启,也能通过读取文件“找回状态”。
3. 实验结果:Test-time Scaling 的力量
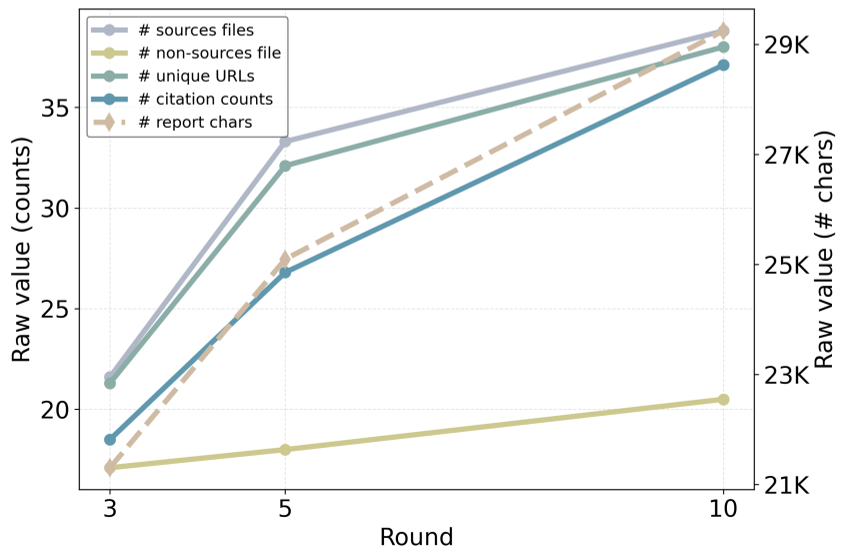
FS-Researcher 在 DeepResearch Bench 上的表现令人印象深刻。最关键的发现是:给 Context Builder 分配更多的迭代轮数(计算资源),最终报告的质量会线性提升。
3.1 性能对比
在 RACE(综合评估)和 FACT(事实准确性)指向上,FS-Researcher 超越了主流厂商产品:
- Comprehensiveness (全面性) 和 Insight (洞察力) 提升尤为明显,分别比之前的 baseline 高出 3.74 和 4.4 分。
- Scaling 验证:下表显示,当 Context Builder 的运行轮数从 3 轮增加到 10 轮时,归档的证据量和报告的深度显著增长。
4. 深度洞察:为什么这有效?
- 信噪比隔离:Context Builder 充当了“噪声过滤器”。最终 Report Writer 处理的是经过整理的结构化 Markdown,而不是杂乱的 HTML 原始文本,这极大地降低了模型处理长文本时的幻觉风险。
- 分章节撰写 (Section-wise Writing):作者通过消融实验证明,按章节撰写并进行针对性自查,比“一气呵成”产生的报告在逻辑深度(Insight)上高出 8.8 分。
- IO 开销可忽略:很多人担心文件系统会慢,但统计显示文件读写时间占总时长的比例小于 0.03%,真正的大头依然是网络检索和模型推理。
5. 局限性与未来展望
尽管 FS-Researcher 表现强劲,但它对基座模型的 Reasoning 和 Function Calling 能力要求极高。较弱的模型(如 GPT-4o-mini)可能在文件路径操作或结构化自查中出错。 未来,该研究方向可能会偏向如何通过强化学习(RL)来进一步优化智能体在文件系统上的操作效率,以及如何将这种范式扩展到多模态跨文档的研究场景中。
总结
FS-Researcher 证明了:智能体的上限不在于 Context Window 的长度,而在于其管理外部知识的组织结构。 当我们从“Prompt Engineering”转向“Agent Architecture Design”时,基于文件系统的持久化协作将成为构建长程 AI 应用的行业标配。