
判别器的觉醒:利用 GAN 与加权随机森林锁定 AI 生成推文
Using generative adversarial network to improve the accuracy of detecting AI-generated tweets
本文提出了一种结合生成对抗网络 (GAN) 与加权随机森林 (RF) 的混合模型,用于高精度检测文本(特别是 Twitter 推文)是否由 AI 生成。通过将 GAN 的判别器转化为特征提取器,并配合集成学习,该方法在 173.7 万条推文的数据集上达到了 99.60% 的平均准确率。
TL;DR
随着 GPT-4、Gemini 和 LLaMA 等大语言模型的普及,伪造推文已成为社交媒体虚假信息的温床。本文介绍了一种新型检测框架:它通过将推文转化为复杂的共现矩阵,利用 GAN (生成对抗网络) 训练出的判别器作为黑盒特征提取器,再配合加权随机森林 (Weighted RF),实现了高达 99.60% 的检测准确率,成功在该领域树立了新的 SOTA 标杆。
核心速览
- 任务场景:AI 生成推文(AI-generated Tweets)检测。
- 核心方法:GAN 判别器特征提取 + 加权集成学习。
- 关键战绩:1.5% 的性能领先,近乎完美的 F1-Score (0.9962)。
痛点深挖:为什么 AI 文本越来越难捉摸?
现有的检测技术(如 BERT-based 分类器)虽然强大,但在处理短文本(如 Twitter)时经常失灵。其本质原因在于:
- 特征稀疏:短文本缺乏足够的上下文,词与词之间的微妙统计联系很难被简单的序列模型捕捉。
- 生成对抗:LLM 正在不断进化,其生成的文本在分布上越来越趋近于人类。
- Prior Work 的局限:许多方法依赖于外部事实核查(如 IDEATE),这在处理日常聊天或主观推文时显得力不从心。
方法论详解:GAN 如何变身“测谎仪”?
作者并没有直接用 Transformer 去硬碰硬,而是设计了一套精密的四步走策略:
1. 结构化文本表征
首先,推文被转化为一个方阵。这个矩阵不是简单的 Word2Vec,它包含三个维度:
- 上三角:Pearson 相关系数(描述词语关联)。
- 下三角:原始共现计数(描述物理位置接近度)。
- 主对角线:TF-IDF 权重(描述词语独特性)。
2. 基于 UNet-GAN 的深度特征提取
这是本文最精妙的地方。作者使用了一个基于 UNet 架构的 GAN。
- 训练逻辑:虽然 GAN 的目标是让 Generator 生成真实的矩阵,但作者真正想要的是那个被虐练出来的 Discriminator。
- 直觉 (Insight):判别器在试图拆穿生成器的过程中,被迫学会了识别极其细微的“非自然统计模式”。
- 输出:取判别器最后一层卷积层的激活值,形成一个 11x5x128 的高维特征向量。
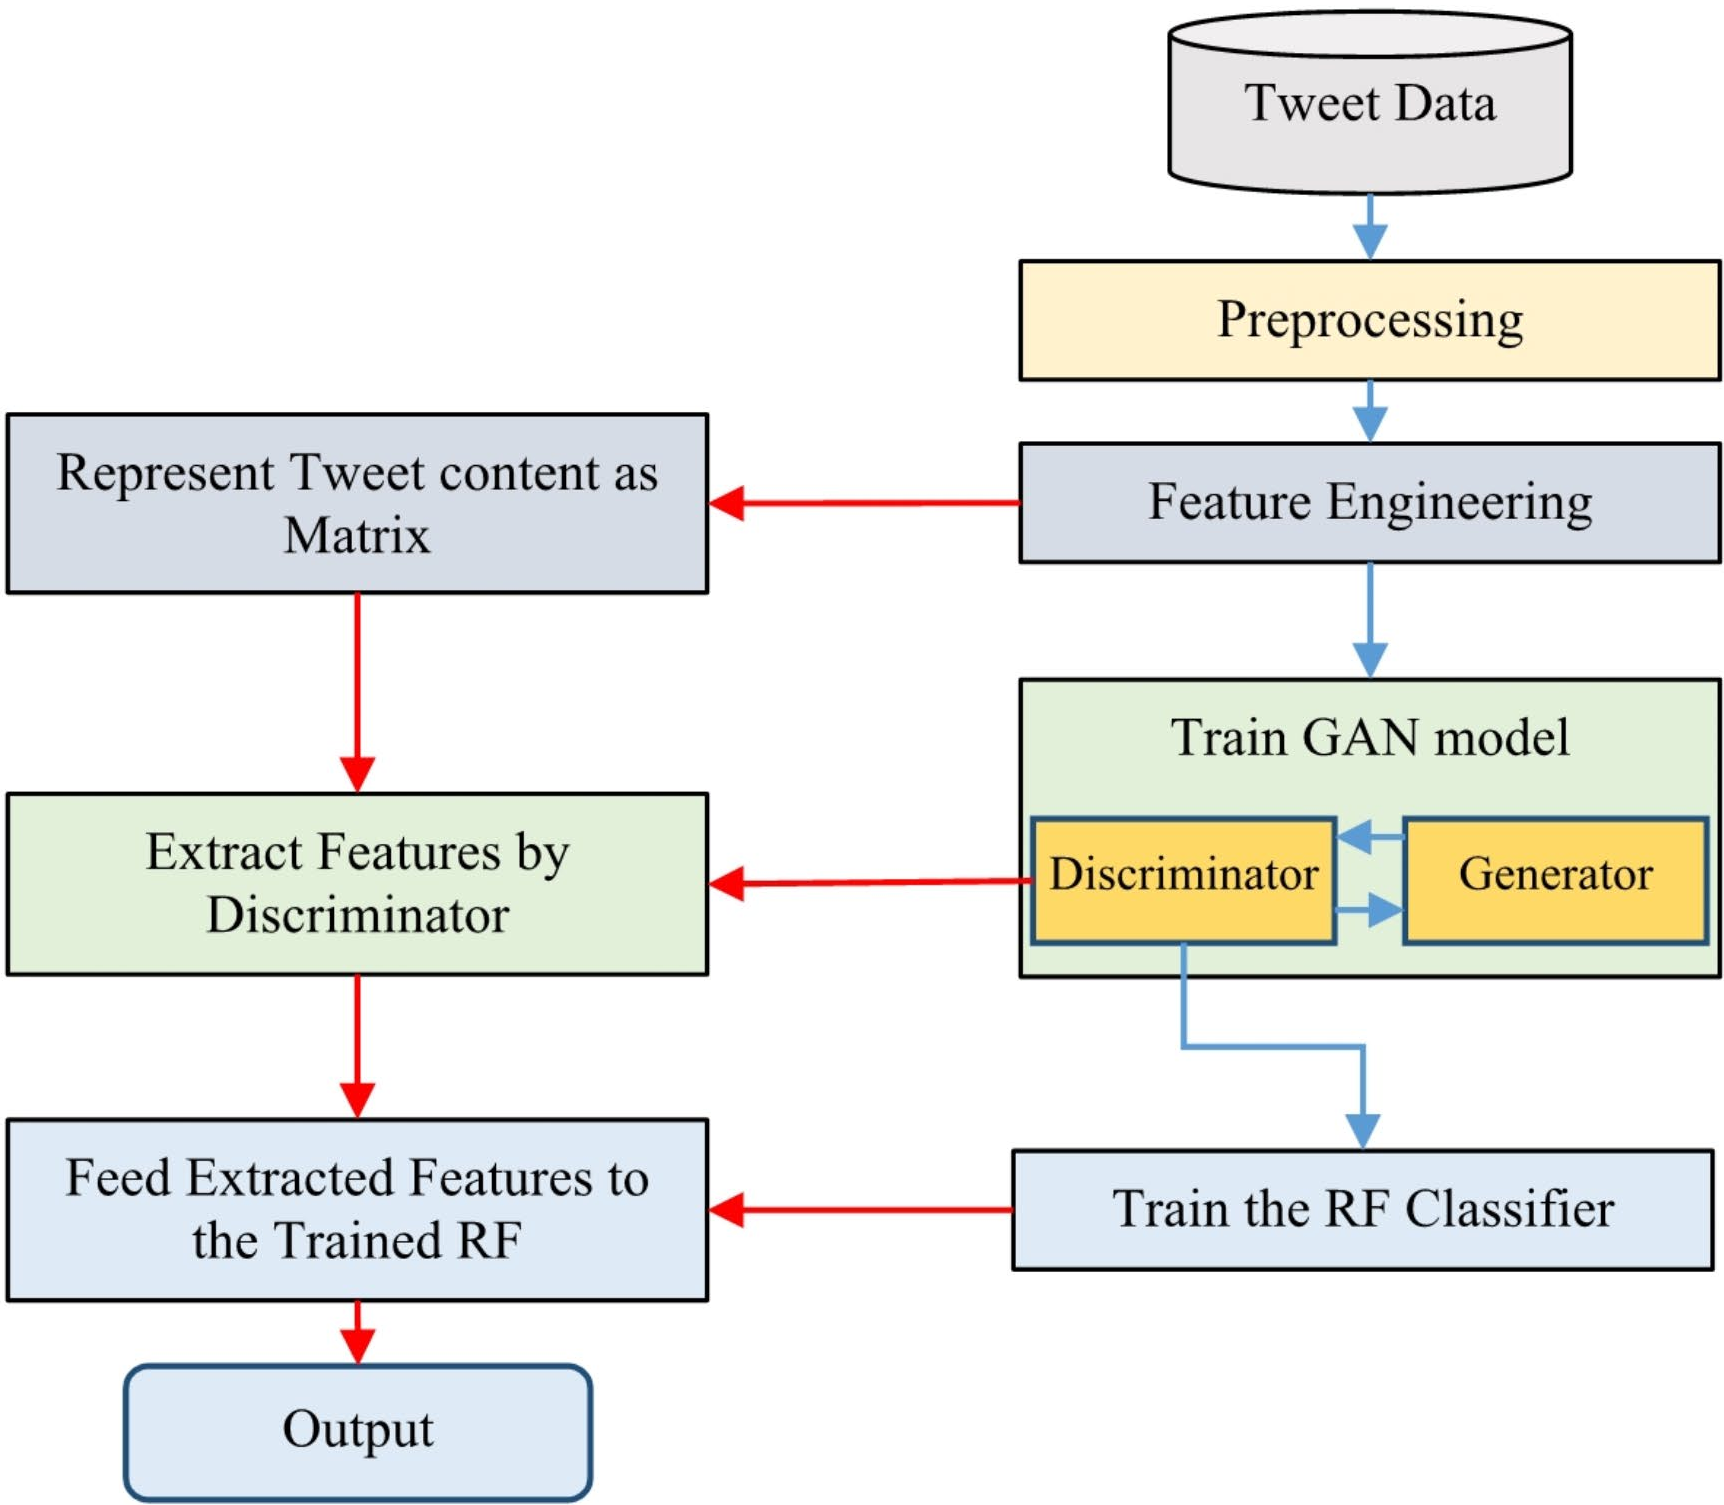
3. 加权随机森林 (RFW)
传统的随机森林对所有决策树一视同仁。本文引入了加权机制,通过全局搜索为 20 棵决策树分配 [0, 7] 的权重,让表现更好的树在最终投票(Voting)中话语权更大。
实验与结果:统治级的检测精度
实验使用了包含 173.7 万个样本的大规模数据集,涵盖了从 GPT-4 到 Claude 等主流 LLM。
- SOTA 对比:相比目前领先的 IDEATE 架构,本文方法在准确率、精确度、召回率上实现了全方位碾压。
- 消融实验:如果只用 GAN 的判别器直接分类,准确率仅 93.97%;而加入加权 RF 后,准确率飙升至 99.60%。这证明了“判别器提取特征 + 专业分类器决策”的分工比端到端检测更有效。

此外,研究还揭示了一个有趣的事实:文本越长,检测越准。在 250 字符左右的推文上,模型的区分能力达到了顶峰,这说明 AI 在长文本中更容易留下统计学上的“狐狸尾巴”。
深度洞察与总结
为什么这个组合有效?
GAN 的判别器本质上是在学习高维空间的概率分布差异。人类写推文时的用词逻辑、情感波动带来的共现特征,与 LLM 基于预测下一个 Token 的统计逻辑有着本质的不同。GAN 能够敏锐地捕捉到这些肉眼不可见、甚至 Transformer 难以通过注意力机制建模的“统计毛刺”。
局限性与挑战
- 计算开销:训练 GAN 并运行 20 棵加权决策树的成本不低,实时性检测仍有优化空间。
- 道高一尺魔高一丈:如果未来的 LLM 专门针对此类判别器进行对抗性微调,模型可能面临失效风险。
总结 (Takeaway)
这项工作证明了即使在短文本领域,AI 的痕迹依然是可追踪的。通过将 NLP 问题转化为图像化的矩阵表征,并利用 GAN 的判别天赋,我们能够构建出极其坚固的防御屏障。对于内容安全行业来说,这种“多模型融合加权”的思路具有极高的工程实战价值。