
智辨真伪:利用 GAN 与加权随机森林突破 AI 生成推文检测的极限
Using generative adversarial network to improve the accuracy of detecting AI-generated tweets
本文提出了一种结合生成对抗网络 (GAN) 与加权随机森林 (RF) 的新型检测框架,旨在提高对 Twitter 平台上 AI 生成文本的识别精度。该方法通过 GAN 判别器提取深层特征,并利用加权集成学习显著提升了分类性能,在多类模型生成的推文检测中达到了 99.60% 的 SOTA 准确率。
核心速览
TL;DR:随着 GPT-4 和 Claude 等模型的普及,社交平台充斥着真假难辨的 AI 内容。本文提出了一种全新的“对抗特征提取”框架,通过 GAN + Weighted Random Forest (RFW) 的组合,在推文检测任务中实现了惊人的 99.60% 准确率。它不仅复用了生成式 AI 的力量来“以毒攻毒”,还通过加权集成学习精细刻画了人类与机器的写作指纹。
背景定位:该工作属于 AI 内容溯源(AI-generated Content Detection)领域的高性能 SOTA 突破,通过重构特征表征策略,为社交媒体信息流监管提供了强力的技术支撑。
痛点深挖:为什么短文本检测这么难?
传统的检测方法(如基于 BERT 的分类器或统计学特征)在处理推文(Tweets)时存在三大挑战:
- 信息稀疏:推文字数有限,难以提供足够的语义上下文进行深度分析。
- 分布漂移:大语言模型(LLM)的采样策略越来越像人类,简单的困惑度(Perplexity)分析已逐渐失效。
- 泛化不足:现有检测器往往在特定模型(如 GPT-2)上有效,但在跨模型(Gemini, LLaMA 等)环境下表现大幅下滑。
方法论详解:GAN 判别器的“不务正业”
作者并没有直接使用预训练的 Transformer 模型进行微调,而是回归物理直觉,设计了一个四阶段的精精密流水线:
1. 结构化文本表征
首先,作者将每条推文转化为一个对称方阵。这个矩阵不仅记录了词频,还刻画了:
- 皮尔逊相关系数:反映词与词之间的统计关联。
- 共现计数:捕捉自然语言的底层模式。
- TF-IDF 权重:衡量词汇在全局环境下的重要性。
2. GAN 驱动的特征提取
这是本文最精妙的部分。作者采用了一个基于 UNet 架构的 GAN。
- Generator (生成器):学习从含噪数据中恢复无噪模式。
- Discriminator (判别器):在对抗过程中被迫学习如何区分极度相似的文本特征。 随后,作者“卸磨杀驴”,丢弃生成器,直接将判别器的最后一层卷积层作为特征向量输出(维度为 11×5×128)。作者认为,判别器在大规模对抗训练中练就的“火眼金睛”,能过滤掉冗余噪声,提取出最本质的创作者特征。
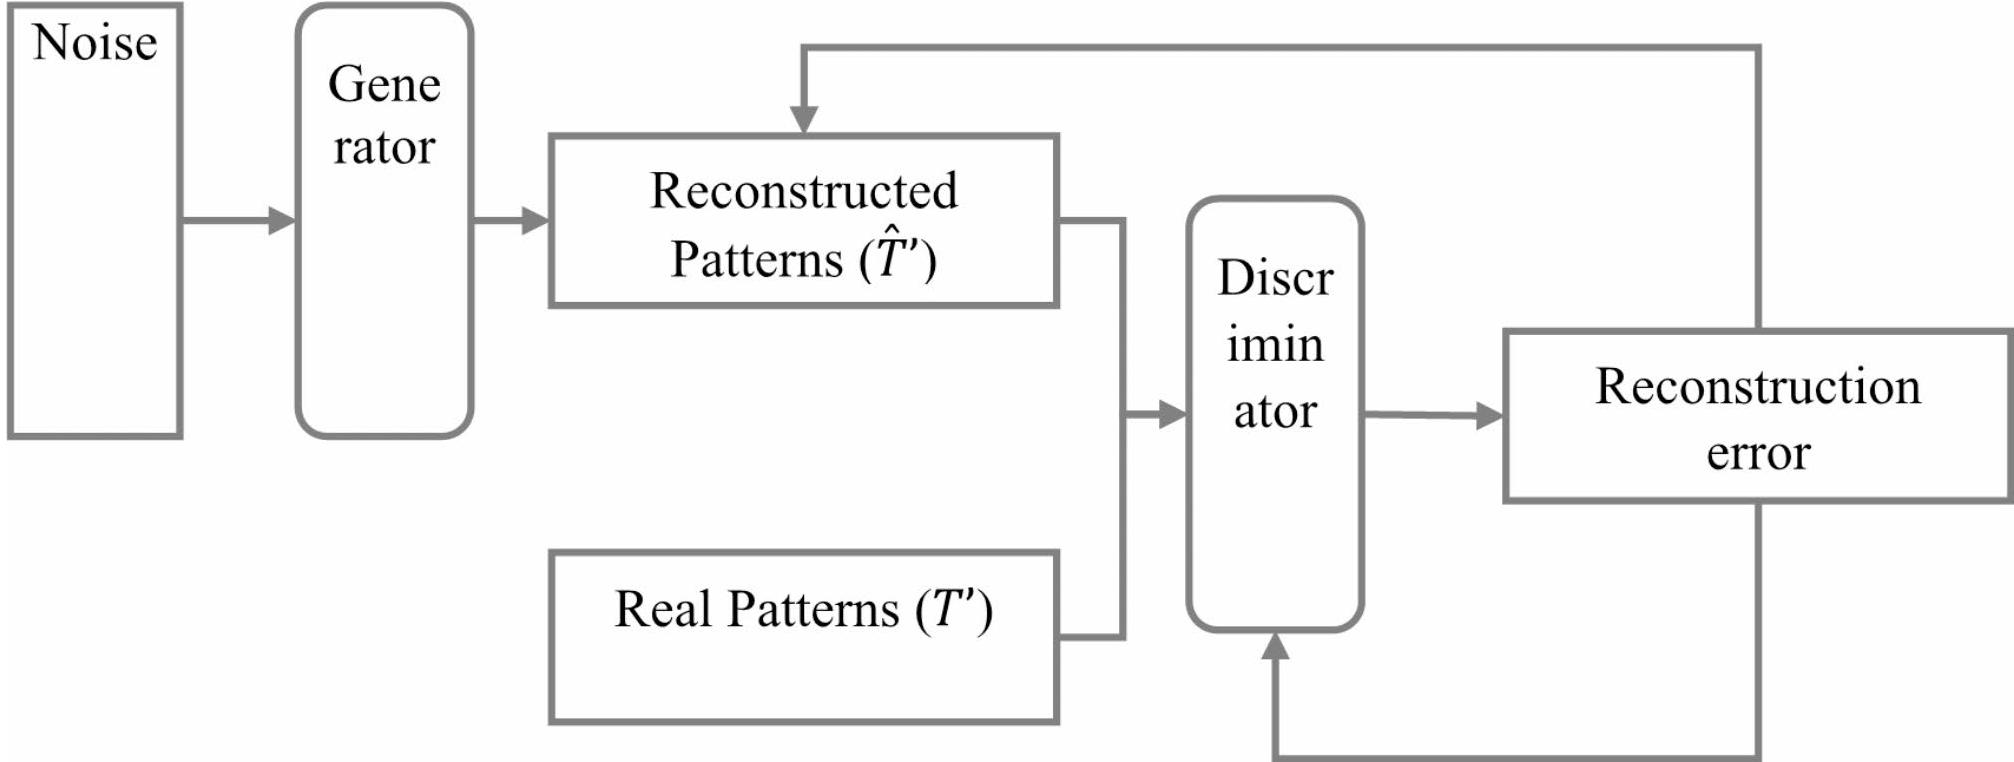 图 1: 基于 GAN 的特征提取架构,展示了通过判别器获取深层特征的过程。
3. 加权随机森林 (RFW)
传统的随机森林(RF)是“一人一票”,但作者引入了 加权投票机制。利用搜索策略为 20 棵决策树赋予不同的权重 。表现更好的树拥有更大的话语权,这种加权集成方式比传统随机森林使精度提升了 3.35%。
实验与结果:横扫基线
研究人员使用了包含 173.7 万个样本的庞大数据集,涵盖了从 GPT-4 到 Claude 等多种主流模型。
关键战绩:
- 准确率 (Accuracy): 99.60%,比现有的 IDEATE 模型高出约 1.5%。
- 平衡性: F-Measure 达到 0.9962,AUC 达到 0.9978,说明模型在假阳性与假阴性之间取得了近乎完美的平衡。
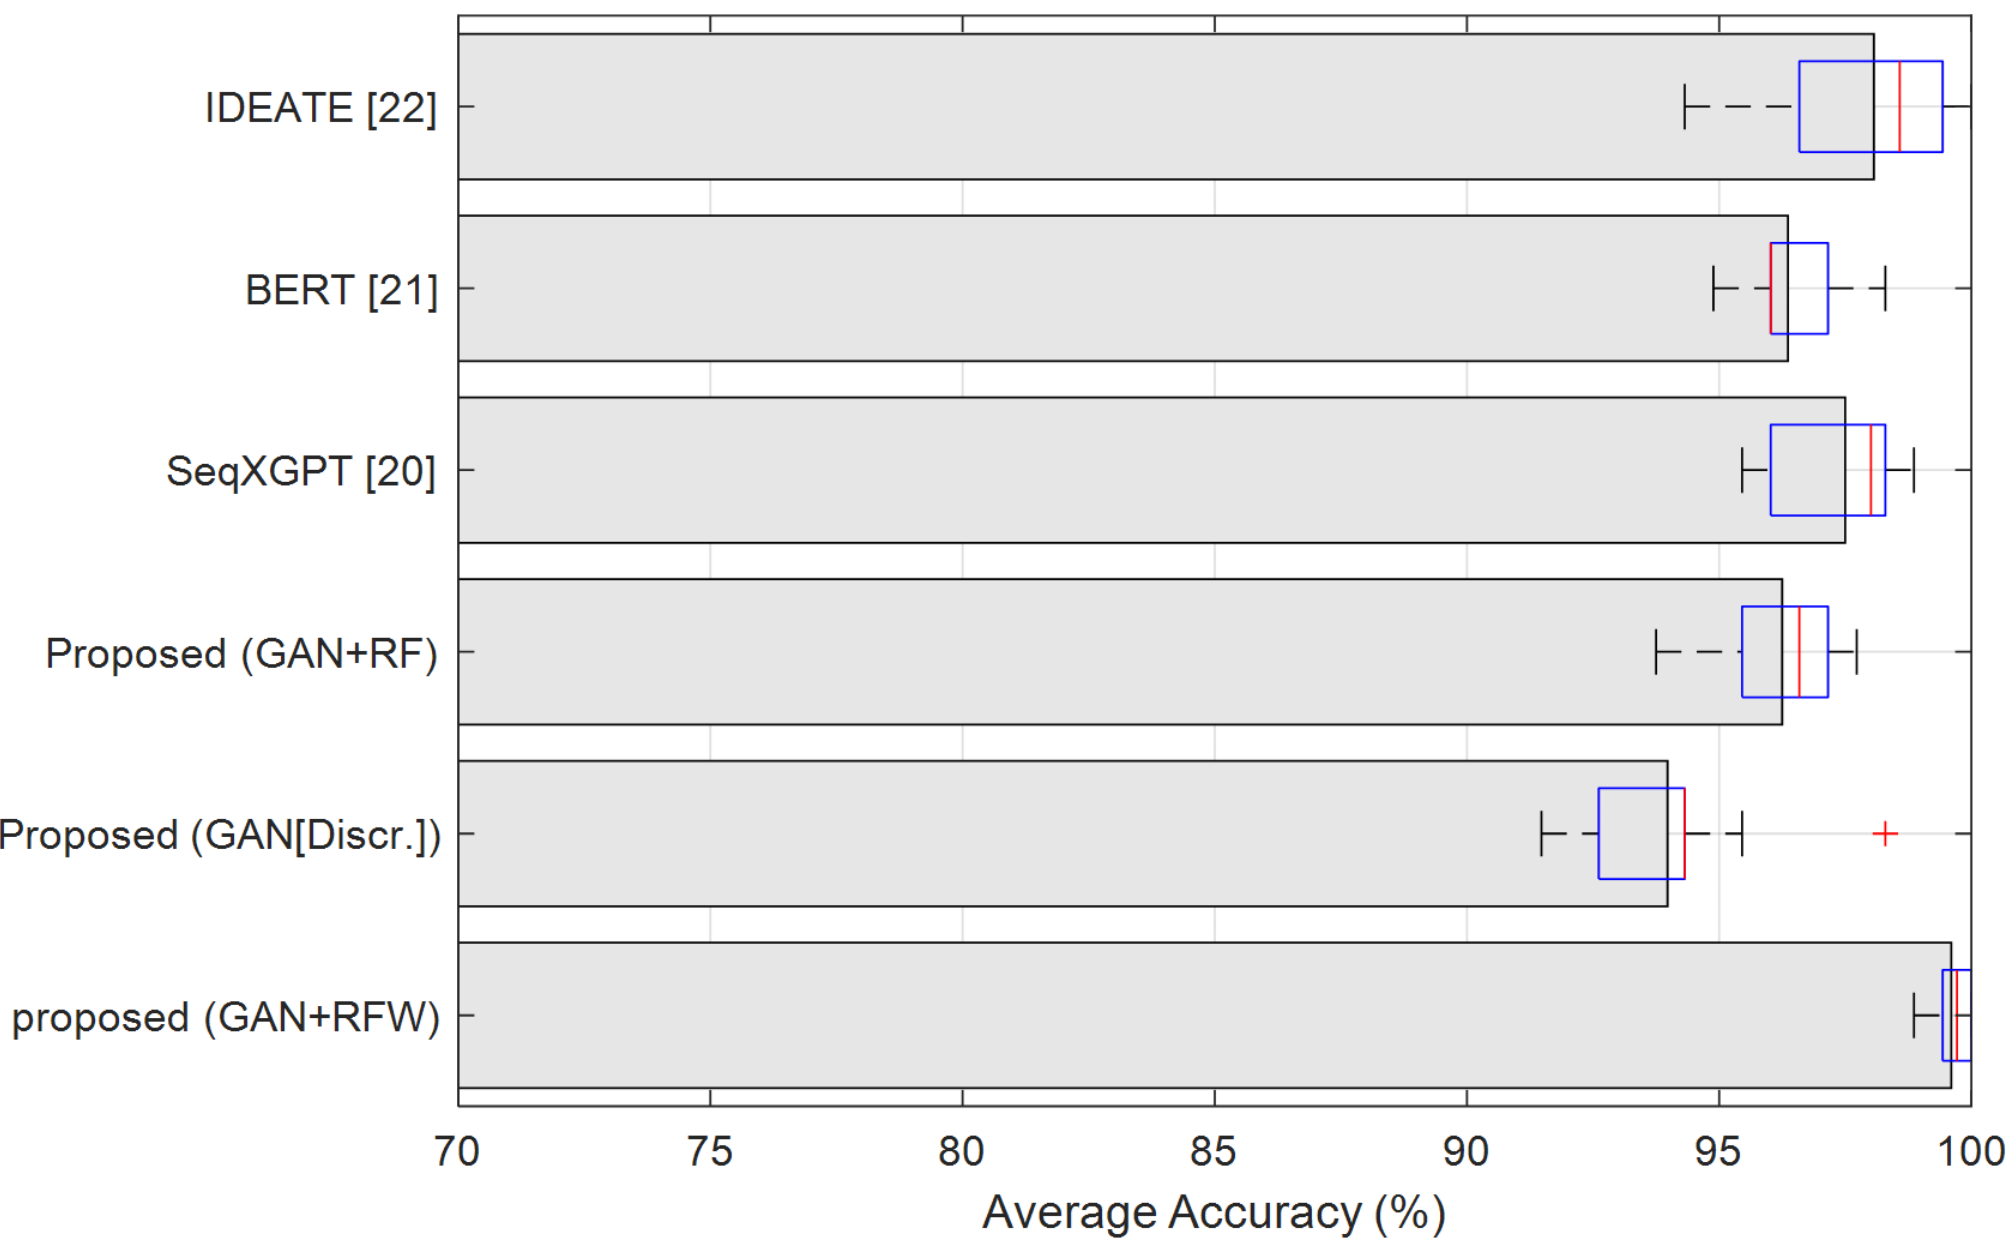 图 2: 本文方法 (Proposed GAN+RFW) 与其他 SOTA 方法(如 SeqXGPT, BERT)的准确率对比。
消融实验洞察: 如果只使用 GAN 的判别器直接分类,准确率仅为 93.97%;而加入 RFW 之后跃升至 99.60%。这证明了“GAN 提特征 + 强分类器判别”的解耦设计是性能飞跃的关键。
深度洞察与总结
总结 (Takeaway)
本文的核心贡献在于证明了:生成的对抗性可以转化为检测的敏锐度。通过将文本转化为矩阵并利用卷积判别器处理,成功捕捉到了 AI 模型在词汇共现比例上的细微偏差。
局限性 (Limitations)
- 计算成本:GAN 的训练和加权森林的权重搜索非常耗时,可能难以实时部署在超大规模流量的社交平台上。
- 对抗演变:随着 LLM 加入了更多针对性规避检测的训练(如 RLHF 的调整),这种基于静态特征的检测器可能需要持续更新特征库。
未来展望
未来的研究方向可以探索如何将这一架构扩展到图像或视频生成的检测中,并进一步优化算法以降低推理延迟,实现毫秒级的自动反垃圾系统。