
[WWW 2024] GraphTranslator:打破闭环,让图模型听懂人类指令
GraphTranslator: Aligning Graph Model to Large Language Model for Open-ended Tasks
本文提出了 GraphTranslator,一种将预训练图模型(GM)与大语言模型(LLM)对齐的新架构。通过 Translator 模块将节点嵌入转换为 Token,在大规模图数据上实现了 Zero-shot 节点分类和开放式图问答(GQA)任务。
TL;DR
阿里巴巴团队提出的 GraphTranslator 成功打破了图模型(GM)与大语言模型(LLM)之间的壁垒。它通过一个轻量级的 Translator 模块,将复杂的节点嵌入(Node Embeddings)翻译成 LLM 能读懂的词元(Tokens)。这不仅让图模型具备了 Zero-shot 节点分类的能力,还赋予了它通过自然语言进行深度**图问答(GQA)**的交互能力。
1. 痛点:图模型的“社交恐惧症”
传统的图神经网络(如 GraphSAGE, GCN)在处理预定义任务时表现出色,但它们像是一台“闭门造车”的机器:
- 概念受限:只能识别训练集里出现的标签,遇到新类标直接“宕机”。
- 缺乏交互:你无法问它“为什么这个用户喜欢买猫粮?”,它只能给你一个概率数值。
- 模态鸿沟:图结构是高维稠密向量,LLM 是离散序列文字。要把两者捏在一起,就像让一个只会数学的人去写诗。
2. 核心架构:Translator 与 Producer 的双重奏
GraphTranslator 的核心在于解决“怎么对齐”和“拿什么对齐”两个问题。
2.1 Translator 模块(翻译官)
借鉴了 BLIP-2 的思路,团队引入了一组可学习的 Graph Queries。这些查询词元在 Transformer 层中与节点嵌入(Embedding)进行交叉注意力运算,将图的结构特征“压缩”并“投影”到 LLM 的语义空间中。
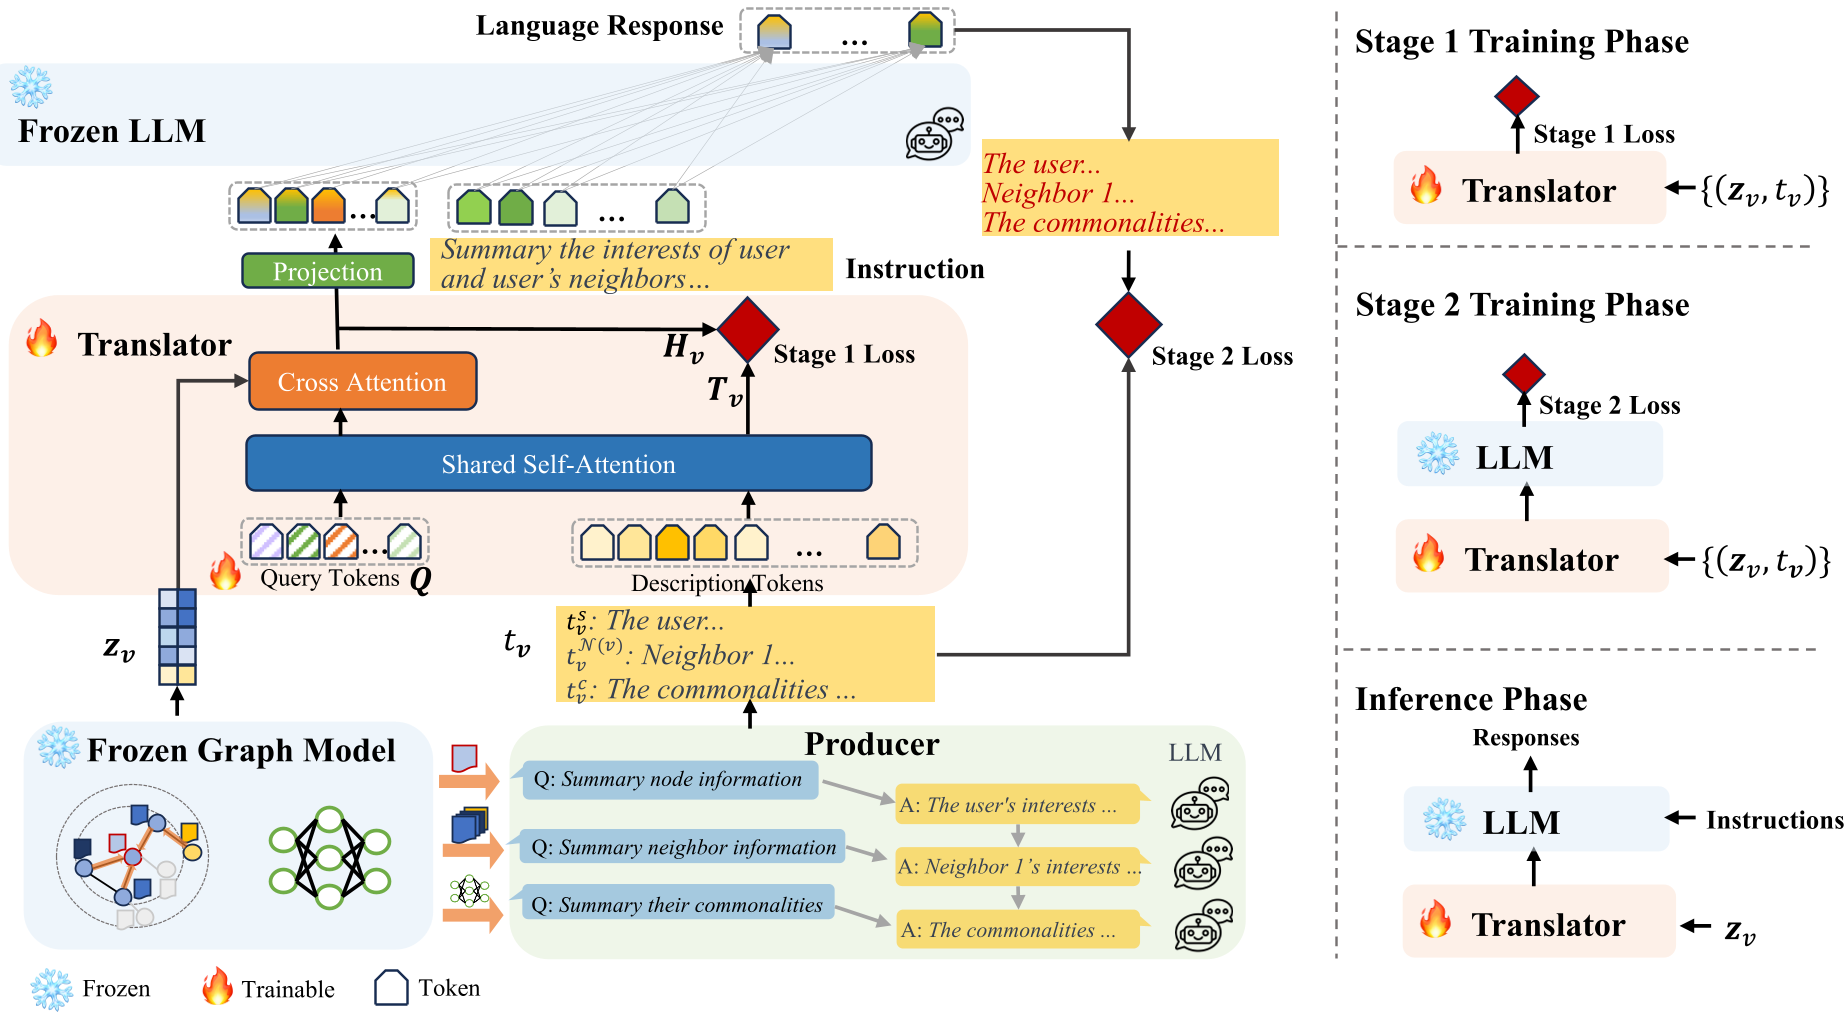
2.2 Producer 模块(数据工厂)
高质量的“图-文”对齐数据极其匮乏。作者设计了 Producer,利用 LLM 的推理能力,根据以下三个维度自动生成描述文本:
- 节点信息:节点自身的属性摘要。
- 邻居信息:节点社交/关联邻居的群体特征。
- 模型偏置(Commonality):利用 CoT(思维链)推导出节点与其邻居为何产生关联的深层逻辑。
3. 实验战果:Zero-shot 也能刷榜
在 Taobao(用户行为预测)和 ArXiv(论文分类)数据集上,GraphTranslator 展现了极强的泛化能力。
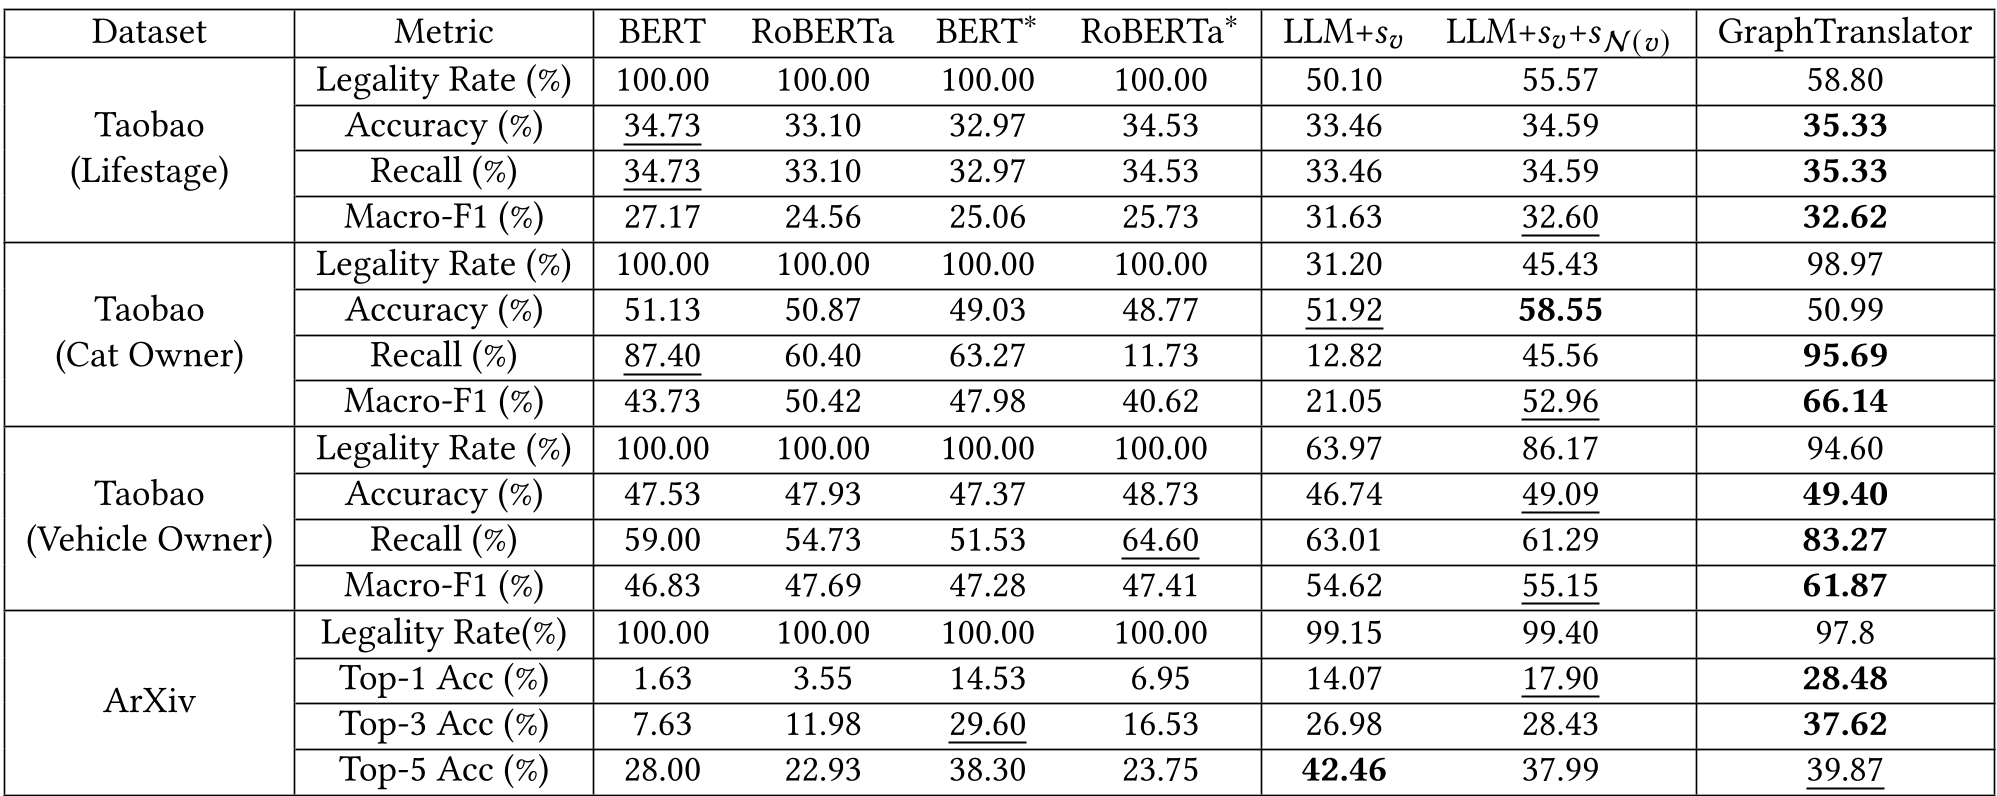
- 性能飞跃:在 ArXiv 的 40 个子领域分类任务中,GraphTranslator 的 Top-1 准确率高达 28.48%,远超 BERT 和直接输入文本的 LLM。
- 降噪能力:研究发现,直接把冗长的节点属性丢给 LLM 会引入大量噪声(如 Taobao 复杂的历史订单),而经过 Translator 压缩后的“软提示(Soft Prompt)”反而能更精准地捕捉核心特征。
4. 深度洞察:为什么它有效?
GraphTranslator 的成功不仅仅是把向量接到了模型上,更在于它理解了图的本质。
在开放式问答(GQA)实验中,当被问及“为什么这两个用户会成为朋友?”时,GraphTranslator 能够结合图的局部拓扑和语义,给出“兴趣爱好相似、社交圈重叠、相互影响”等逻辑清晰的解释。这证明了模型已经超越了特征匹配,开始进入关系推理的阶段。
5. 局限性与未来展望
尽管表现惊艳,作者也坦诚了目前的不足:
- 信息损耗:目前的 Producer 对拓扑信息(如节点度数、子图结构)的描述还不够细腻。
- 模型规模:实验主要基于 ChatGLM2-6B,如果迁移到 GPT-4 等更强底座,上限会更高。
总结:GraphTranslator 为工业界处理超大规模图数据提供了一种新范式——让图模型负责特征提取的高效能,让 LLM 负责逻辑输出的高智能。未来的图系统,或许真的可以像聊天一样被管理。