
EssayDetect:学术诚信的守护者——基于融合模型的多语言 AI 论文检测
Guardians of Academic Integrity: Multilingual Detection of AI-Generated Essays
本文提出了 EssayDetect 融合模型,用于解决 COLING 2025 DAIGenC Workshop 中的学术论文 AI 生成检测任务。该方法通过结合预训练语言模型(PLM)的语意表示与基于 LIME 筛选的文体统计特征(Stylometric Features),在英语和阿拉伯语的双语学术论文检测中取得了显著成果。
TL;DR
随着 ChatGPT 等 LLM 的普及,学术论文代写已成为诚信危机。本文介绍的 EssayDetect 系统,通过一种巧妙的融合架构——将深度学习的语意理解(DeBERTa/AraBERT)与传统文体学分析(词汇频率、可读性指标等)相结合,在 COLING 2025 挑战赛中表现卓越,英语检测 F1 达到 0.978,阿拉伯语达到 0.9429。
1. 痛点深挖:为什么学术 AI 检测这么难?
现有的 AI 检测器常被诟病为“黑盒”,且在学术场景下表现不佳,主要原因有三:
- 高误报风险:学术写作本身具有规范性,容易被模型误判为“具有 AI 特征”。
- 特征依赖:LLM 生成的文本在词汇分布上可能与人类相似,但其句式结构和情感极性往往缺乏深度(Nuance)。
- 多语言挑战:特别是像阿拉伯语这样具有复杂形态(Morphology)和屈折变化的语言,通用的检测模型往往会失效。
2. Methodology:融合的力量
EssayDetect 的核心思想是**“不仅看你说什么(Semantics),更看你怎么说(Stylometry)”**。
2.1 架构总览
模型采用了双路径并行处理:
- 深度语意路径:使用预训练语言模型(PLM)提取
[CLS]向量,捕捉全文的宏观意图。 - 文体统计路径:提取 Phraseology(措辞学)、Lexical Diversity(词汇多样性)和 Syntactic Diversity(句法多样性)三大类特征。
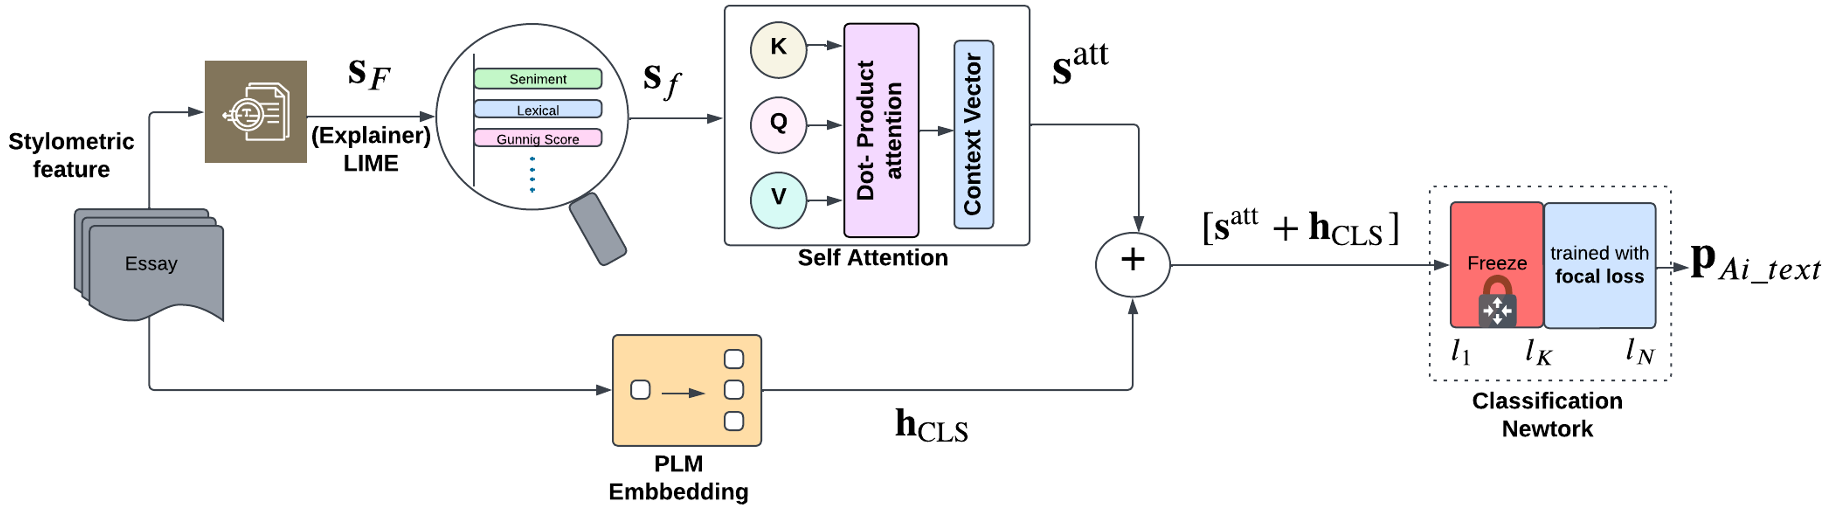 图 1:EssayDetect 融合 detector 模型架构
2.2 特征工程与注意力机制
并不是所有的文体特征都有用。作者通过 LIME (Local Interpretable Model-agnostic Explanations) 算法筛选出最具辨识度的特征,例如:
- 英语:平均句子长度、停用词数量、Type-Token Ratio 等。
- 阿拉伯语:情感极性、Flesch 阅读简易度等。
为了捕捉这些离散特征之间的关联,模型引入了 Self-Attention 机制,为不同特征分配权重,生成加权的 satt 向量。
2.3 训练策略:层级冻结与 Focal Loss
由于学术论文样本有限,作者采用了分层冻结(Layer-wise Freezing)。
- 公式推导:只更新高层参数 到 ,保留底层的通用语言表征。
- 类别不平衡:通过 Focal Loss(如下式)对分类难度大的样本加大惩罚,降低易分类样本(如明显的 AI 文本)的权重,从而迫使模型学习更细微的人机差异。
3. 实验结果:多语言表现强劲
实验结果证明,加入文体特征(Feature=Yes)后,模型性能几乎在所有 PLM 上都有质的飞跃。
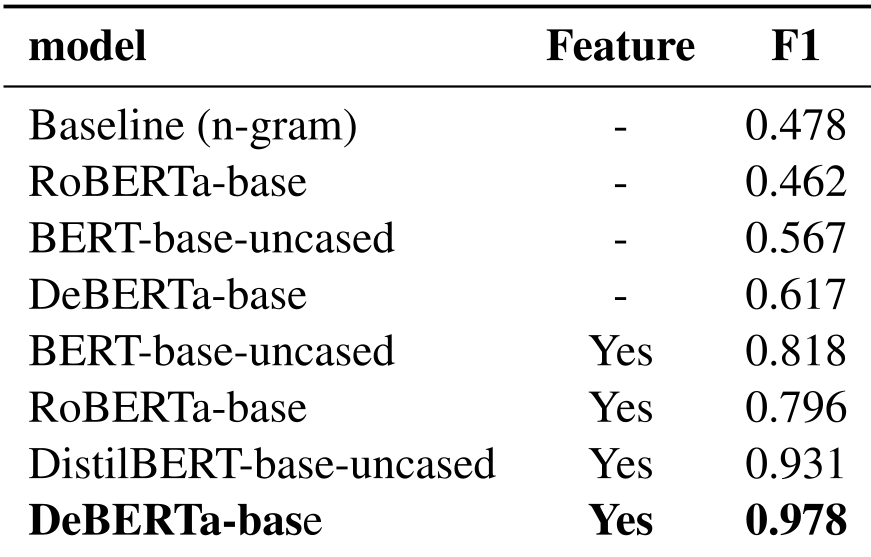 表 1:Subtask A(英语)实验结果,DeBERTa 融合版表现最佳
在阿拉伯语任务中,针对性微调的 AraBERT 在融合后同样表现出色。即便面对阿拉伯语复杂的构词法,该模型仍展现了极强的泛化能力。
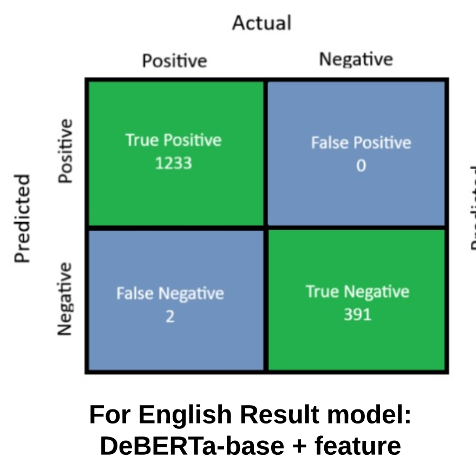 图 2:混淆矩阵显示模型在处理阿拉伯语时虽有少量误判,但整体召回率极高
4. 深度洞察与总结
EssayDetect 的成功证明了传统文体学特征(Hand-crafted features)在神经模型主导的时代依然具有不可替代的价值。通过 LIME 提升模型的可解释性,并利用注意力机制将符号化特征与连续向量空间融合,是提升垂直领域分类任务(如欺诈检测、伪造检测)鲁棒性的重要思路。
局限性:尽管实验效果优异,但模型在高阶的“对抗性攻击”(如通过特定 Prompt 技巧刻意改变文体特征)下的脆弱性仍需进一步验证。未来方向将集中在增加多模态特征以及提高跨领域的检测泛化度。