
《EssayDetect:用 DeBERTa/AraBERT 融合 Stylometry,提升多语言学术 AI Essay Detection 的有效性与可解释性》
Guardians of Academic Integrity: Multilingual Detection of AI-Generated Essays
本文面向学术场景下的多语言 AI-generated essay detection,提出了一个将 PLM embeddings 与 stylometric features 融合的检测框架。其核心设计包括 LIME 特征筛选、stylometric self-attention、layer-wise freezing 与 focal loss。该方法在 COLING 2025 DAIGenC Task 2 上取得了较强结果:English 子任务测试集 Macro F1 达到 0.978,Arabic 子任务达到 0.9429。
核心速览
TL;DR
这篇论文研究的是一个非常现实的问题:如何在学术写作场景中区分 essay 是 AI-generated 还是 human-written,而且还要同时处理 English 和 Arabic 两种语言。
作者发现,单靠 Pre-trained Language Model 并不稳:它容易偏向多数类,也未必能抓住 essay 写作里那些“像人”或“像机器”的风格差异。于是他们提出一个 fusion model,把 PLM 的 CLS embedding 与 stylometric/linguistic features 结合起来,并配合 LIME、self-attention、layer-wise freezing 和 focal loss 一起训练。
结果相当直接:English 上 DeBERTa-base 从 0.617 提升到 0.978,Arabic 上 AraBERT 从 0.9214 提升到 0.9429。它不是一个全新范式,但属于“把几件正确的事系统地组合起来,并在任务上确实奏效”的扎实工作。
背景定位
这项工作更接近于任务驱动的强工程整合型方案,而不是开辟新理论路线的开坑之作。它的价值不在于提出颠覆性架构,而在于证明:对于 academic integrity 场景,单模态语义检测并不够,可解释的 stylometry 仍然是关键补充信号。从学术坐标系看,它属于“面向 shared task 的高完成度实战方案”。
痛点与动机
为什么这个问题难?
AI-generated text detection 表面上是一个二分类问题,实际上远比“看起来像不像 ChatGPT”复杂。
核心难点有三层:
-
误报问题严重
检测器常把 human-written essay 错判成 AI-generated,尤其是当作者本身写作风格较模板化、较规范时。这在教育场景中尤其危险,因为误报会直接伤害学术公平。 -
essay detection 不是一般文本检测
学术作文往往主题明确、结构规整、语言偏正式,而这恰好也是许多 LLM 擅长模仿的风格。也就是说,human 和 AI 的分布在这个任务里天然更接近。 -
跨语言差异大,Arabic 尤其棘手
English 的句法和工具链成熟,很多 lexical/syntactic features 容易计算;但 Arabic 存在丰富形态变化、灵活词序和复杂屈折系统,很多在 English 上有效的特征在 Arabic 上并不直接成立。
现有方法错在哪里?
作者并没有否定 PLM 的能力,但指出一个很重要的问题:PLM 学到的是强语义表示,不一定是强风格表示。
在这个任务里,真正有判别力的往往不是“说了什么”,而是“怎么说的”:
- 句子是否过于均匀;
- 词汇多样性是否异常稳定;
- 可读性分数是否过于平滑;
- 标点、停用词、句长分布是否呈现“机械一致性”。
这些东西恰恰是 stylometry 擅长刻画的。
因此作者的研究直觉很清楚:
- 用 PLM 抓住全局语义和上下文;
- 用 stylometric features 抓住写作风格与语言组织;
- 用 attention 建模特征间依赖,而不是把手工特征当作静态表格;
- 用 focal loss 和 layer-wise freezing 修复训练层面的两类常见失败模式。
这个思路的价值在于它不是“堆特征”,而是试图解释为什么检测器会失败,并对症下药。
方法论详解
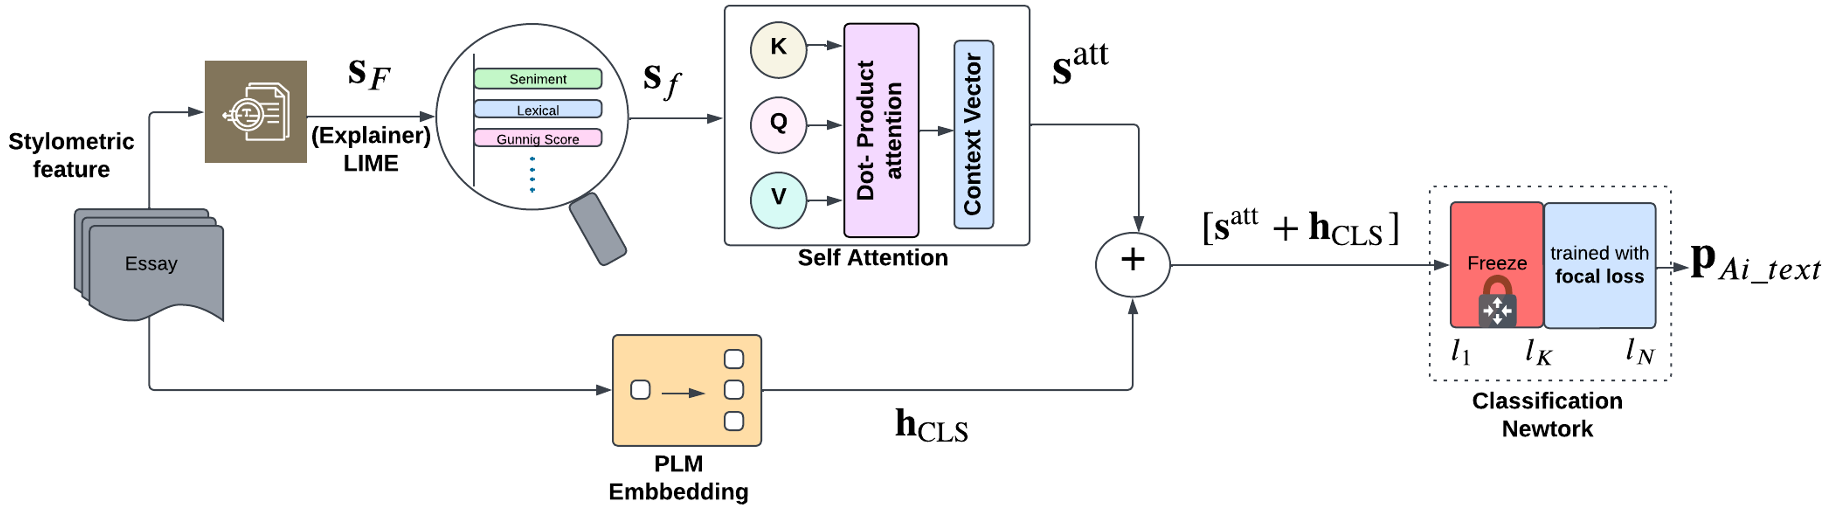
整体框架:语义通道 + 风格通道
作者的方法可以概括成一条双通路:
- PLM 通道:从输入 essay 中提取最终层的
CLSembedding,记作hCLS - Stylometry 通道:先抽取多种 stylometric features,经 LIME 选出重要特征,再通过 self-attention 得到加权表示
satt
最后将二者拼接:
fconcat = [satt; hCLS]
再送入分类器判断文本属于 human-written 还是 AI-generated。
这套设计的直觉非常自然:
hCLS提供“文本整体讲了什么”的语义概貌;satt提供“文本是怎么被写出来”的风格画像。
在检测任务里,这两者是互补的。
Stylometric features 到底捕捉了什么?
论文把特征分为三类:
-
Phraseology
- word count
- sentence count
- paragraph count
- 平均句长
- 标点数量
- paragraph 内句子数等
-
Lexical Diversity
- unique words
- Type-Token Ratio
- Lexical Diversity
- Flesch Reading Ease
- Flesch-Kincaid Grade
- Gunning Fog 等
-
Syntactic Diversity
- sentiment polarity / subjectivity
- noun / verb / adjective / adverb proportion
这些特征背后的判别逻辑并不神秘:
- AI 写作常更规整、均匀、模板化;
- human 写作更容易出现不均匀节奏、局部跳跃、非理想结构和更真实的风格波动;
- 在学术 essay 中,AI 往往表现出“形式正确但风格过稳”的特点。
所以从统计角度看,风格稳定性本身就是可检测信号。
为什么先做 LIME,再做 attention?
这是论文里比较值得讲清楚的地方。
作者不是把所有特征一股脑丢进分类器,而是先用 LIME 找出最有区分性的特征。这样做至少有三层收益:
- 降噪:减少无效或弱相关特征;
- 可解释:能说明模型到底依赖哪些风格差异;
- 跨语言适配:不同语言下最有效的特征集合并不完全一致。
例如论文提到:
- English 中 top features 包括 average sentence length、stopwords count、type token ratio 等;
- Arabic 中也能筛出 11 个高区分特征,但 POS 相关特征由于形态复杂性不如 English 直接。
然后作者对筛后的特征施加 self-attention。这个操作的意义是:
某个特征是否重要,不只取决于它本身,还取决于它与其他特征如何共同出现。
例如:
- 高平均句长 + 低词汇多样性,和
- 高平均句长 + 高词汇多样性
对“是否 AI 生成”的指示意义未必相同。
因此 self-attention 不是为了炫技,而是在特征层面建模依赖关系与组合模式。
Layer-wise freezing:为什么冻结低层?
作者观察到,直接微调整个 PLM 容易出两个问题:
- 小数据上过拟合;
- 为了适应 task-specific style,破坏底层已学到的通用语言知识。
所以他们采用 layer-wise freezing:
- 低层参数冻结,保留通用 linguistic representations;
- 高层参数参与更新,学习 essay detection 所需的任务特定风格差异。
这个设计有很强的经验主义合理性。Transformer 低层通常更偏局部句法/词法,高层更偏语义与任务适配。冻结低层,本质是在控制表示漂移,避免模型在有限数据上“把语言能力训坏”。
Focal loss:为什么对这个任务必要?
论文数据明显存在类别分布问题。以 English 为例:
- Train:AI 1467,Human 629
- Dev:AI 391,Human 1235
训练与开发分布甚至出现了方向变化,这会放大模型的偏置风险。
作者引入 focal loss:
- 对 easy examples 降权;
- 对 hard examples 升权;
- 迫使模型更多关注那些容易混淆的人类文本与 AI 文本边界样本。
这对减少“多数类支配训练”的问题非常关键。对于检测器来说,真正决定可用性的不是把明显 AI 文本判对,而是能否在边界样本上稳住精度与召回。
实验与结果
数据与设置
任务来自 COLING 2025 DAIGenC Workshop Task 2,分为:
- Subtask A:English essays
- Subtask B:Arabic essays
数据规模如下:
-
English
- Train: AI 1467 / Human 629
- Dev: AI 391 / Human 1235
- Test: 1130
-
Arabic
- Train: AI 925 / Human 1145
- Dev: AI 299 / Human 182
- Test: 886
实验使用的 backbone 包括:
- English: RoBERTa, BERT, DeBERTa, DistilBERT
- Arabic: XLM-RoBERTa, AraBERT
SOTA/基线对比:提升有多大?
最核心的结果在于:加入 stylometric fusion 后,几乎所有 backbone 都显著提升。
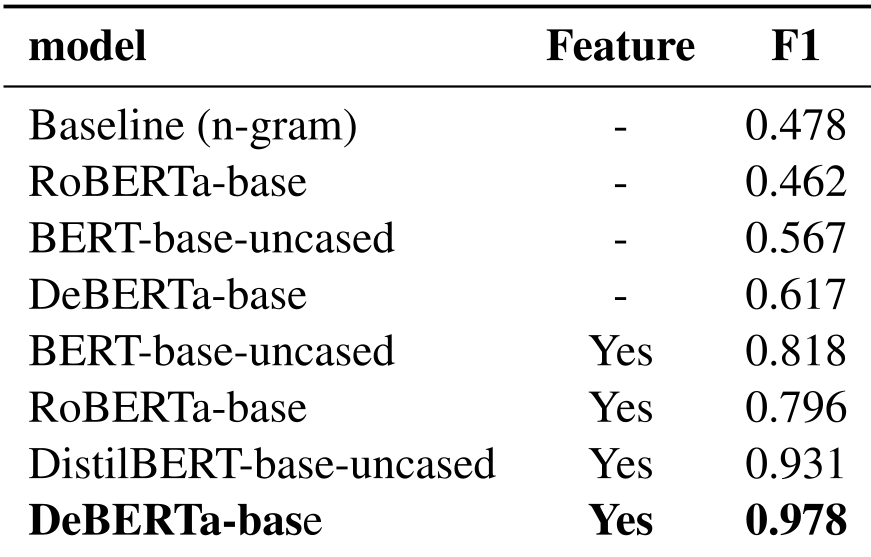
English 子任务
- Baseline (n-gram): 0.478
- RoBERTa-base: 0.462
- BERT-base: 0.567
- DeBERTa-base: 0.617
- BERT-base + features: 0.818
- RoBERTa-base + features: 0.796
- DistilBERT + features: 0.931
- DeBERTa-base + features: 0.978
这里最值得关注的不是最后数字有多高,而是:
- DeBERTa 单模态 0.617
- DeBERTa + stylometry 0.978
提升幅度达到 +0.361
这说明 English academic essay detection 中,stylometry 不是边角料,而是主贡献之一。
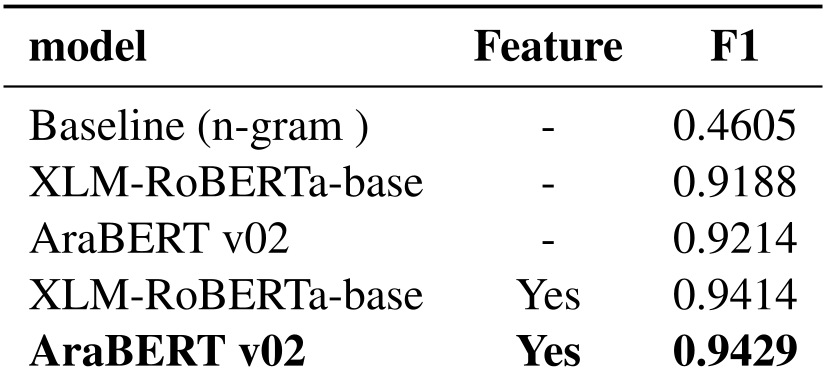
Arabic 子任务
- Baseline (n-gram): 0.4605
- XLM-RoBERTa-base: 0.9188
- AraBERT v02: 0.9214
- XLM-RoBERTa-base + features: 0.9414
- AraBERT v02 + features: 0.9429
Arabic 上增益没有 English 那么夸张,但仍然稳定有效。更有意思的是,AraBERT 不加 features 已经很强,说明language-specific PLM 在 Arabic 这种高形态复杂语言上确实非常重要。
为什么 English 的增益更大?
从论文给出的特征分析看,English 中许多 stylometric 指标对 AI/human 的分离更明显,例如:
- word count
- sentence count
- readability scores
- stopword count
- unique words
- POS 比例
而 Arabic 由于:
- 形态变化更复杂;
- tokenization 与 syllable/readability 度量更脆弱;
- POS 和句法统计的稳定性较差;
因此显式特征的质量上限可能更低,这会自然限制融合收益。
换句话说,fusion 的有效性依赖于显式特征本身是否可靠。这点是论文给出的一个重要现实启示。
Ablation Study:虽然不标准,但结果已说明问题
论文没有给出非常完整的模块级 Ablation Study 表格,例如“去掉 attention”“去掉 LIME”“不冻结层”的逐项拆分。但从有无 features 的对比中,已经能看到主要结论:
- 加特征几乎总是提升;
- 强 backbone + 特征融合效果最好;
- Arabic-specific backbone(AraBERT)优于 multilingual backbone(XLM-R);
- 单靠 PLM 在 English 上表现不稳定,融合后显著改善。
这意味着几个设计选择中,最确定有效的是:
- 显式 stylometry 引入
- 语言适配的 backbone 选择
而 LIME、attention、layer-wise freezing、focal loss 各自贡献多少,论文没有充分剥离验证,这也是它的一个明显不足。
开发集表现与误分类观察
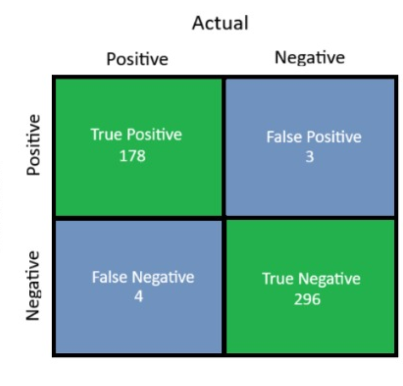
论文展示了 development dataset 上的性能图,并指出 Arabic 比 English 更容易误分类。这与前面的分析一致:Arabic 的表层特征更难稳定抽取,human 与 AI 的边界也更模糊。
此外,官方提交排名为:
- English:F1 0.975,Rank 10
- Arabic:F1 0.932,Rank 13
这提醒我们一件事:高分不等于绝对 SOTA。在 shared task 里,这篇论文表现强,但仍属于第一梯队中段,而不是断层领先。这种定位需要如实说明。
深度洞察与总结
总结:这篇论文真正证明了什么?
这篇工作最重要的结论可以概括为一句话:
在 academic essay authenticity detection 中,写作风格统计不是辅助信息,而是与 PLM 语义表示同等重要的主干信号。
更具体地说,它证明了三点:
- PLM 不足以覆盖检测任务中的全部可判别信息
- stylometry 对 human vs. AI 区分具有稳定补充价值
- 训练策略同样重要:class imbalance 与表示冻结会显著影响最终效果
这不是一个靠单一新模块取胜的论文,而是一个把数据特点、语言差异和训练偏差放在一起思考后的综合解法。
局限性
这篇论文也有几个比较明显的短板:
-
创新性有限
fusion、LIME、attention、focal loss、layer freezing 都不是新技术,更像是“组合优化”。 -
缺少严格 Ablation Study
没有系统回答:- attention 是否必要?
- LIME 筛特征比直接全特征输入好多少?
- layer-wise freezing 比全量 fine-tuning 优势有多大?
- focal loss 的独立贡献是多少?
-
对泛化能力讨论不够
论文在 shared task 数据上表现很好,但未验证:- 是否能泛化到不同 essay prompt?
- 是否能检测更新一代的 LLM 输出?
- 是否能对抗 paraphrase-based evasion?
-
可解释性还停留在特征层,不在决策层
虽然用了 LIME 选特征,但并未充分展示最终模型在具体样本上的判别依据,离教育场景真正可审计的系统还有距离。
未来展望
沿着这条路线,未来最值得做的方向有三个:
-
更强的跨域泛化
- 不只在同分布 essay 上检测
- 还要应对不同 prompt、不同学科、不同年级写作风格
-
更强的对抗鲁棒性
- 对 paraphrase
- 对拼写扰动
- 对 retrieval-assisted rewriting
- 对 human-in-the-loop post-editing
-
更细粒度的可解释检测
- 不只是给出“AI / Human”
- 还要指出哪些段落、哪些风格特征导致可疑
- 才能真正服务于 academic integrity 的申诉与复核流程
最后的 Takeaway
如果你要为教育平台、写作审核系统或学术诚信工具设计一个可落地的 AI text detector,这篇论文给出的最实用启发不是“换更大的模型”,而是:
- 选对语言专用 backbone;
- 保留 stylometric features;
- 重视 class imbalance;
- 不要忽略训练稳定性和可解释性。
从这个角度看,EssayDetect 的贡献并不在于提出一个革命性新模型,而在于把一条工程上正确、学术上合理、跨语言上可行的检测路线跑通了。对于当前 AI-generated academic text detection 这个仍在快速演化的方向,这已经是非常有价值的工作。