
人类与 LLM 的“猫鼠游戏”:arXiv 论文中的语言协同演化观察
Human-LLM Coevolution: Evidence from Academic Writing
本文通过对超过 129 万篇 arXiv 论文摘要进行统计分析,揭示了人类作者与大语言模型(LLM)之间的“协同演化”现象。研究发现,在 2024 年初学术界指出 ChatGPT 过度使用的特定词汇(如 "delve")后,这些词频在 arXiv 中显著下降,标志着研究人员正在主动调整 LLM 输出以规避检测。
TL;DR
在学术写作中,AI 痕迹正在变得越来越隐蔽。SISSA 和帝国理工学院的研究发现,自 2024 年初“ChatGPT 常用词”被学术界广泛讨论后,arXiv 摘要中相关词汇(如 delve, pivotal)的频率出现了异常的断崖式下跌。这表明人类正在学会如何“洗掉”AI 的味道,这种协同演化正让 AI 文本检测变得前所未有的困难。
核心洞察:从“无意识滥用”到“有意识规避”
早期的研究(如 Liang et al.)曾通过统计词频增长精准捕捉到了 LLM 在学术界的渗透。然而,本文提出了一个深刻的转折点:人类会学习。一旦研究者意识到使用 delve(深入探讨)会被视作“AI 生成”,他们就会在润色时将其替换。
这种现象被称为 Human-LLM Coevolution(人机协同演化)。它不仅仅是人类使用工具,而是人类根据工具的缺陷和外界的反馈,不断调整使用策略,从而改变了整个语言生态的统计特征。
趋势对比:词汇的“命运分化”
作者将 LLM 相关的词汇分成了两类,并在 arXiv 摘要数据中观察到了完全不同的走势:
- “身败名裂型”词汇:如 delve, intricate, showcasing。在 2024 年 4 月相关预印本论文揭示其为 AI 特征后,这些词在 arXiv 中的增长势头戛然而止,并迅速回落。
- “长盛不衰型”词汇:如 significant, additionally。这些词原本在人类写作中就很常见,LLM 虽然也偏爱它们,但它们不容易触发读者的怀疑,因此词频依然在稳步爬升。
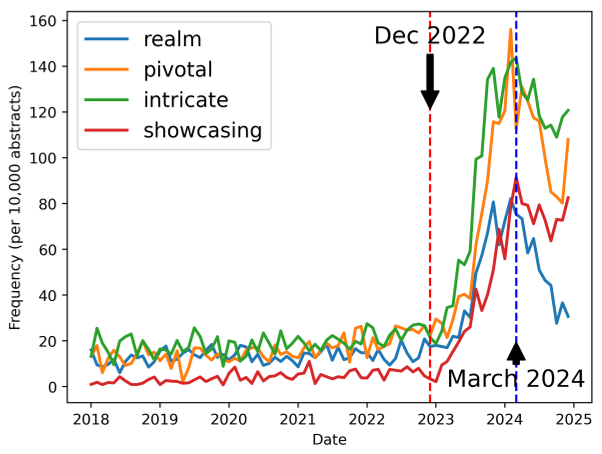 上图清楚地展示了 2024 年中旬后,部分 LLM 特征词汇的集体“大撤退”。
实验证实:简单的 Prompt 就能骗过检测器
为了验证这种规避行为的影响,作者测试了两种 Prompt:
- P1(常规润色): "Revise the following sentences..."
- P2(规避润色): "Revise... Don’t use the following words: 'realm', 'pivotal'..."
结果显示,仅仅是通过在 Prompt 中加入“禁用词列表”,生成的文本在统计特征上就更接近人类。
更严峻的是,作者测试了目前最先进的零样本检测器 Binoculars。实验发现,即便论文被 LLM 深度改写,Binoculars 的检测得分变化并不显著。这意味着,在现实的学术流程中,当作者进行“人机混合”写作时,现有的技术手段几乎不可能实现精准拦截。
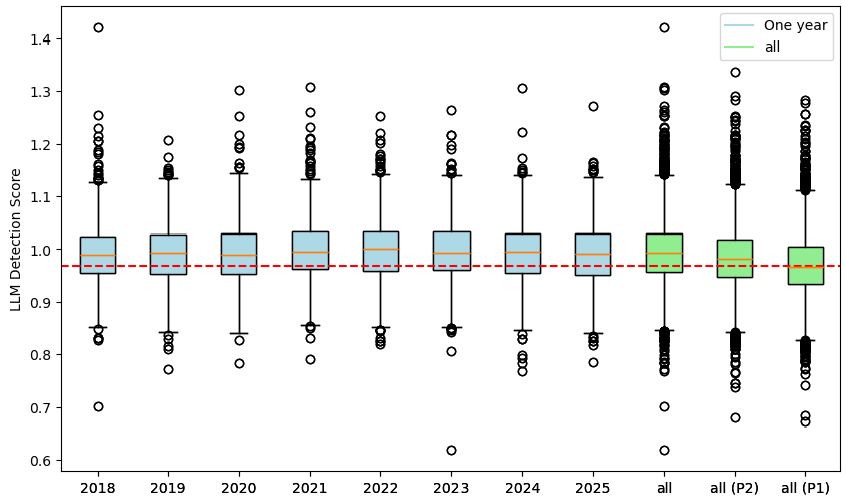 模型架构与检测得分分布:显示了检测器在处理 AI 修正文本时的识别困境。
深度洞察:检测的终结与协作的新常态
本文的研究结果传达了一个关键信号:试图在单篇文档层面识别 AI 痕迹正变得越来越不可行。
- 统计学视角才是出路:虽然我们很难判定某一篇文章是否由 AI 编写,但在宏观层面(如一个学科、一本期刊),通过观察 is, are 等基础功能词的词频下降(系 LLM 追求简洁所致),我们仍能推断 LLM 的整体影响力。
- 能力的双刃剑:频繁使用 LLM 的研究者同时也是最擅长识别 AI 文本的人。这意味着“高级玩家”能够利用这种直觉,更好地掩盖写作中的机器感。
总结
该研究不仅是对词频波动的记录,更是对学术生产方式变革的见证。LLM 并没有仅仅作为一个静止的词典存在,它与人类的反馈回路共同构建了一个不断变化的动态平衡。对于未来的学术评价体系来说,与其纠结于“谁写了这行字”,不如更多关注“这行字所承载的科学价值”。
局限性分析: 本研究主要关注 arXiv 摘要,由于其公开性,作者可能有更强的动力进行“去 AI 化”。在非公开或审核不严的写作领域,这种协同演化的速度可能有所不同。