
消费级 LiDAR 的“透视”进化:基于运动诱导采样的非视域成像
Imaging Hidden Objects with Consumer LiDAR via Motion Induced Sampling
本文提出了基于消费级 LiDAR 的非视域(NLOS)成像方案,通过“运动感应孔径采样(MAS)”模型,利用手机 LiDAR 实现了隐藏物体的 3D 重启、多目标追踪及相机定位。该方法在低成本硬件(<$100)上实现了实时性能,标志着 NLOS 技术从实验室走向大众化应用。
TL;DR
麻省理工学院(MIT)的研究团队最新证明:你手中不到 100 美元的消费级 LiDAR(如智能手机或扫地机器人传感器),通过一种名为 MAS(Motion-Induced Aperture Sampling) 的多帧融合算法,就能实现“隔墙观物”。它不仅能实时追踪转角后的隐藏目标,误差控制在 5 厘米以内,还能在白墙环境下通过隐藏物体给自己定位。
背景定位:从实验室“神装”到消费级“平替”
非视域(Non-Line-of-Sight, NLOS)成像一直是计算摄影领域的“黑科技”,它通过分析光线在墙壁等散射介质上的多次反射(Multi-bounce),重构视线外的场景。然而,过去这需要数万美元的皮秒扫频激光器和极其严苛的静止捕获环境。本文的贡献在于:它在极差的硬件条件下(低 SNR、低分辨率、手持抖动),通过巧妙的数学建模实现了实时 NLOS 感知。
痛点深挖:消费级 LiDAR 的“三大死穴”
为什么直接把现有的 NLOS 算法套用在手机 LiDAR 上会失败?
- 低 SNR:为了人眼安全,消费级激光功率极低,信号微弱到几乎被环境噪声淹没。
- 分辨率瓶颈:典型的消费级 LiDAR 只有约 100 个像素点,相对于实验室级别的百万像素简直是“全盲”。
- 运动模糊:手持设备的移动和隐藏物体的运动会产生复杂的耦合运动模糊,传统单帧算法无法处理。
核心机制:运动诱导孔径采样(MAS)模型
作者的直觉非常精妙:既然单帧信息不够,那就用多帧序列来凑。这类似于摄影中的“多帧降噪”和雷达中的“合成孔径(SAR)”。
1. 物理直觉:光锥变换(LCT)的卷积特性
研究人员利用了 Light-Cone Transform (LCT),将复杂的飞行时间(ToF)数据映射到一个线性空间。在这个空间里,物体位置的变化等效于测量数据在这个空间的简单平移。
2. 数学表达与架构图
MAS 模型(公式 3)将测量过程解构为三个部分的联合:
- Camera Sampling:由相机位姿决定的空间采样。
- Object Shape:物体的固有形态。
- Object Position:随时间变化的物体位移。
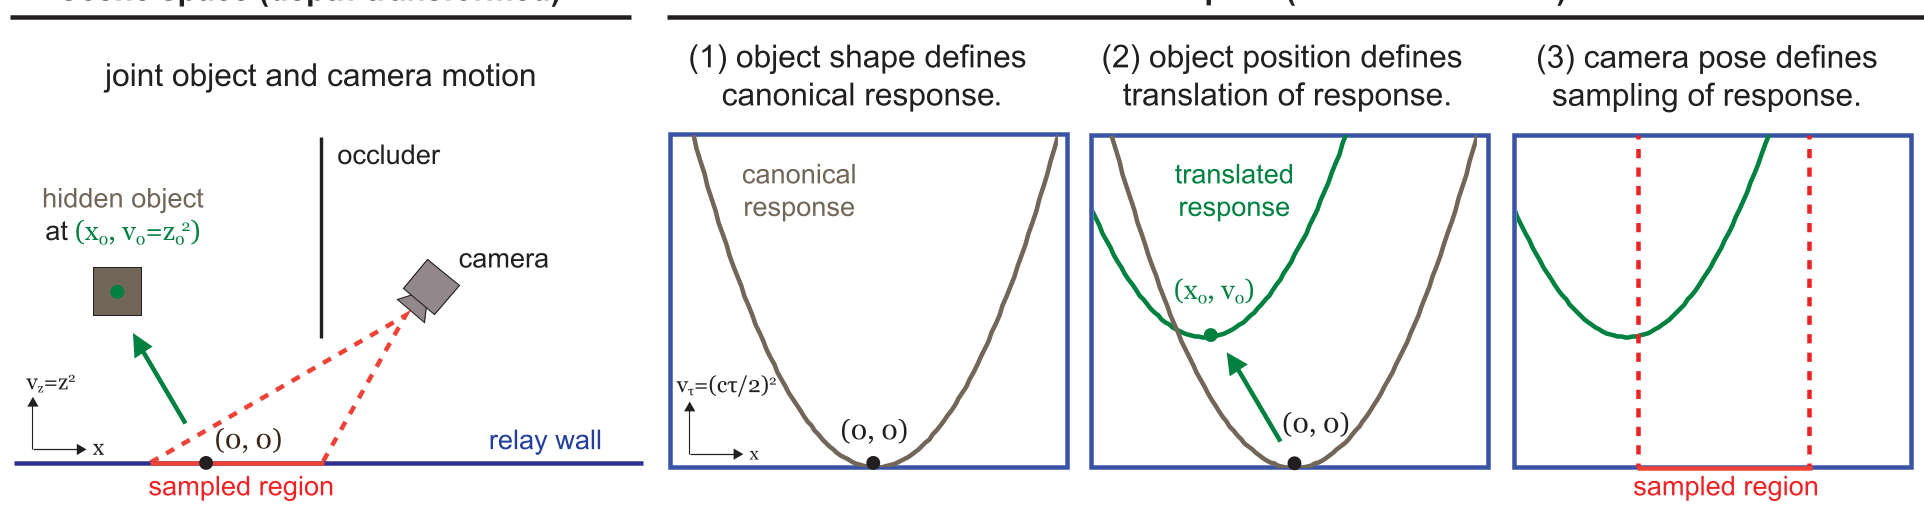 (图 2:MAS 模型展示了如何通过 LCT 统一物体形状、运动与相机位姿)
粒子滤波:实时追踪的“大脑”
为了在海量噪声中准确定位,作者引入了粒子滤波(Particle Filtering)。
- 传播(Propagation):假设粒子随运动模型扩散。
- 评估(Evaluation):利用 MAS 模型实时模拟出当前位姿下“理论上”应观测到的信号,并与真实观测值做相关性比对(灰度得分)。
- 重采样(Resampling):淘汰掉那些不符合观测的“错误答案”。
这种方法允许系统处理歧义性。当物体距离较远时,粒子群会扩散(表示不确定性);当距离变近,粒子群会收缩到真实位置。
实验战绩:全场实时 SOTA
研究人员在手机级 LiDAR 和商业化的 ST VL53L8CX 传感器上进行了验证:
- 追踪精度:平均误差 4.7 cm。即使是漫反射(Diffuse)物体,也能保持稳定的追踪能力(见下图表)。
- 相机定位:在无法进行传统特征匹配的纯白墙面前,利用转角后的隐藏椅子作为参照物,成功实现了相机的足迹追踪。
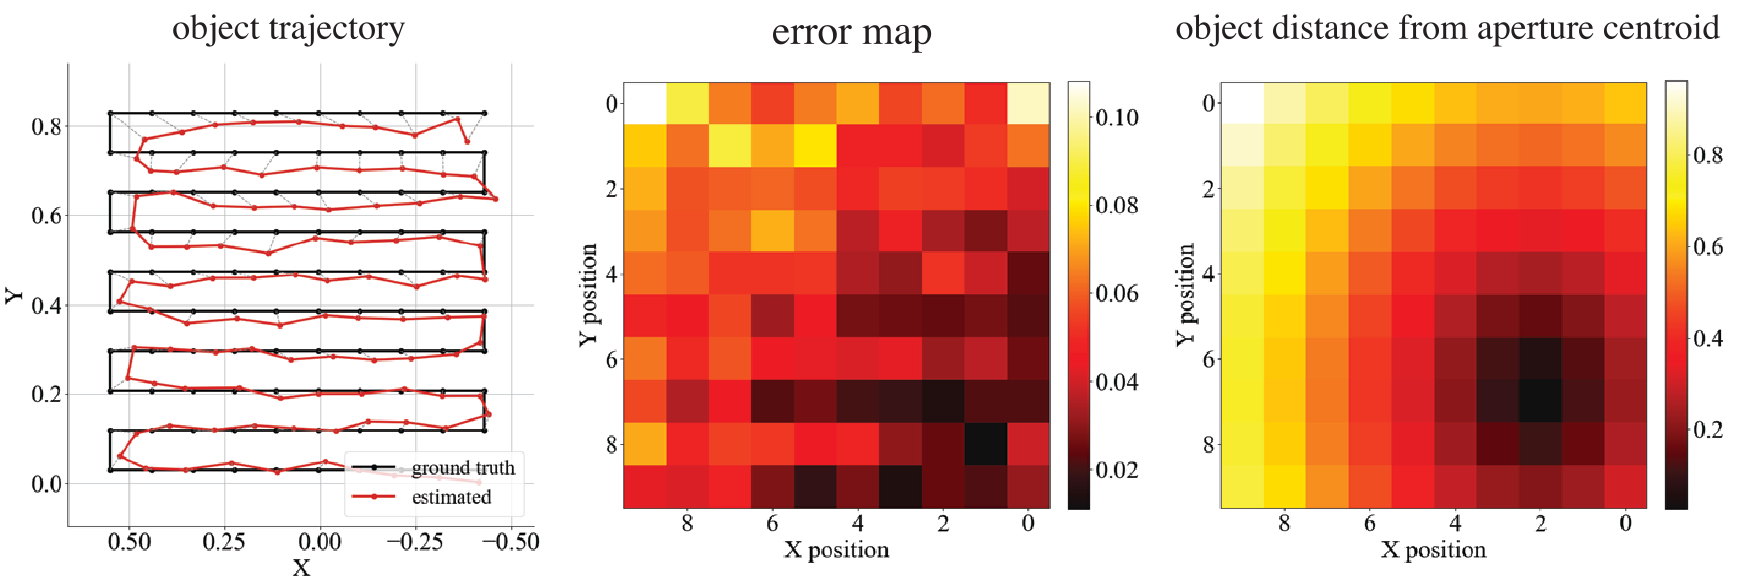 (图 9:即使物体远离虚拟孔径中心,算法依然能通过粒子分布维持有效的路径预测)
深度洞察:为什么这很重要?
这项工作真正的价值在于其**“即插即用”(Plug-and-play)**的民主化属性。
- 机器人视觉:仓储机器人现在可以提前预知转角后是否有障碍物或行人,无需等待进入视线。
- AR/VR:通过 NLOS 信号捕获用户背部或被遮挡肢体的姿态,实现更完美的全身动捕。
- 局限性分析:目前模型主要处理刚体平移(Translation),暂未完美解决旋转(Rotation)和复杂的非均匀反射率问题。
总结 (Takeaway)
正如作者所言,这是 NLOS 从“实验室昂贵玩具”转向“大规模消费应用”的关键一步。它告诉我们,当硬件受到物理限制时,利用时间维度的冗余和运动先验的约束,可以压榨出令传统视觉算法惊叹的感知深度。