
IOPO:大模型不听话?阿里提出输入-输出双重偏好优化,精通复杂指令遵循
IOPO: Empowering LLMs with Complex Instruction Following via Input-Output Preference Optimization
本文由阿里巴巴通义实验室提出,旨在提升大语言模型(LLM)遵循复杂多约束指令的能力。为此,作者发布了包含 120K 训练数据的 TRACE 评测基准,并提出了 IOPO(输入-输出偏好优化)对齐方法,通过同时建模指令(Input)和回答(Output)的偏好对,实现了 SOTA 性能。
TL;DR
大语言模型(LLM)在面对“要求写 500 字、包含 3 个笑话、必须用 JSON 格式返回”这类复杂指令时,常会顾此失彼。阿里巴巴通义实验室发布的论文《IOPO: Empowering LLMs with Complex Instruction Following via Input-Output Preference Optimization》给出了新方案:不仅要告诉模型哪个回答更好(Output Preference),还要让模型学习指令之间的微妙差别(Input Preference)。该方法配套 TRACE 120K 数据集,在多个基准测试中刷新了 SOTA 记录。
痛点深挖:为什么 DPO 在复杂场景下会“失灵”?
当前的对齐主流技术如 DPO(直接偏好优化),其核心逻辑是:给定一个指令 ,对比好的回答 和坏的回答 。
然而,在真实场景中,指令 往往包含多个细粒度约束(如字数、语气、格式等)。DPO 仅仅通过对比 的差异,很难让模型建立起对指令中特定约束项的敏感度。这就导致模型虽然知道某个回答更好,但并不知道是因为满足了哪个具体约束才变好的。
核心逻辑:从单向对比到交叉“配对” (IOPO)
作者认为,模型需要学会“反思”:如果指令微调了一点点,那么之前的优选回答是否还适用?
基于此,IOPO 引入了 Input-Output 交叉偏好:
- 构造两个有细微差别的指令 及其对应的完美回答 。
- 形成四个组合: 是“天作之合”,而 则是“错点鸳鸯谱”。
- IOPO 的核心目标:让模型认为匹配组 的概率显著高于错配组 。
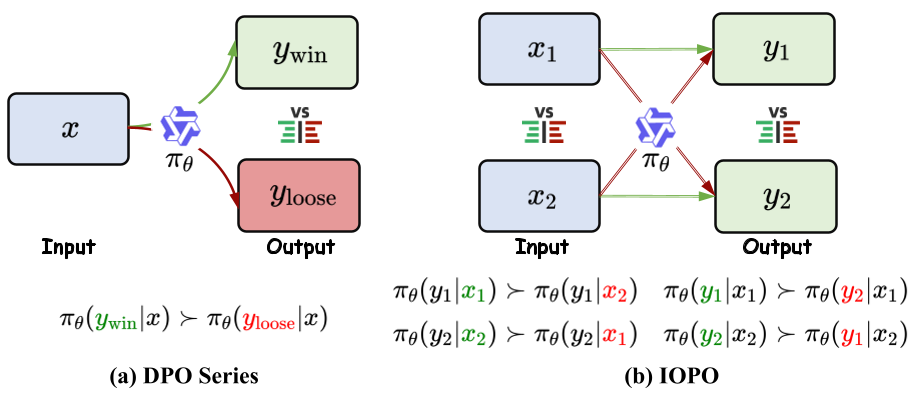
通过这种交叉对比,模型被迫去解析 和 之间的微小差异(Input Preference),从而大大增强了对复杂约束的感知能力。
基础设施:TRACE 基准
为了支撑这种训练,作者构建了 TRACE 平台:
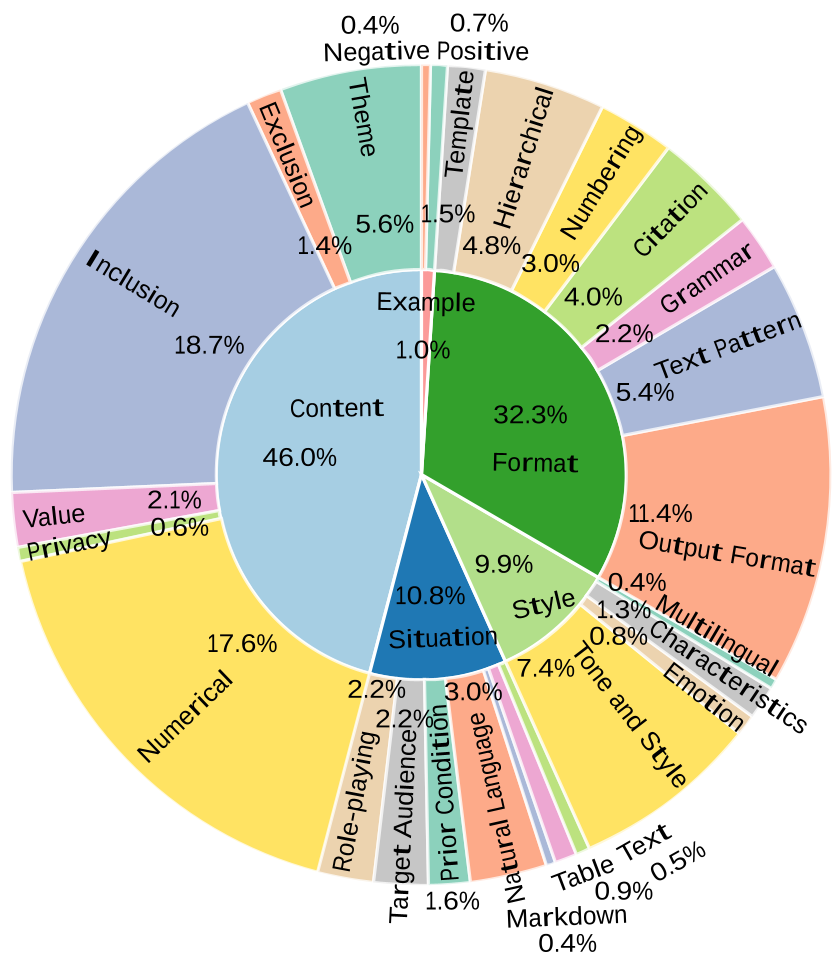
- Taxonomy:定义了 5 大类、26 个维度的约束体系(内容、语境、风格、格式、示例)。
- Scale:包含 120K 条训练数据和 1K 条经过人工校验的高质量测试数据。
- Complexity:每条指令平均包含 4.89 个约束,最高可达 15 个,远超现有基准。
实验战果:域内域外全面领先
实验在 Qwen2-7B 和 Llama3.1-8B 两个主流底座上展开。结果显示,IOPO 在 TRACE 内部测试集以及外部知名的 IFEval、CFBench 上均取得了显著提升。
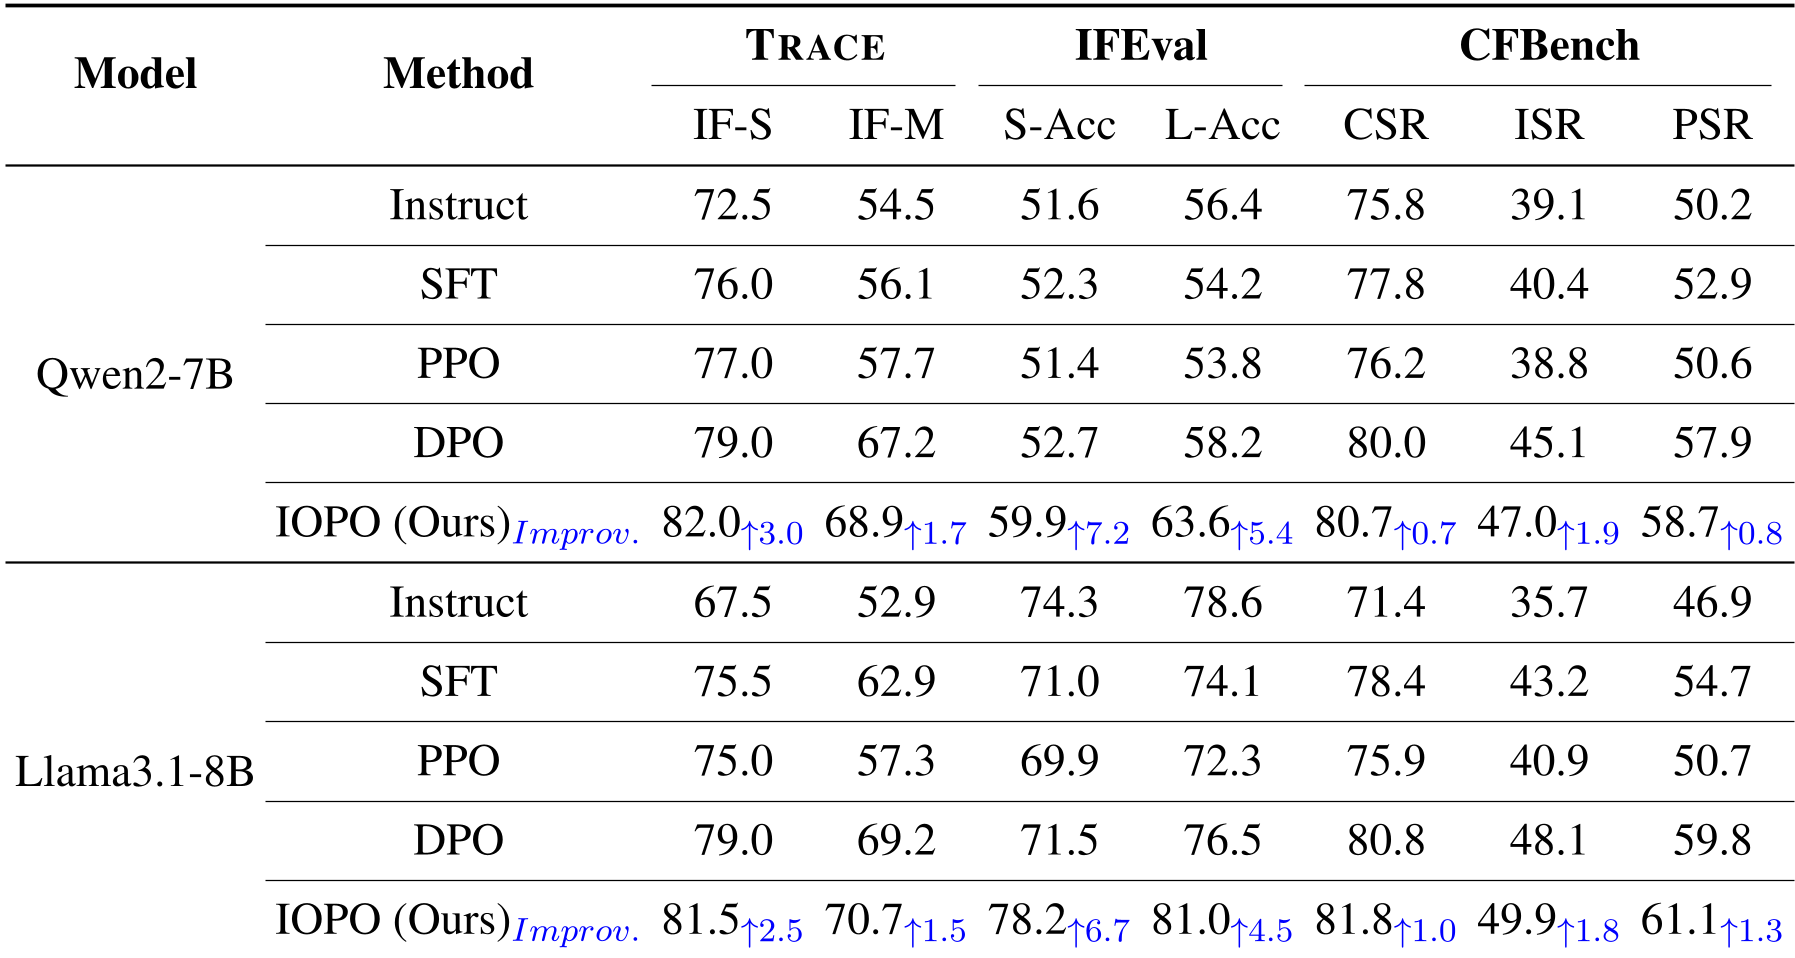
深度解析:
- 对比 SFT 和 DPO:IOPO 在 IFEval 上的提升尤为巨大(在 Qwen2 上 Acc 提升超过 7%),这说明建模指令偏好能有效解决“幻觉”和“漏看约束”的问题。
- 消融实验:移除 Input Pref 或 Output Pref 都会导致性能下降,证明了“双重优化”的必要性。
深度洞察与总结
IOPO 的成功为 LLM 的微调提供了一个新视角:对齐不仅仅是回答的对齐,更是“认知”与“需求”的对齐。
局限性: 当然,IOPO 也不是没有代价。由于需要计算 4 个组合的 Forward 过程,其显存消耗大约是 SFT 的 4 倍。尽管如此,考虑到在推理阶段它不增加任何额外成本(Inference speed 1.0x),这种在训练阶段的“投资”对于追求极致指令遵循能力的商业模型来说是非常划算的。
未来启示: 这项工作开启了对对齐算法的新思考——如何通过更高维度的负采样(如指令扰动、条件对比)来压榨模型的逻辑上限。