
IOPO:重塑 LLM 的“听话”能力,从输入输出双向感知细粒度指令
IOPO: Empowering LLMs with Complex Instruction Following via Input-Output Preference Optimization
本文由阿里巴巴通义实验室提出,旨在增强大语言模型(LLMs)对复杂多约束指令的遵循能力。核心贡献包括构建了包含12万条训练数据的 TRACE 基准,以及提出了 IOPO(输入-输出偏好优化)对齐算法。
TL;DR
阿里巴巴通义实验室发布的 IOPO (Input-Output Preference Optimization) 算法,打破了传统 DPO 仅关注“哪个回答更好”的思维局限。通过同时优化输入偏好和输出偏好,IOPO 让模型不仅能写出好答案,更能敏锐察觉指令中“一字之差”带来的约束变化。配合 12 万条数据的 TRACE 基准,该方法在复杂指令遵循任务上刷新了 SOTA 记录。
痛点深挖:为什么 DPO 玩转不了复杂指令?
在现实应用中,我们给 AI 的指令越来越复杂,比如“写一个 JSON,包含北京介绍,字数不超过 1000,必须用 UTF-8 编码,且地名要加粗”。
目前的对齐主流方法(如 DPO, RLHF)存在一个感知盲区:它们通常是基于“给定指令 ,比较响应 和 ”。在这种模式下,模型学习的是文本质量的差异,而对指令 里的细碎约束(Constraints)缺乏敏感度。如果指令稍微改动一个词,模型往往会给出千篇一律的回答,因为它并没有真正“理解”每个约束如何决定输出。
核心机制:IOPO 的逻辑直觉
IOPO 的核心创新在于双向对齐。它不仅做“命题作文”,还要做“改错题”。
1. 架构解析
IOPO 将数据组织成“四元组”:(匹配)、(匹配)、(错配)、(错配)。
- 输出偏好:当指令是 时,模型要学会 。
- 输入偏好:当响应是 时,模型要学会它更匹配 而非 。
通过这种方式,模型被迫去“深入挖掘”指令 和 之间的微小差异(例如:一个是要求“专业语气”,一个是要求“幽默语气”),从而建立起指令约束与输出规律之间的硬连接。
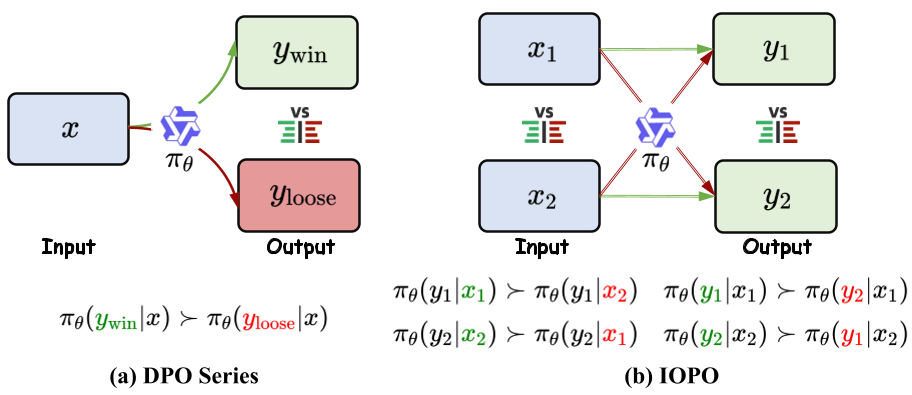 图 1:左侧为传统 DPO 范式,右侧为 IOPO 引入输入偏好后的对齐范式
2. 数学推导的直觉
IOPO 基于 Bradley-Terry 模型,将优化目标定义为最大化“匹配组”优于“错配组”的概率。最终的 Loss 函数不仅包含了对 空间的搜索,还隐含地对 空间进行了精细化的对比补偿。
TRACE:大规模复杂指令基准
为了支撑 IOPO 的训练,作者构建了 TRACE 基准:
- 5 大类型,26 个维度:涵盖内容、场景、语气、格式、示例等多维约束。
- 120K 训练集:通过自动化流程,从简单指令扩展到包含多达 15 个约束的复杂指令。
- 高质量评估:使用 GPT-4o 配合严格的人工校验(一致率达 95%)。
实验结果:全方位的跨域领先
IOPO 在多个基准上展现了绝对优势:
- 域内(TRACE):相比 DPO 提升了 1.5% - 3.0%。
- 域外(IFEval & CFBench):在极具挑战性的 IFEval 上,Qwen2-7B 模型的 Strict Accuracy 从 52.7% 提升到了 59.9%。
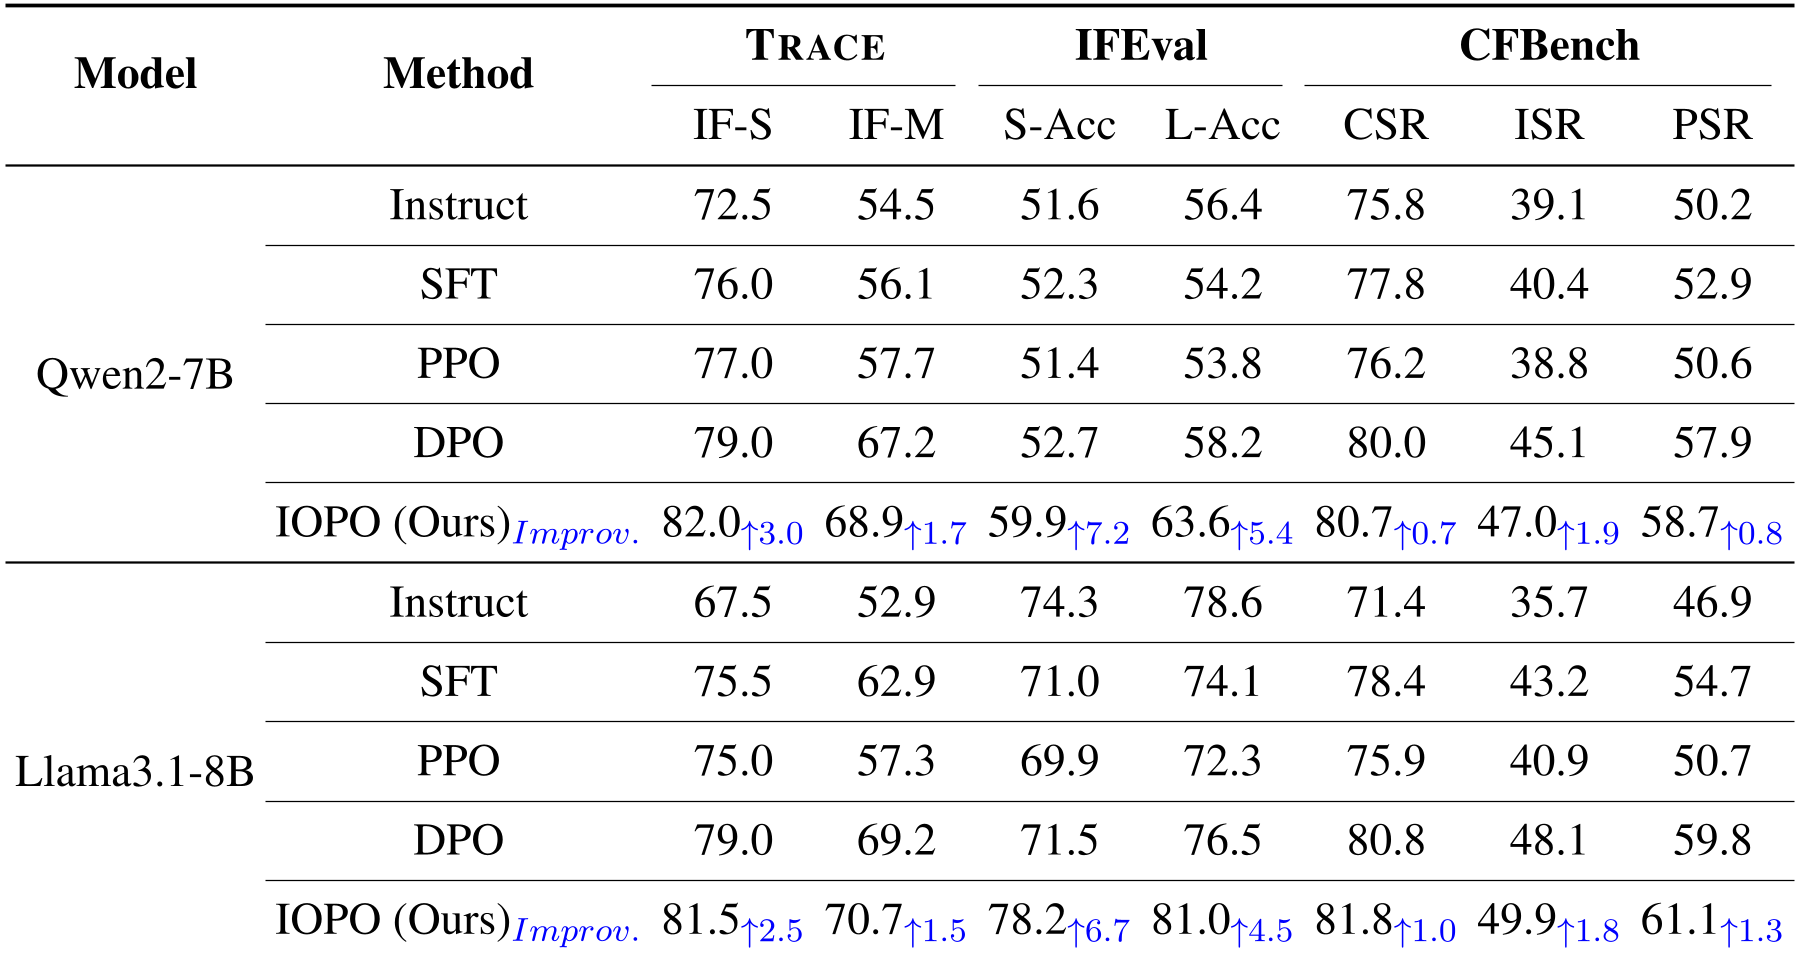 表 1:不同模型与方法在各基准上的性能对比,显示 IOPO 在各种 Backbones 上均有显著增益
深度洞察
- 数据的价值不仅在于量,更在于“对比度”:IOPO 的成功证明了,通过构造指令侧的负样本(即错配的指令),能有效缓解 LLM 的“指令疲劳”现象。
- 泛化能力:IOPO 在未见过的测试集(Out-of-domain)上表现更好,说明它学习到的是底层逻辑(约束感知),而非简单的模式匹配。
- 计算成本的权衡:虽然 IOPO 的训练显存需求大约是 SFT 的 4 倍,但在推理阶段,它完全不增加任何开销。这对于追求高性能部署的企业级 LLM 来说是非常划算的。
总结与局限
IOPO 为 LLM 复杂对齐提供了一个全新的视角:Input 同样需要 Preference。尽管其训练数据目前依赖于自动化生成,未来若能引入经过人工精修的“错配指令对”,其上限有望进一步提升。对于正在构建智能体(Agent)或自动化工作流的开发者来说,IOPO 提供的思路是解决模型“听不懂话”问题的关键钥匙。