
CKMAs:让 AI 像资深学者一样撰写文献综述
Mixture of Knowledge Minigraph Agents for Literature Review Generation
本文提出了 CKMAs (Collaborative Knowledge Minigraph Agents) 框架,一种基于大语言模型(LLM)的多智能体协作系统,专门用于自动化撰写学术论文的综述部分。通过构建动态的“知识微图(Knowledge Minigraph)”来捕捉文献间的复杂联系,并结合混合专家(MoE)策略生成多视角综述,该方法在 Multi-Xscience 等三大基准数据集上刷新了 SOTA 记录。
TL;DR
撰写文献综述是科研中最为繁琐的一环。传统的 AI 摘要往往只是简单地堆砌文献,缺乏深度的逻辑联系。本文提出的 CKMAs (Collaborative Knowledge Minigraph Agents) 框架,通过引入知识微图 (Knowledge Minigraph) 和多路径专家采样,成功让大模型学会了如何“梳理”文献间的脉络,生成的综述在逻辑性和准确性上均超过了 GPT-4。
背景定位
在学术坐标系中,CKMAs 属于 MSDS (Multiple Scientific Document Summarization) 领域的一次重大创新。它不再试图寻找一个万能的全局知识图谱,而是针对特定综述任务动态生成一份“微型地图”。
痛点深挖:为什么 LLM 写不好综述?
目前的 LLM 在处理多篇文献时,主要面临两个挑战:
- 结构化思维缺失:LLM 擅长预测下一个 Token,但不擅长显式地对比 A 算法与 B 算法在 Metric 上的细微差别。
- 长文本迷失 (Lost in the Middle):当参考文献较多时,模型往往只记得开头和结尾的文献,导致综述内容片面。
核心方法论:KMCA 与 MPSA 的协同
CKMAs 的核心直觉在于“化整为零,结构引导”。
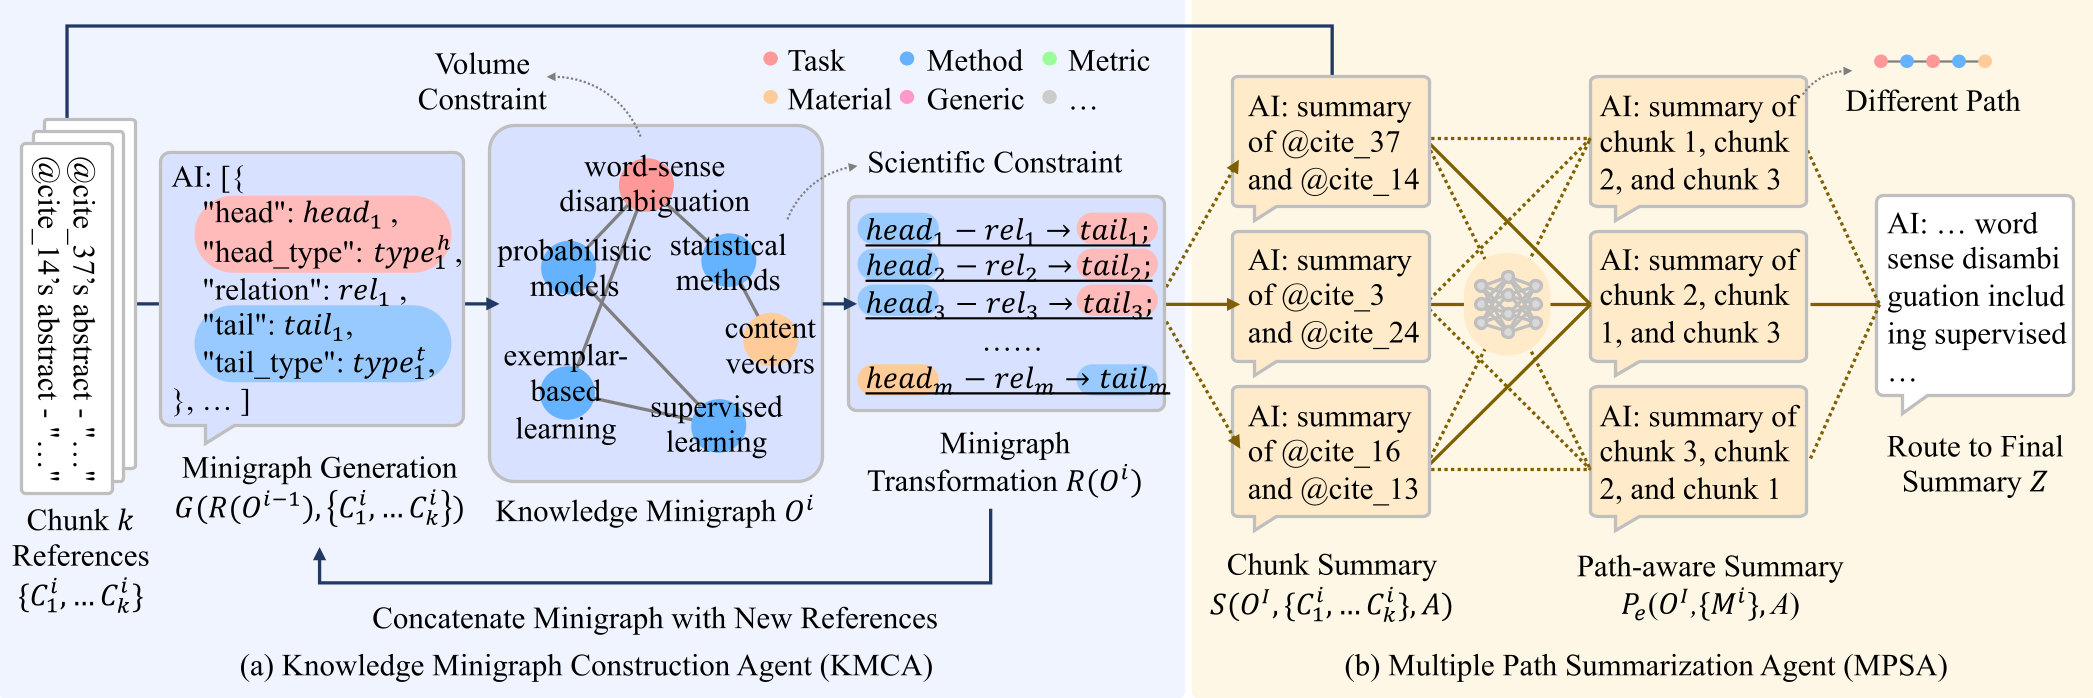
1. KMCA:构建你的“科研地图”
KMCA 并不是简单地提取关键词,它被赋予了严格的科学约束 (Scientific Constraints)。它只提取:
- 6类实体:Task, Method, Metric, Material, Generic, OtherScientificTerm。
- 7类关系:Compare, Used-for, Feature-of, Hyponym-of 等。
为了解决长文本问题,它采用迭代构建战略:先读前 3 篇,画个初稿,再读后 3 篇,在初稿上续绘。
2. MPSA:多视角叙事
科研综述没有标准答案。有人喜欢从方法演进的角度写,有人喜欢从任务分类的角度写。MPSA 借鉴了 Mixture of Experts (MoE) 的思想,通过随机打乱文献输入顺序来模拟不同的叙事视角(Path-aware),生成多个版本后,由一个路由机制选出共识度最高的一版。
实验与结果:全方位碾压
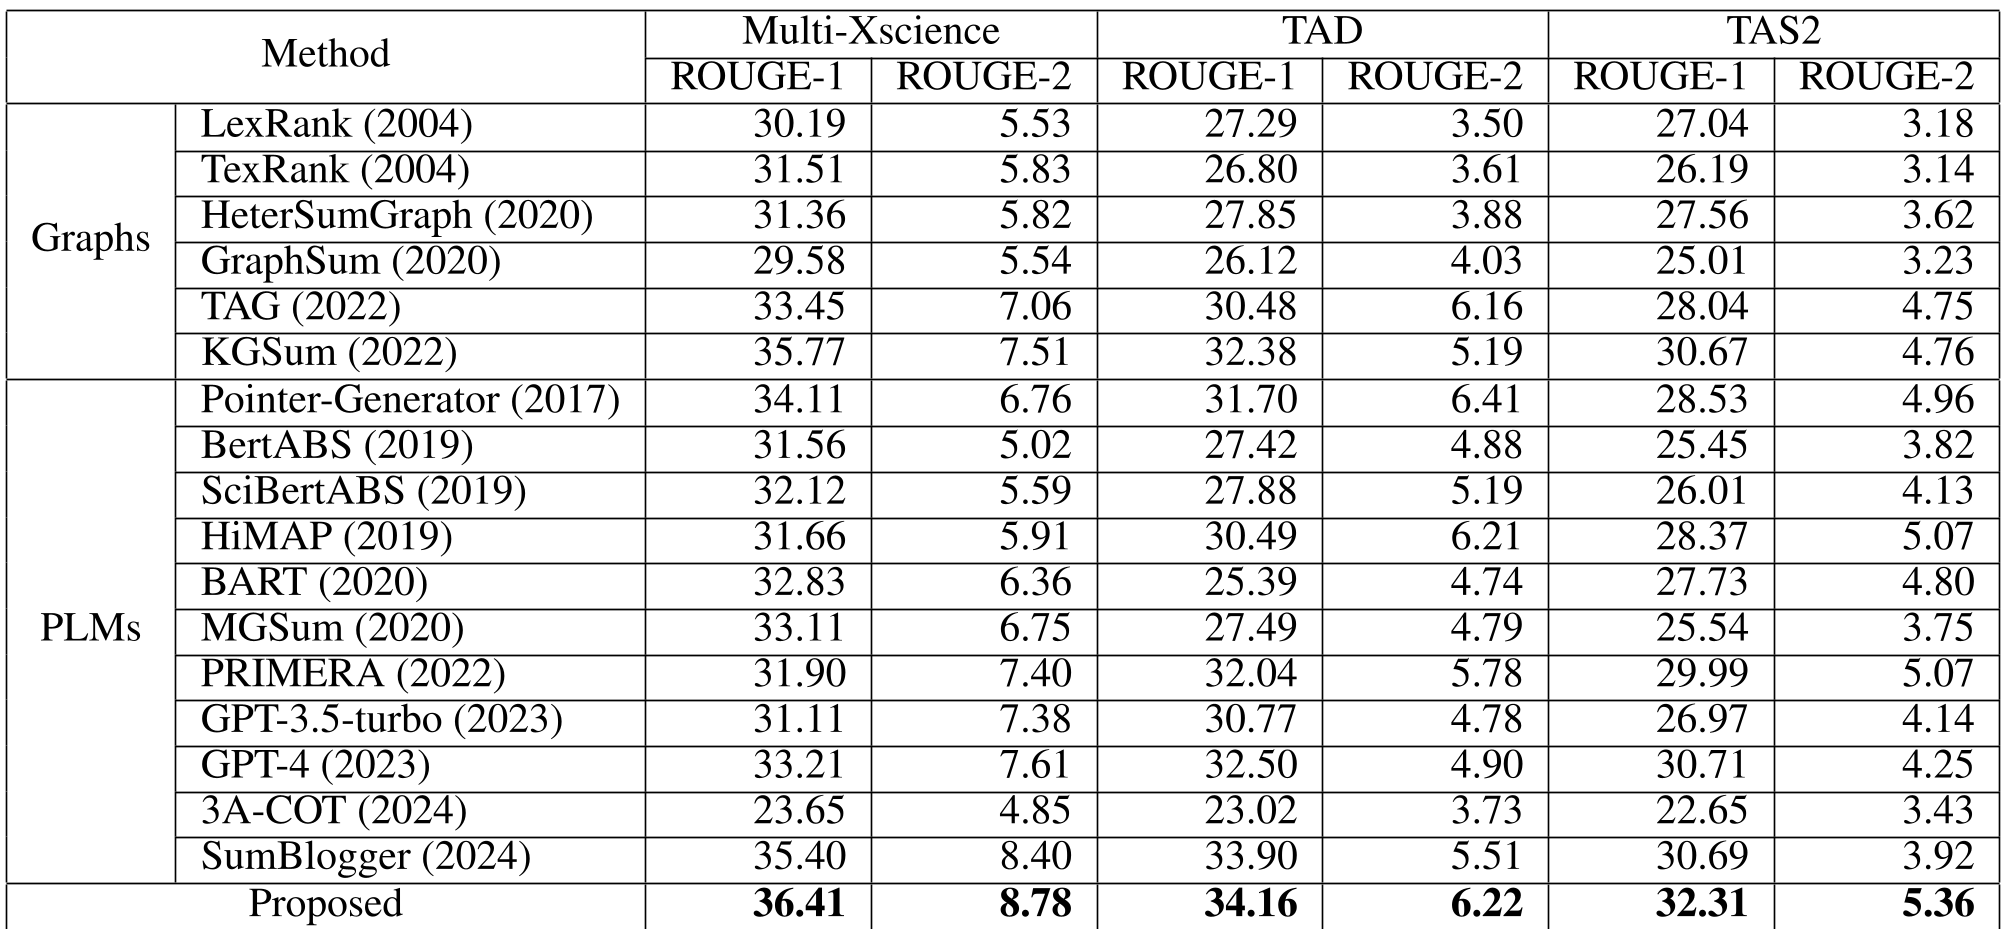
在 Multi-Xscience、TAD 和 TAS2 三个数据集上,CKMAs 表现惊艳。
核心发现:
- 量化提升:在 ROUGE 指标上,CKMAs 显著优于传统的图方法(如 LexRank)和预训练模型(如 PRIMERA)。
- 长文本优势:Case Study 显示,随着参考文献数量增加,GPT-3.5 的表现急剧下降,而 CKMAs 凭借微图的引导,性能保持稳定且差距不断扩大。
- 对比实验:消融实验证明,去掉“知识微图”后,模型的逻辑连贯性大幅受损(见 Table 3)。
深度洞察:知识微图 vs. 公共知识图谱
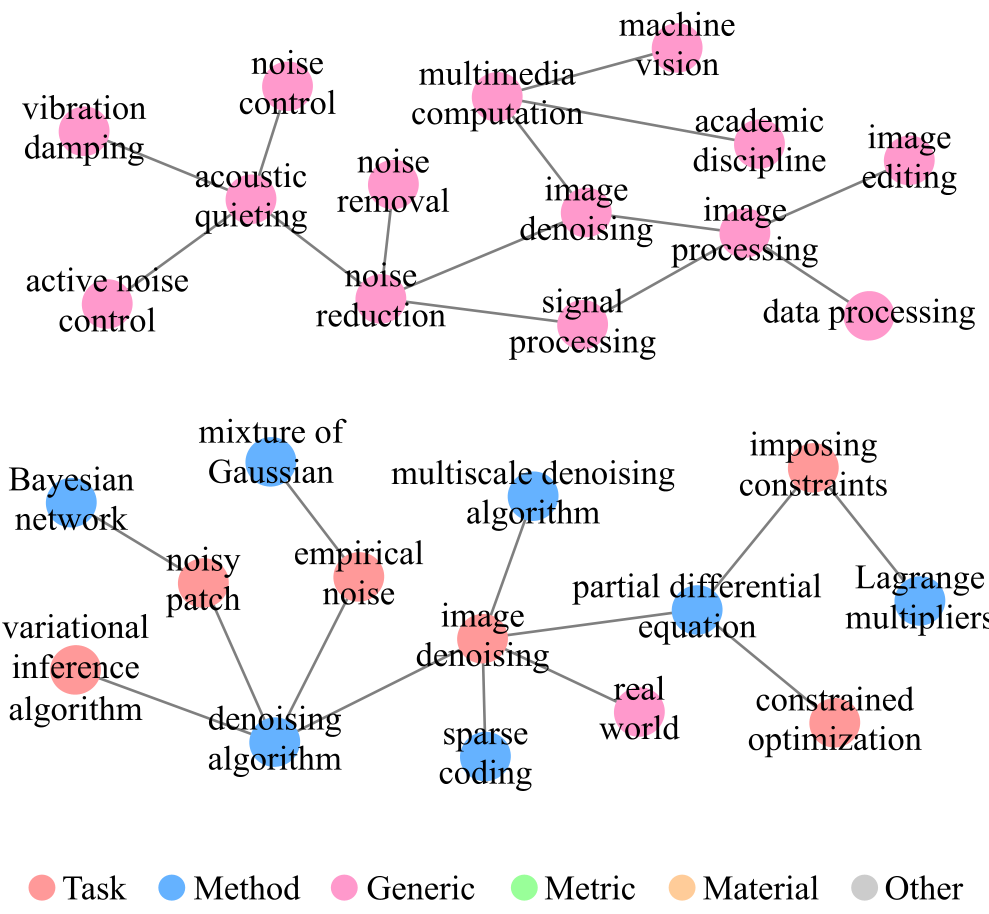
作者对比了从 Wikidata 查询的通用图谱与 KMCA 生成的微图。通用图谱虽然全面,但太“虚”,全是常识;而微图则精准锚定了任务、方法和指标,这种“Task-specific”的结构化信息才是综述写作的灵魂。
总结与局限
Takeaway:CKMAs 展示了“提示工程 + 结构化知识盒”在专业写作中的巨大潜力。它不仅提高了效率,更重要的是通过微图过滤了无关噪音,提升了生成内容的忠实度 (Faithfulness)。
局限性:尽管显著提升了效果,但在极小样本(参考文献 < 3)时提升有限,因为此时关系建模的空间较小。此外,目前主要依赖 ROUGE 分数,未来可以引入更多的人类专家评估或基于 LLM 的语义一致性评估。
本文由顶级 AI 技术主编根据最新 arXiv 论文重构而成,旨在揭示 AI 科研辅助工具的未来形态。