
ChatGPT 正在重塑论文:一项针对 82 万篇 arXiv 摘要的深度语言学调研
Examining linguistic shifts in academic writing before and after the launch of ChatGPT: a study on preprint papers
本文通过对 arXiv 平台上过去十年间的 823,798 篇论文摘要进行大规模语言学分析,研究了 ChatGPT 发布前后学术写作风格的演变。研究发现,ChatGPT 的出现显著增加了 LLM 偏好词汇的使用频率,并使学术摘要在词汇复杂度和客观性上有所提升,但在可读性和句法复杂性方面出现下降。
TL;DR
通过对过去十年 arXiv 数据的“大体检”,研究者发现 ChatGPT 的发布是一个分水岭:学术摘要变得更厚重(词汇复杂)、更客观,但同时也变得更难读、句式更简单。最令人振奋的结论是,大模型正在帮助非英语母语学者抹平语言劣势,缩小与顶尖表达之间的“跨国鸿沟”。
背景定位
本文并非传统的“AI 检测器”开发论文,而是一篇严谨的社会计算语言学研究。它在学术坐标系中首次系统性地回答了:当数以万计的科学家开始使用 LLM 润色论文时,人类的科学交流风格究竟发生了什么本质变化?
痛点与动机:从“词频”到“文风”
早期的研究大多关注“哪些词出现的概率不正常”,比如满篇的 "delve" 和 "tapestry"。但学术写作是一个复杂的系统,涉及逻辑衔接(Cohesion)和句法嵌套(Syntactic Complexity)。作者敏锐地观察到,ChatGPT 不仅仅是词典,它还是一种文风过滤器。
核心方法论:多维语言学扫描仪
研究团队构建了一个覆盖六大维度的评估矩阵。为了确保权威性,他们没有自己写脚本,而是采用了计算语言学界的“金标准”工具集(如 TAALES, TAACO):
- 词汇复杂度:考察词汇的深度、广度与功能词比例。
- 句法复杂度:计算平均句长、从句比例。
- 衔接性:通过语义重叠和连接词衡量逻辑流。
- 可读性:使用 Flesch Reading Ease 等经典指标。
- 情感与客观性:分析学术语气。
- LLM 偏好词:识别 100 个 AI 最爱用的修饰语。
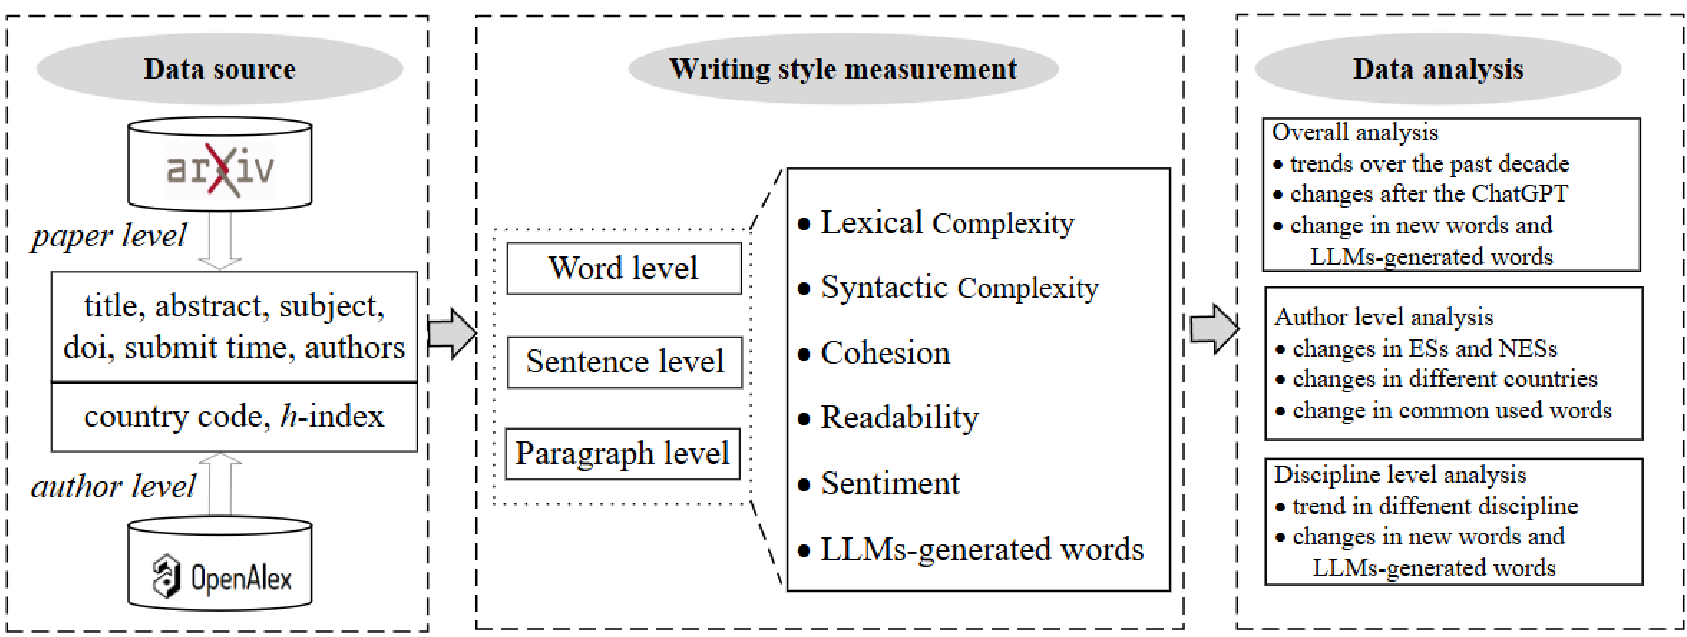 图 1:研究框架,展示了从 arXiv 数据抓取到多维指标分析的全流程
核心发现:AI 的“标准化”效应
1. 词汇与句法的“一升一降”
数据表明,ChatGPT 发布后,摘要中的新词和“AI 常用词”(如 notable, meticulously)呈爆发式增长。有趣的是,词汇变得更复杂(用了更多高级词),但句子却变简单了。这意味着 AI 倾向于用简短精炼的句子堆砌高级词汇。
2. 跨越国界的“语言均衡”
这是该研究最具社会学术价值的部分。研究发现,在 2022 年底之前,中国、印度、日本等非英语母语(NNES)学者的摘要与英美学者(NES)在衔接性和词汇复杂度上有显著代差。 然而,ChatGPT 发布后,这种差值迅速缩小。 尤其是在副词和形容词的使用上,NNES 学者的表现开始向 NES 靠拢。
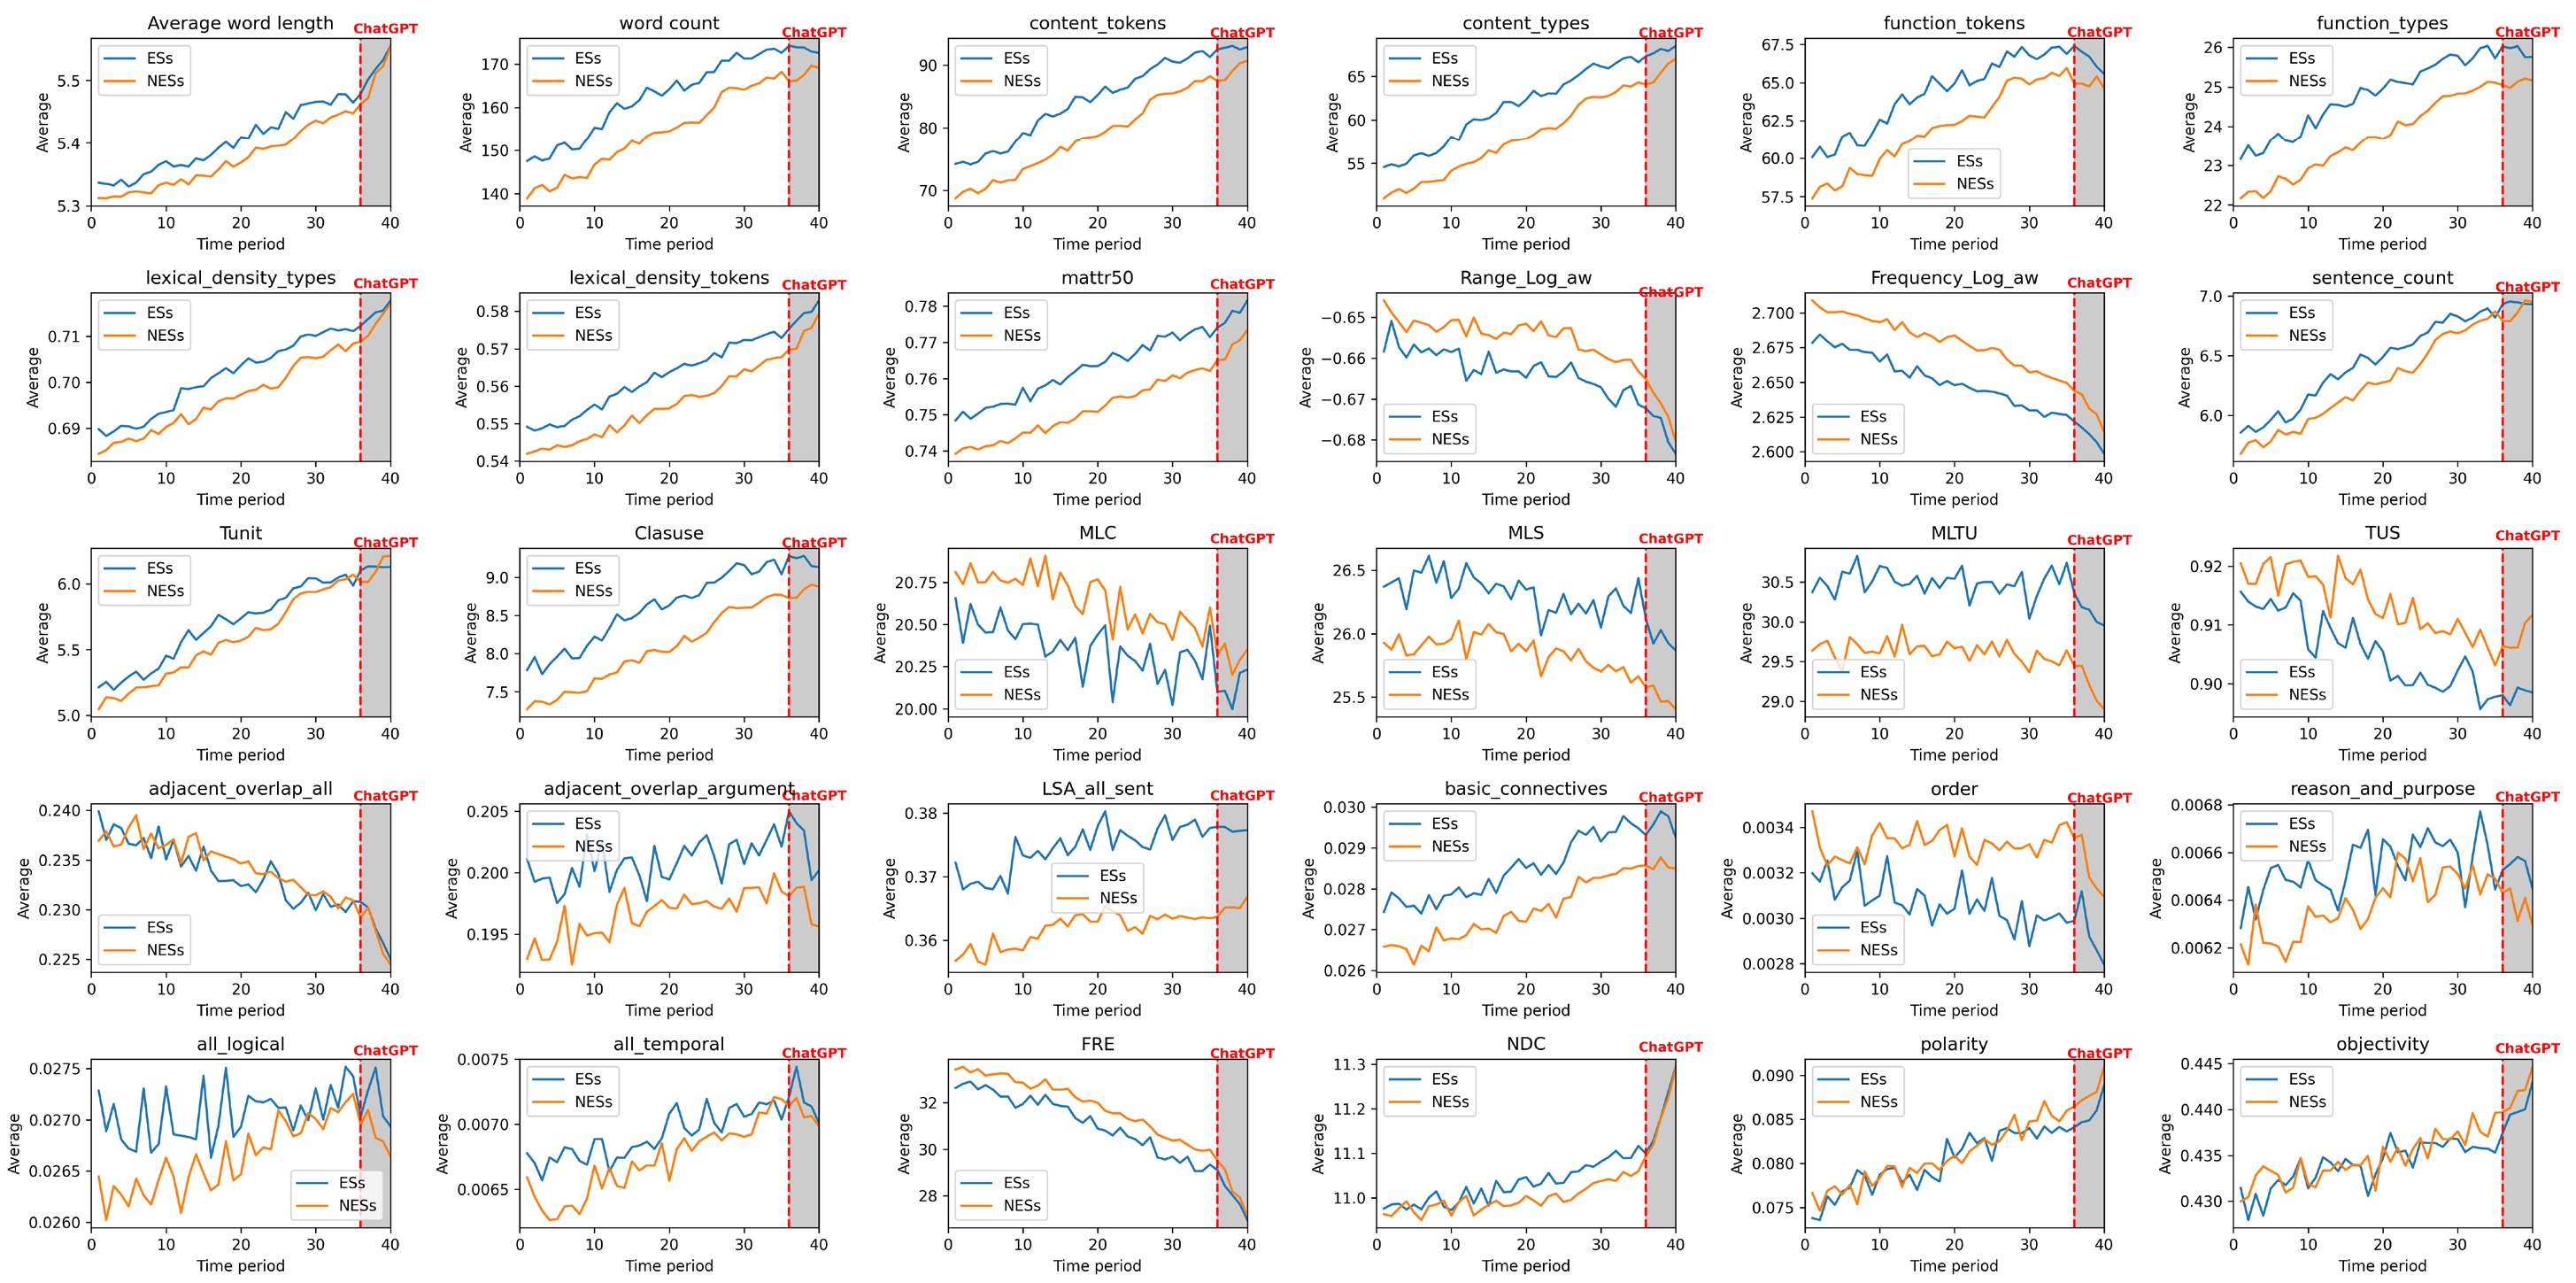 图 2:NES 与 NNES 语言学指标的演变趋势。可以看到在 ChatGPT 出现后,两者的曲线明显趋同。
3. 学科的“热度”与“冷暴力”
- 计算机科学 (CS):变化最剧烈。CS 学者最快拥抱 AI,但也导致该领域的摘要可读性下降最快。
- 物理 (Physics):稳步增长,出现了大量与 LK-99 等热点相关的新词。
- 数学 (Math):最为稳重(或保守)。AI 对数学证明风格的影响微乎其微。
趋势与实验结果对比
研究者通过 KS 检验(Kolmogorov–Smirnov test)证实了这种变化并非自然演变,而是由于外部技术干预。
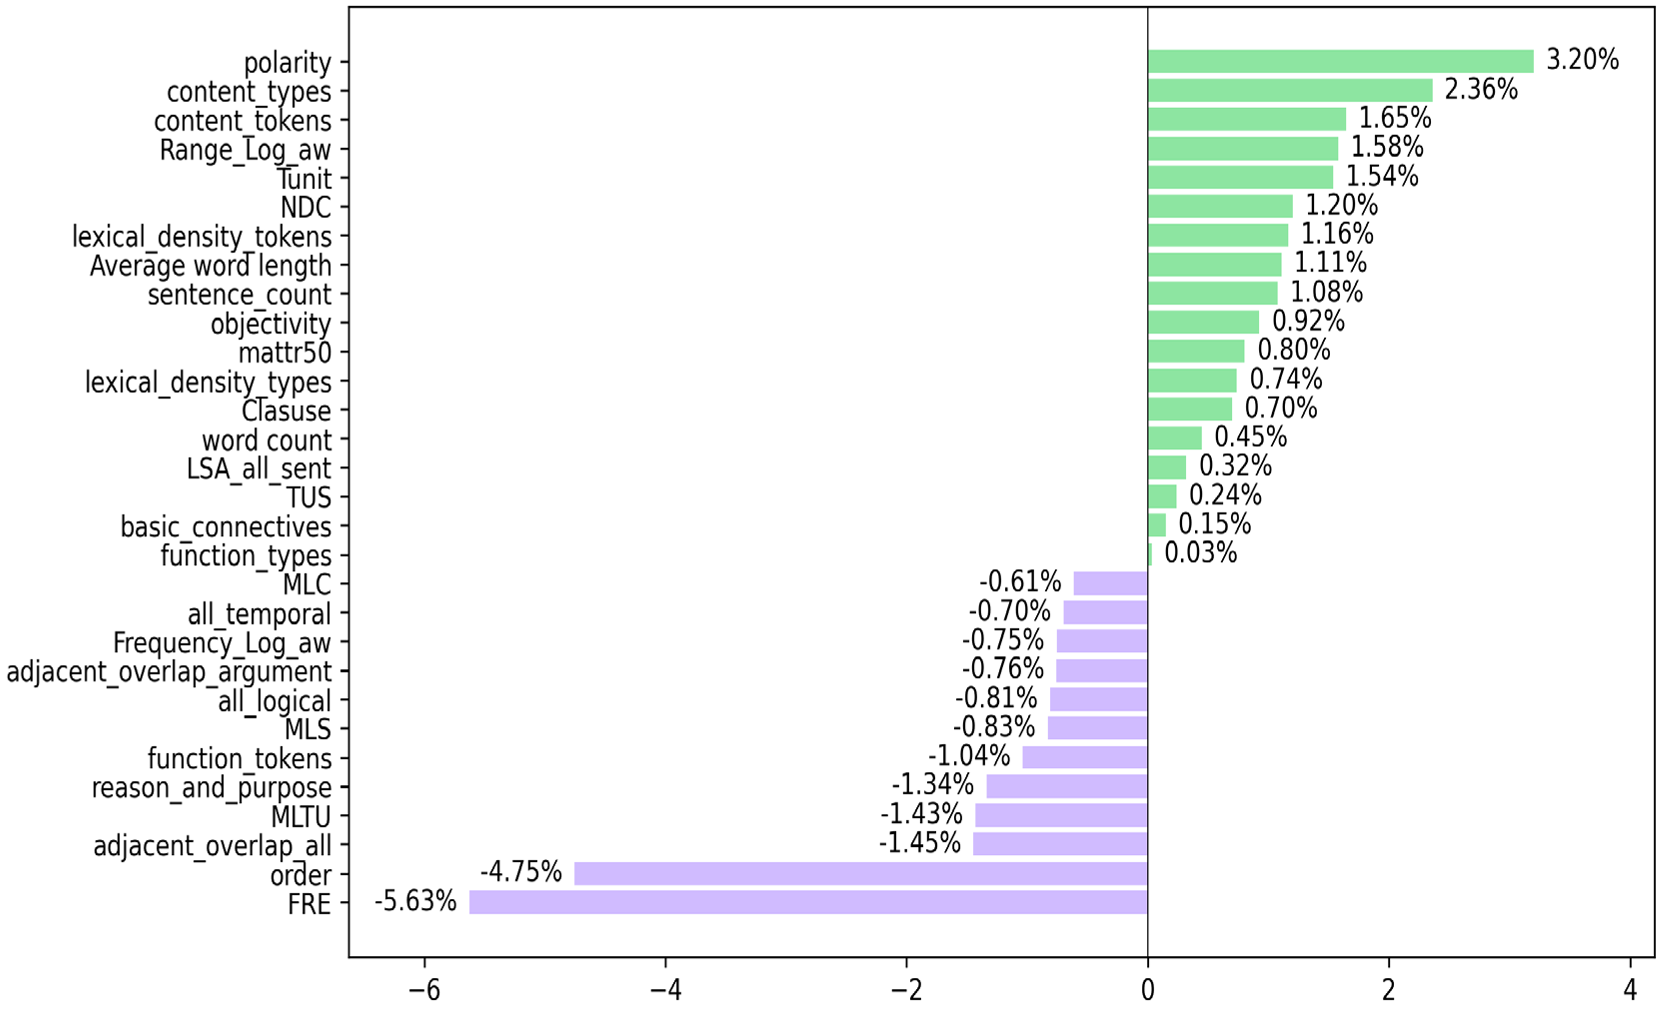 图 3:2023 年对比 2022 年的变化率。可见 POSITIVITY(正面情感)和 OBJECTIVITY(客观性)大幅上升,而 READABILITY(可读性)大幅下降。
深度洞察:机遇与局限并存
正面价值 (The Good):
- 民主化:LLM 成功充当了“免费校对员”,让即使没钱请专业化润色服务的 NNES 学者也能写出体面的摘要。
- 客观化:科学语言变得更客观中立,符合科学交流的初衷。
隐忧 (The Bad):
- 阅读负担:高级词汇的滥用和衔接词的减少,使得摘要变得“干涩”,读起来更费劲。
- 同质化:当大家都在使用同样的 AI 进行润色时,不同学科之间的“写作传统”和“文彩”可能逐渐消失。
结论与展望
这项研究提醒我们,ChatGPT 不是简单的工具,它正在修改学术界的“普通话”。对于未来的研究,作者建议关注更深层的逻辑生产而不仅仅是文本生成。未来的期刊标准可能不再是考查你是否用了 AI,而是考查你在 AI 的帮助下,是否依然保留了客观、准确且易于传播的科学精神。