
裁判的进化:基于大语言模型的 NLG 评估全景深度解析
LLM-based NLG Evaluation: Current Status and Challenges
本文由北京大学研究团队发表,是一篇关于基于大语言模型(LLM)的自然语言生成(NLG)评估方法的深度综述。文章系统性地将现有方法分类为 LLM 衍生指标、提示工程评分、模型微调以及人机协作评估,并指出 Themis 等专用评估模型在多个维度已达到或超越 GPT-4 的评估水平。
TL;DR
在自然语言生成(NLG)领域,如何客观评价“一段文字写得好不好”一直是个玄学。北京大学团队的这篇综述,从底层原理到前沿实践,拆解了 LLM 如何取代传统指标成为新一代“数字裁判”。结论非常明确:基于提示词和微调的 LLM 评估已在多个维度超越传统方法,且专用小模型(如 Themis)正在挑战 GPT-4 的权威。
痛点深挖:n-gram 的黄昏
长期以来,我们依赖 BLEU 或 ROUGE 来评价机器翻译或摘要。但这些指标本质上是“对暗号”——只要单词重叠多,分数就高。
- 语义缺失:意思完全相同但遣词造句不同的文本会得到低分。
- 事实性匮乏:模型编造事实(Hallucination)时,传统指标往往察觉不到。
- 维度单一:无法灵活处理相关性、逻辑一致性、流畅度等多维度的评价需求。
方法论详解:LLM 裁判的四种“段位”
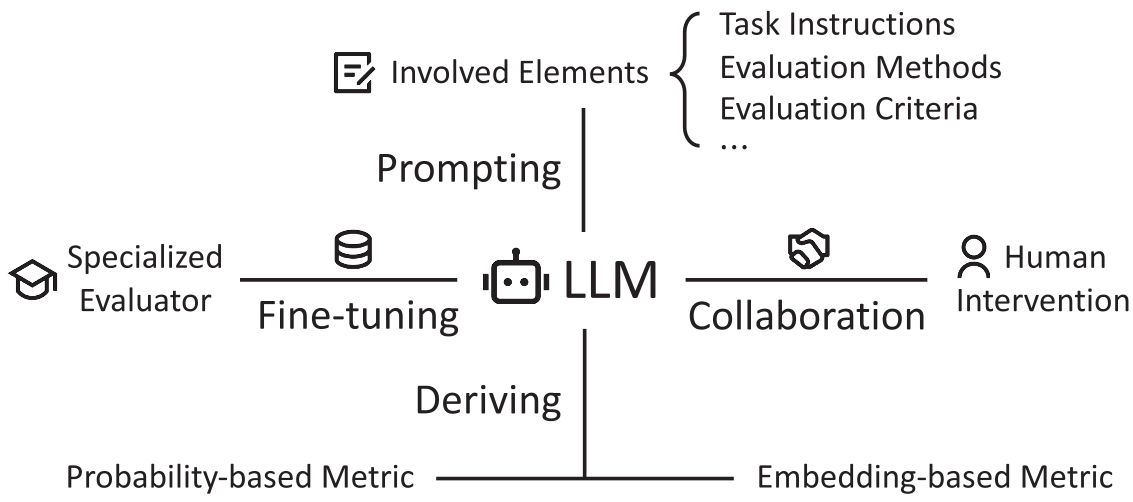
1. LLM 衍生指标 (LLM-derived Metrics)
这是最接近传统方法的升级版。它利用模型的内部状态,如:
- Embedding-based:计算向量空间中的余弦相似度。
- Probability-based:如 GPTScore,通过计算模型生成该文本的条件概率(Log-likelihood)来评分。其物理直觉是:一个训练良好的模型,赋予高质量文本的概率自然更高。
2. 提示工程 (Prompting LLMs)
这目前应用最广。通过巧妙的 Prompt(如 Chain-of-Thought, CoT),让 LLM 扮演人类评估者。
- 关键架构:包括评分(Scoring)、成对比较(Comparison)和错误分析(Error Analysis)。
3. 微调专用裁判 (Fine-tuning LLMs)
虽然 GPT-4 很强,但 API 又贵又慢,且存在不可复现性。研究者开始微调 7B 或 13B 的开源模型(如 Prometheus, PandaLM, Themis)。这些模型通过在高质量的人类评分数据或 GPT-4 蒸馏数据上学习,成为了高效的“持证裁判”。
4. 人机协作 (Human-LLM Collaboration)
承认 LLM 非万能。例如 COEVAL 框架中,人类设计检查清单(Checklist),LLM 执行大规模初筛,人类再对争议点进行终审。这种模式在准确性上达到了当前的顶级 SOTA 水平。
实验与结果:谁才是最公正的法官?
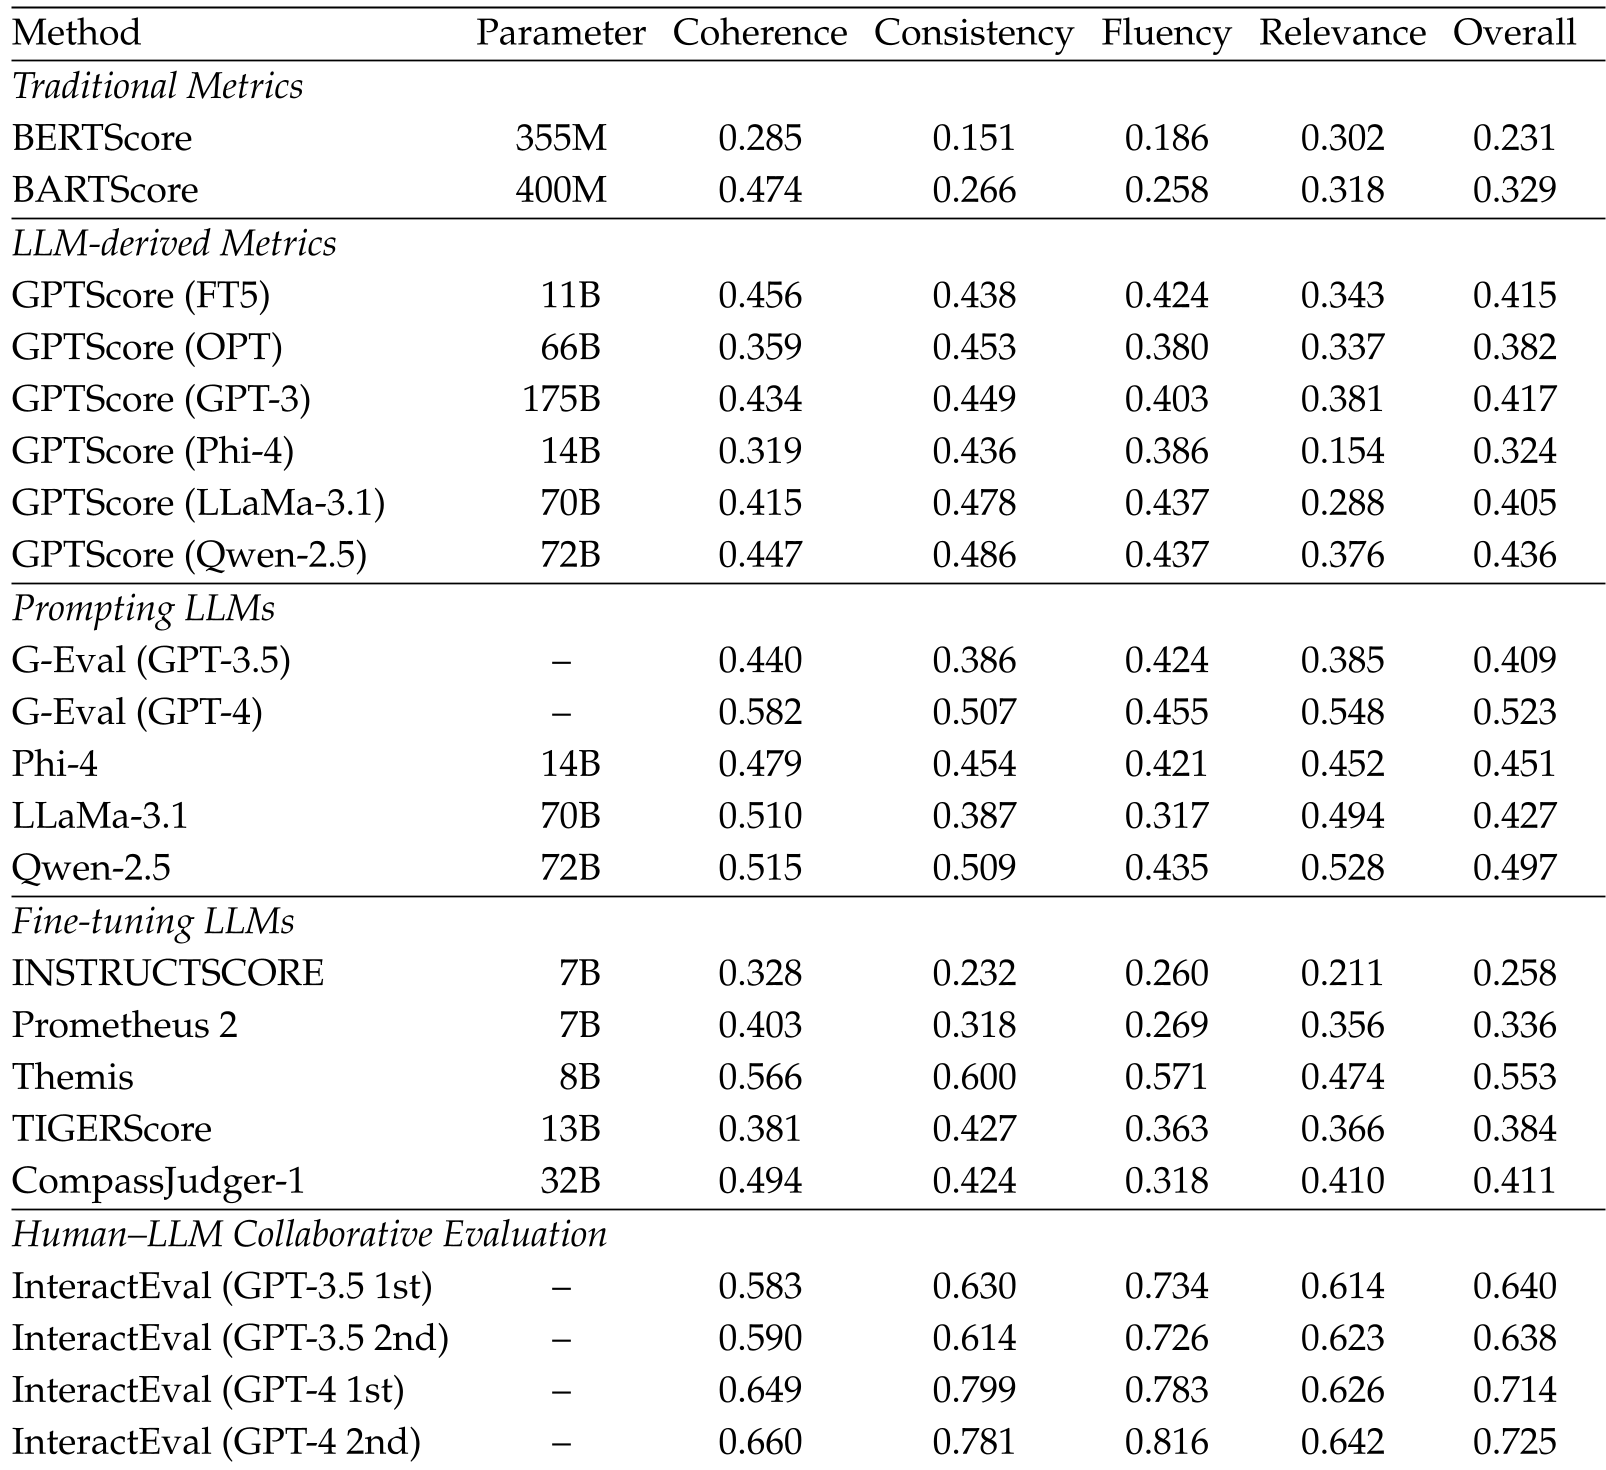
在经典的 SummEval 摘要评估基准上,各路方法进行了硬碰硬的较量:
- 关键结论:
- GPT-4 (G-Eval) 的表现远超 BERTScore 等传统模型。
- Themis-8B 等专用微调模型在一致性(Consistency)维度甚至超过了 GPT-4,证明了“术业有专攻”。
- InteractEval(人机协作)在流畅度和总体评分上表现最强,证明了人类直觉的不可替代性。
深度洞察:裁判也有偏见
虽然 LLM 评估前途光明,但文章客观地指出了 LLM 裁判的三个“职业道德”缺陷:
- 位置偏见 (Position Bias):在比较两段文字时,LLM 往往倾向于给排在前面的那个打高分。
- 长度偏见 (Verbosity Bias):LLM 喜欢“字多”的回答,哪怕内容有水分。
- 自恋偏见 (Self-bias):LLM 倾向于给那些跟自己写作风格相似的回复打高分。
总结与未来展望
基于 LLM 的 NLG 评估正在经历从“黑盒评分”到“可解释分析”的转变。未来的研究重心将转向:
- 低资源语言:英语之外的评估能力仍需填补。
- 统一基准:建立更大规模、包含最新 LLM 生成文本的测试集。
- 动态评估:针对科学评论、创意写作等复杂新场景定制裁判模型。
这篇论文为从业者提供了一份详尽的“避坑指南”和“工具箱选择策略”,是构建可靠 NLG 应用系统的必读之作。