
《LLMs for Knowledge Graph Construction and Reasoning:为什么 GPT-4 更像 KG 推理助手,而不是信息抽取器》
Llms for knowledge graph construction and reasoning: Recent capabilities and future opportunities
本文是一篇面向 Knowledge Graph (KG) 构建与推理的系统性评测论文,围绕 GPT-4、ChatGPT 与 text-davinci-003 在 8 个数据集、4 类代表任务上的 Zero-shot/One-shot 能力展开定量与定性分析,并进一步提出 Virtual Knowledge Extraction 与 AutoKG。核心结论是:GPT-4 并不擅长作为 few-shot 信息抽取器,但在 KG reasoning 上显著更强,甚至在部分 QA/Link Prediction 场景逼近或超过监督式 SOTA。
核心速览
TL;DR
这篇论文不是在提出一个新的端到端模型,而是在回答一个更基础、也更关键的问题:大语言模型到底适不适合做 Knowledge Graph (KG) 的构建与推理?
作者在 8 个数据集、4 类任务上系统比较了 text-davinci-003、ChatGPT 和 GPT-4 的 Zero-shot/One-shot 表现,结论很鲜明:
- 在 KG construction 相关的信息抽取任务上,GPT-4 虽然比 ChatGPT 强,但仍明显落后于 fully supervised 小模型;
- 在 KG reasoning 任务上,GPT-4 表现显著更好,部分场景逼近甚至超过监督式 SOTA;
- 为了验证这不是单纯“背题库”,作者又设计了 Virtual Knowledge Extraction 与 VINE,发现 GPT-4 确实具备一定 instruction-driven generalization;
- 基于这些观察,作者提出了 AutoKG:把 LLM 放在多智能体、外部检索增强的自动化 KG 构建/推理框架里。
背景定位
这项工作更像一篇领域坐标系校准论文,而不是单点刷榜论文。它的价值不在于某一项 benchmark 上多拿了几个点,而在于明确了一个重要判断:LLM 在 KG 生态中的自然角色更偏 reasoning assistant,而不是 few-shot extractor。这个判断对后续系统设计非常关键。
痛点与动机
Knowledge Graph 的经典流程通常分成两大块:
- Construction:从文本中抽取实体、关系、事件,形成结构化三元组或事件图;
- Reasoning:在已有 KG 上做 Link Prediction、KBQA、多跳推断等。
过去几年,很多人看到 GPT-4 这类模型“什么都能做”,自然会问一个问题:
既然 LLM 已经有强大的语言理解与生成能力,它能不能直接替代传统 KG pipeline?
但这个问题其实被混淆了两层:
-
抽取能力和推理能力不是一回事。
从一句复杂文本中稳定抽出 schema-constrained triples,本质上是高精度结构映射问题;而回答问题、补全链接,则更多依赖语义归纳、知识联想和推断能力。 -
LLM 的高分到底来自:
- 真正的 generalization,
- 还是预训练中已经见过相关知识的 memorization?
这正是本文的切入点。作者并没有预设“LLM 一定更强”,而是用系统评测去拆解这个命题。
先看论文整体框架图,它基本概括了整篇文章的三层逻辑:评测、去记忆化验证、系统机会点。
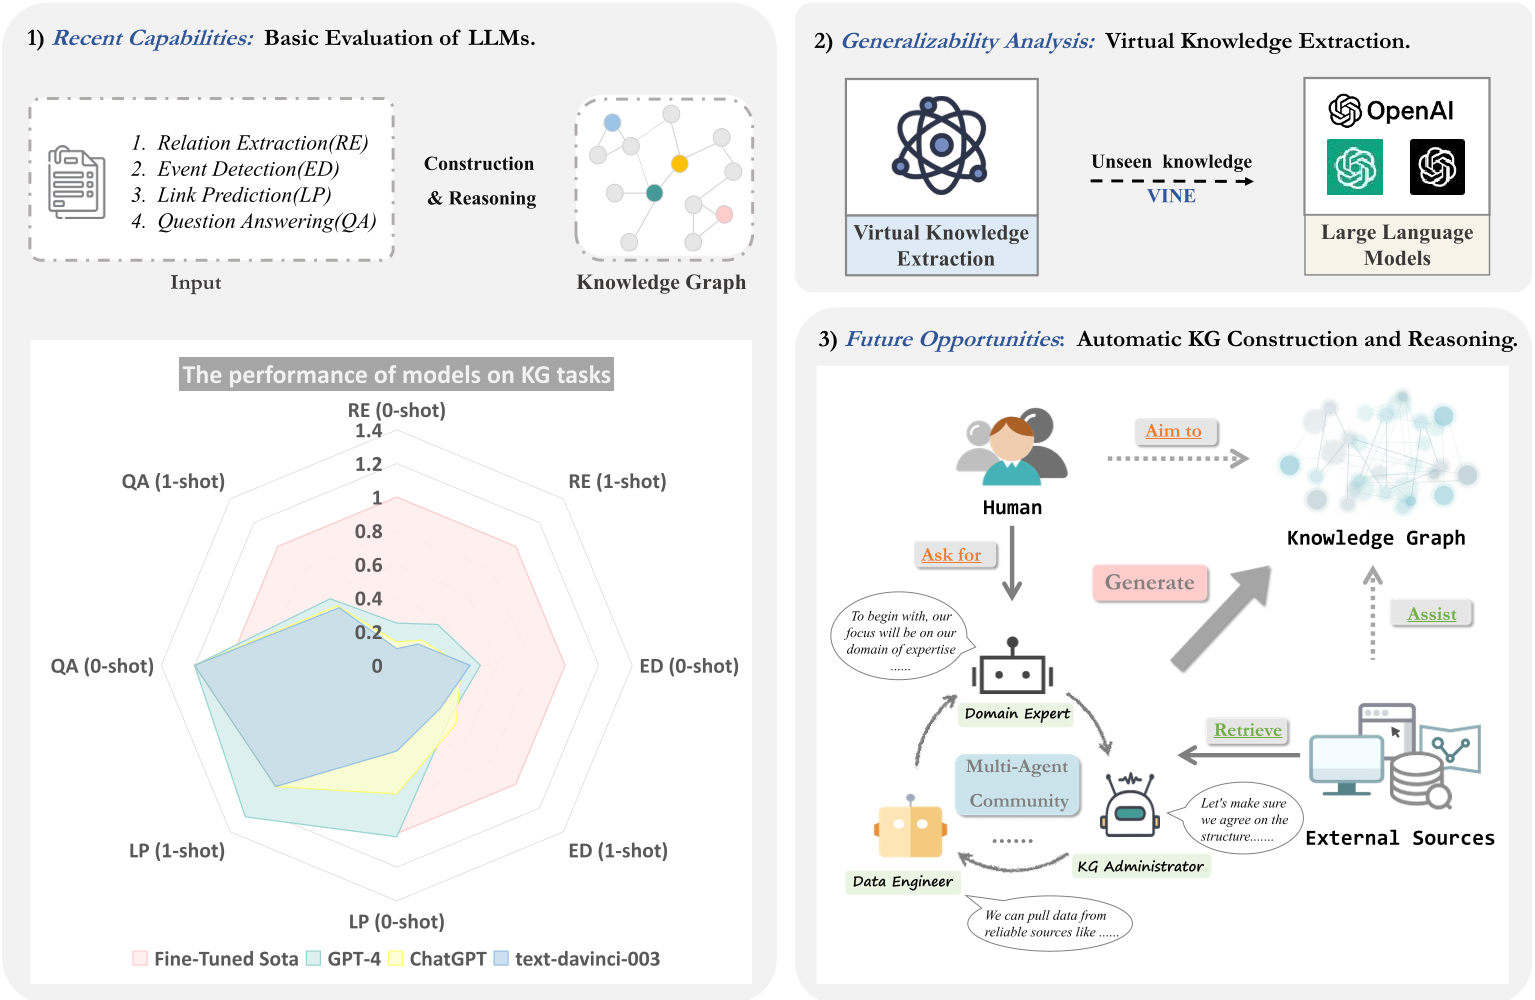
从图里可以看出,作者不是只做 benchmark 对比,而是试图给出一个更完整的叙事链条:
- 先评估现状;
- 再追问“为什么会这样”;
- 最后提出“未来该怎么用”。
方法论详解
1. 评测协议:跨 construction 与 reasoning 的统一观察
作者选择了 4 类代表任务:
- Entity and Relation Extraction
- DuIE2.0
- Re-TACRED
- SciERC
- Event Extraction
- MAVEN
- Link Prediction
- FB15K-237
- ATOMIC2020
- Question Answering
- FreebaseQA
- MetaQA
评测设置聚焦于:
- Zero-shot
- One-shot
而不是大量 in-context examples。这个设计本身就带有明确意图:作者关心的是 LLM 在低资源、弱监督条件下的可用性,而不是 prompt engineering 能堆到多高。
评价方式也很直接:
- 用 GPT 系列模型横向比较;
- 用 fully supervised SOTA 作为上界参照;
- 进一步比较 construction 与 reasoning 任务中,LLM 距离 SOTA 的“差值”。
这背后的直觉其实很重要:
如果一种模型真的适合 KG construction,它就应该在结构化抽取任务里接近监督模型;如果它更适合 reasoning,那么在 QA 或 link prediction 上应该明显更强。
2. 为什么信息抽取更难?
论文里的一个核心观察是:LLM 在抽取任务中并不稳定。
这不是因为它“看不懂句子”,而是因为 KG construction 对输出空间有额外约束:
- 需要找到精确 span;
- 要遵守给定 relation schema;
- 要避免多抽、漏抽、错配;
- 对近义词、隐式关系、复杂句法非常敏感。
换句话说,抽取不是一般意义上的语言理解,而是高精度结构对齐。
论文给出的案例很能说明问题:在 Re-TACRED 等数据上,ChatGPT 往往无法正确识别 head-tail 与 predicate 的精确组合,而 GPT-4 虽然更好,但仍不稳定。
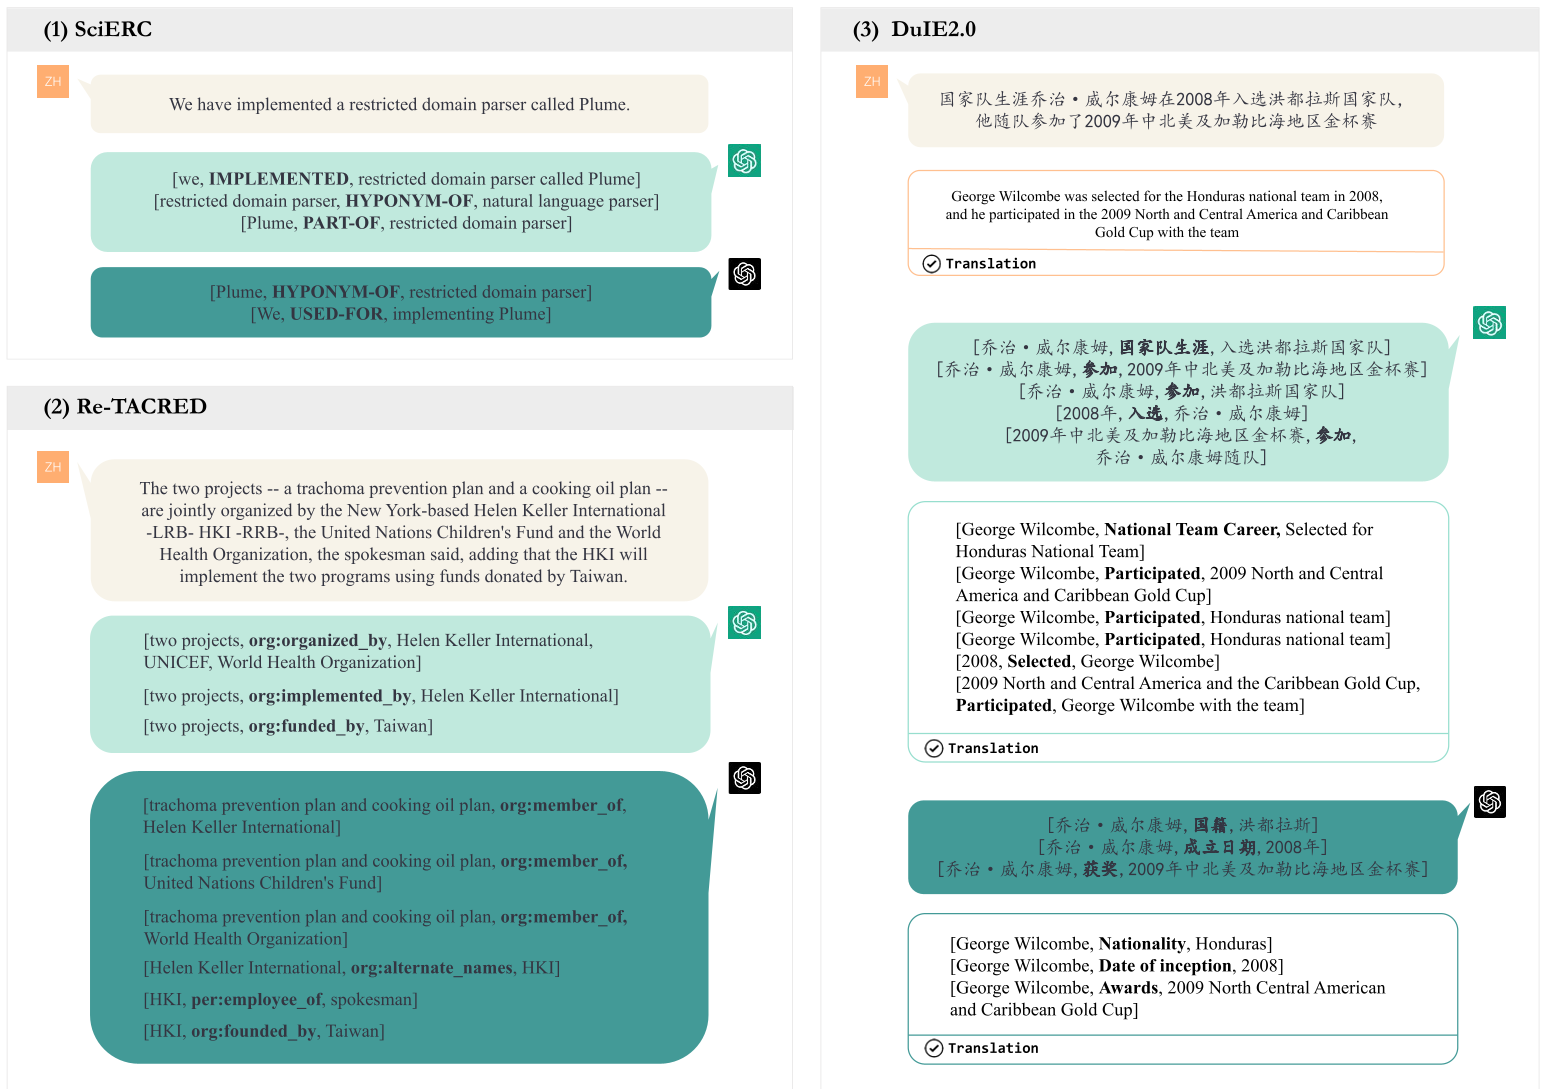
从这个现象可以提炼出一个更深的机制解释:
- LLM 擅长的是“生成一个合理答案”;
- IE 任务要求的是“生成唯一且结构合法的答案”。
这两者之间并不天然一致。
尤其在存在多个候选关系、实体相邻、句法歧义强时,LLM 的生成分布会偏向“语义上说得通”,而不是“标注上唯一正确”。
3. Virtual Knowledge Extraction:把“记忆”因素剥离掉
如果仅用现有 benchmark 做评测,始终有一个疑问无法排除:
GPT-4 在某些任务上表现不错,到底是因为真的学会了抽取,还是因为预训练中见过这些实体和关系?
为了解决这个问题,作者提出 Virtual Knowledge Extraction,并构建了 VINE 数据集。
核心做法很巧妙:
- 从 Re-TACRED 的结构出发保留句法模板;
- 把真实实体、真实关系替换成虚构词;
- 构造模型在预训练中极不可能见过的“虚拟知识”。
这样一来,如果模型还能通过少量 demonstrations 学会抽取,就更能说明它具备某种真正的 in-context generalization,而不只是知识回忆。
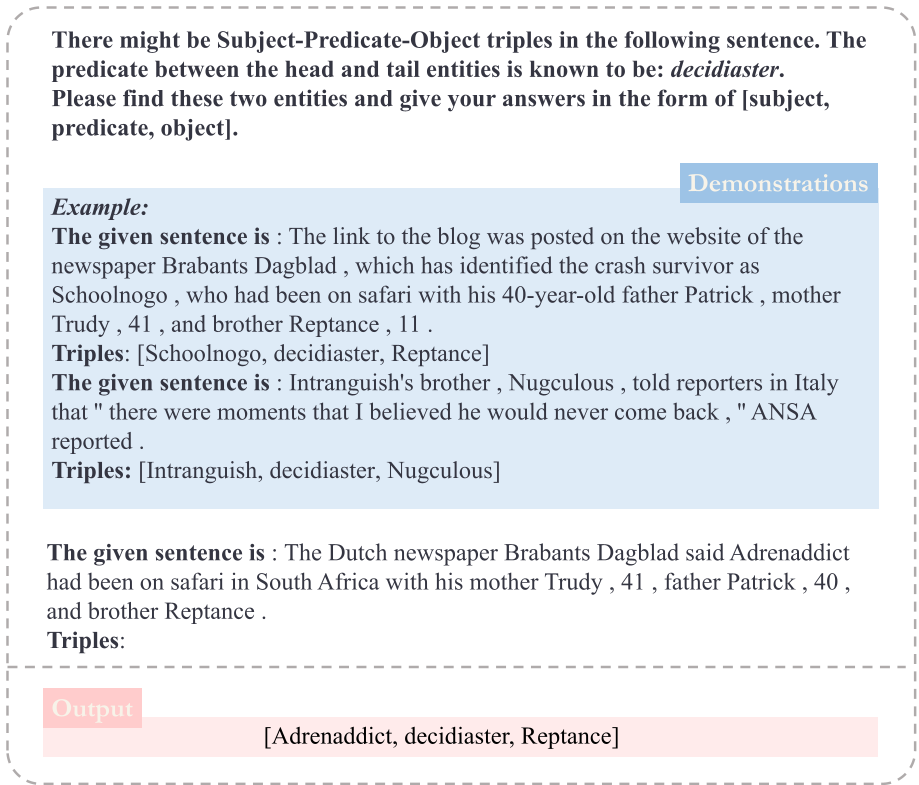
这个设计的学术意义其实不小。它在做的是一种“能力因果剥离”:
- 现实 benchmark 混合了知识记忆与任务泛化;
- VINE 尝试只保留后者。
结果也很清楚:
- GPT-4:80%
- ChatGPT:27%
这说明 GPT-4 至少不是纯粹在“背 KG”,它确实能通过 instruction 学到新的抽取规则。
但这里也要保持克制:
这并不等于 GPT-4 已经是优秀的信息抽取器。它只说明 GPT-4 有泛化潜力,而不是说明它在真实复杂 IE 场景中就能稳定替代监督模型。
4. AutoKG:从“单模型做任务”转向“多智能体做系统”
在完成能力边界分析后,作者提出 AutoKG 的设想:
既然 LLM 更像 reasoning assistant,而且它又依赖 prompt、存在 cutoff 与 hallucination,那么更合理的方向不是让单个模型独立完成所有步骤,而是把它放进一个多智能体 + 外部资源增强的系统里。
AutoKG 的组成包括:
- KG assistant agent
- KG user / domain expert agent
- task-specifier agent
- web searcher agent
- 外部资源:知识库、已有 KG、互联网检索
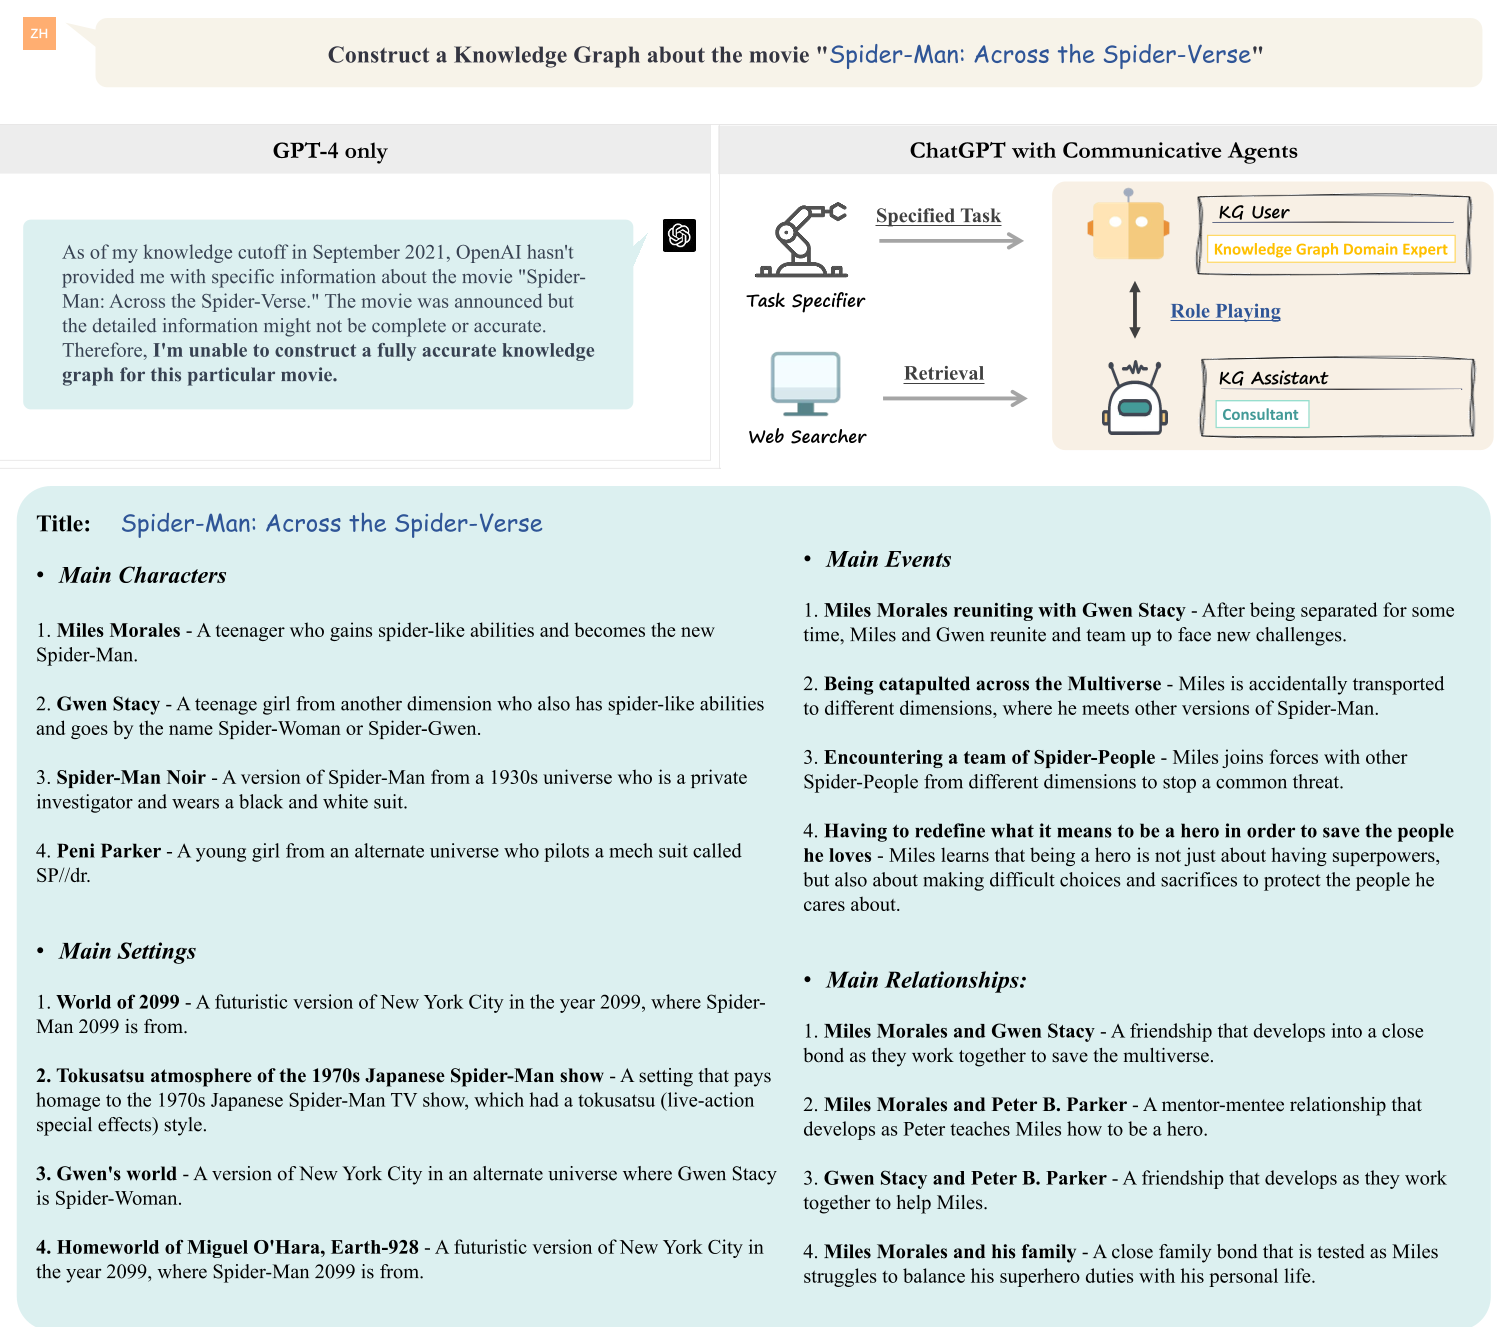
这个框架背后的 intuition 很直接:
- LLM 内部知识提供语义联想与推理能力;
- 外部检索补足知识截止与事实更新问题;
- 角色分工缓解单次 prompt 过载;
- 多轮交互让复杂 KG 任务分解为一系列可验证子任务。
本质上,AutoKG 不是在改模型参数,而是在改系统组织方式。
这与当前 agentic AI 的主流趋势是一致的。
实验与结果
1. 总体结论:construction 弱,reasoning 强
先看核心总表。
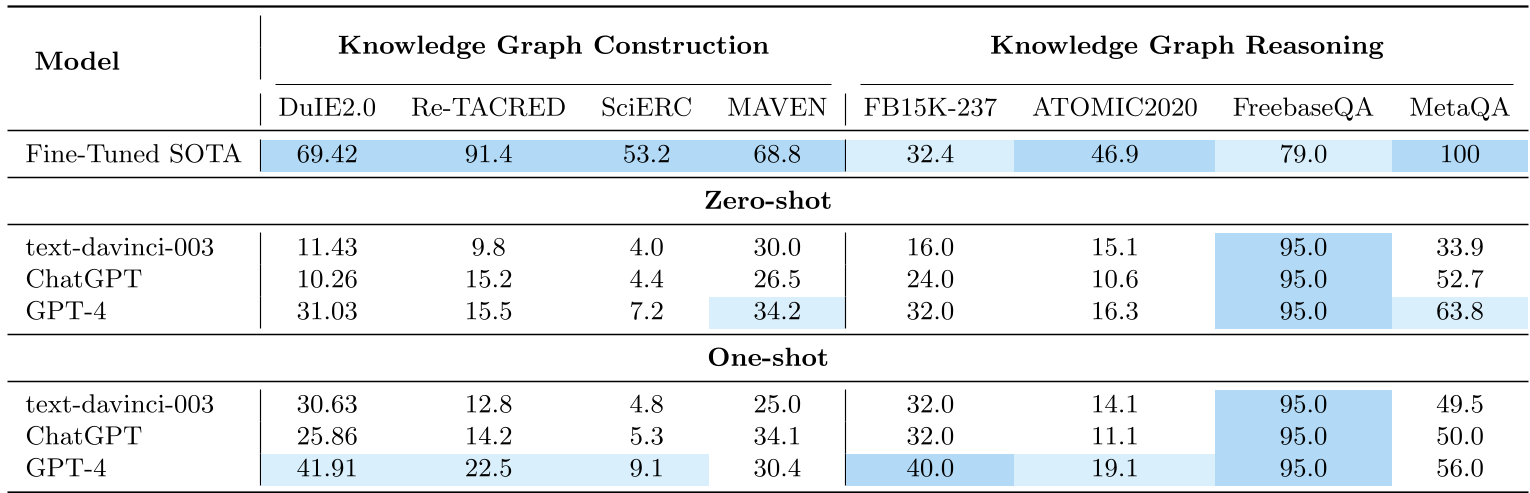
这张表最值得读的不是单项最好分数,而是不同任务类型的落差结构。
KG construction:明显落后监督式模型
GPT-4 One-shot 成绩:
- DuIE2.0:41.91 vs. SOTA 69.42
- Re-TACRED:22.5 vs. 91.4
- SciERC:9.1 vs. 53.2
- MAVEN:30.4 vs. 68.8
这里有两个直接结论:
- GPT-4 确实比 ChatGPT 更强;
- 但“更强”不等于“足以替代 fine-tuned IE model”。
尤其在 SciERC 这种专业领域数据上,GPT-4 依然很弱,说明其 domain-specific extraction 能力不足。
KG reasoning:更接近甚至超越 SOTA
GPT-4 的 reasoning 表现明显更亮眼:
- FB15K-237 One-shot:40.0 vs. SOTA 32.4
- ATOMIC2020 One-shot:19.1 vs. SOTA 46.9,仍有明显差距
- FreebaseQA Zero-shot/One-shot:95.0 vs. SOTA 79.0
- MetaQA Zero-shot:63.8,显著优于 ChatGPT 的 52.7
其中最值得注意的是:
- FreebaseQA:LLM 直接超过监督式模型;
- FB15K-237:GPT-4 已经接近甚至超过传统 KGC baseline;
- MetaQA:多跳、多答案设置下仍有明显提升,但距离最优解还有差距。
这说明 GPT-4 更擅长的是:
- 利用已有知识进行语义补全;
- 在问题上下文中做多跳联想;
- 进行“答案级推断”而不是“标注级抽取”。
2. Zero-shot 与 One-shot 并不总是单调提升
一个有意思的细节是:One-shot 不是总能带来增益。
例如在 QA 上:
- FreebaseQA:GPT-4 Zero-shot 和 One-shot 都是 95.0,没有提升;
- MetaQA:GPT-4 反而从 63.8 降到 56.0。
作者把这一现象归因于 alignment tax:
经过 RLHF 对齐后的模型,可能牺牲了一部分纯粹的 in-context learning 效率。
这点很重要,因为很多人对 LLM 的直觉是“加 exemplars 总会更好”。
但本文说明:对于强对齐模型,prompt 中多一个示例可能同时带来:
- 格式约束收益;
- 分布偏移副作用。
换句话说,One-shot 并不是免费的午餐。
3. 专业领域比通用领域更难
作者专门比较了:
- 通用域:Re-TACRED
- 专业域:SciERC
结果表明 GPT-4 在 SciERC 上明显更差。
这很好理解,因为专业抽取并不只依赖一般语言能力,还依赖:
- 术语识别;
- 学科 schema;
- 领域内隐含关系模式。
对通用模型而言,这类 Inductive Bias 并不天然存在。
所以“LLM 通用能力很强”并不自动推出“它能做好专业 IE”。
4. 误差来源分析是这篇论文的加分项
作者没有把低分简单归因为“模型不够强”,而是指出三类因素:
-
Dataset Quality
- 标签噪声
- 上下文复杂
- 标注不完备
-
Instruction Quality
- prompt 语义深度影响很大
- demonstration 的选择会改变结果
-
Evaluation Methods
- 生成式答案未必与 gold string 完全匹配
- 同义表达可能被错判
- 现有评测更适合分类器,不完全适合生成模型
这其实是在提醒读者:
LLM for KG 的评测问题,本身就是研究问题,而不只是工程实现问题。
深度洞察与总结
这篇论文最重要的结论是什么?
如果只用一句话概括:
LLM 在 KG 中最有价值的定位,不是替代 IE pipeline,而是充当 reasoning-centric interface。
更细一点说,这篇论文给出了三层判断:
- 能力判断:GPT-4 的 reasoning 明显强于 construction;
- 机制判断:它的强项并不只是预训练记忆,VINE 说明其确有一定 contextual generalization;
- 系统判断:未来高价值形态是 AutoKG 这类多智能体、检索增强、可交互的协同系统。
为什么这个判断有现实意义?
因为它直接影响产品与研究路线。
如果你把 LLM 当成 IE 主引擎,可能会遇到:
- 抽取边界不稳定;
- schema 约束难以保证;
- 专业领域精度不够;
- 输出验证成本高。
但如果把它当成:
- 推理器、
- 重排序器、
- 交互式 KG assistant、
- 检索增强控制器,
它的优势就能更自然地释放出来。
这与后来很多工作中的趋势是一致的:
LLM 不一定是最好的 extractor,但常常是很好的 coordinator、reasoner 和 interface。
局限性
这篇论文也有明显限制,不能忽视:
- 样本量偏小:多处实验仅随机抽取 20 或 25 个样本,统计稳定性有限;
- 时间敏感性强:评测发生在 2023 年,模型版本与接口行为可能已变化;
- 非 API 评测:交互界面测得的结果可复现性较弱;
- AutoKG 仍偏概念验证:缺乏大规模、严格控制变量的系统实验;
- VINE 的“虚拟知识”仍接近 relation extraction 模板迁移,对更开放、更复杂的泛化能力刻画仍有限。
也就是说,这篇文章更像是一个高价值的阶段性判断,而不是终局结论。
未来展望
从今天回看,这篇论文最值得继续推进的方向有三个:
-
更合理的生成式 KG 评测
- 不只看 exact match;
- 需要支持同义词、结构等价、部分正确;
-
LLM + symbolic / retrieval 混合系统
- 让 LLM 负责规划、解释、交互;
- 让检索器、规则器、图算法负责可验证执行;
-
Agentic KG systems
- 把 KG construction / reasoning 看成多阶段 workflow;
- 通过角色分工、外部工具调用、审计机制降低 hallucination。
最后的 Takeaway
这篇论文最大的价值,不在于证明“GPT-4 很强”,而在于更精确地说明了:
- 它强在哪里:推理、问答、语义补全;
- 它弱在哪里:高精度结构化抽取,尤其是专业领域;
- 我们该怎么用它:不是孤立地替代传统 KG 模块,而是把它嵌入 AutoKG 这类可检索、可协作、可审计的系统中。
如果你正在做 Knowledge Graph 与 LLM 的结合,这篇论文给出的最务实建议其实是: 别再问“LLM 能不能全做”,而是该问“LLM 在 KG pipeline 里最应该做哪一层”。