
[MagicAgent] 突破智能体通用规划瓶颈:荣耀推 32B 模型,剑指 GPT-4o 级规划能力
MAGICAGENT TOWARDS GENERALIZED AGENT PLANNING
本文推出了 MagicAgent 系列通用智能体规划大模型,由荣耀(Honor)终端公司研发。该系列包含 32B 稠密模型和 30B-A3B MoE 模型,通过轻量化合成数据框架和两阶段强化学习(SFT + χPO RL),在任务拆解、工具调用及长程规划等 5 类任务中达到 SOTA,性能超越 GPT-4o 等闭源大模型。
TL;DR
传统的 LLM 智能体往往“偏科”,擅长工具调用的可能不擅长多约束排程。荣耀(Honor)近期发布的 MagicAgent 论文,通过一整套轻量化合成数据流水线和创新的 χPO 强化学习算法,在 32B 规模下实现了跨越 5 大规划维度的通用能力。实验显示,其在工具调用、逻辑编排等多个 Benchmark 上甚至超越了参数量大得多的闭源巨兽。
1. 痛点:为什么“全能规划”这么难?
在学术界和工业界,构建一个智能体规划模型通常面临两大泥潭:
- 数据沙漠:高质量的 Agent 轨迹(Trajectory)极难获取,依赖人工标注成本极高,依赖 Sandbox 环境模拟则存在扩展性瓶颈。
- 跷跷板效应 (The Seesaw Effect):多任务训练时,工具调用任务的梯度可能会干扰分层任务拆解任务的参数优化,导致模型顾此失彼。
MagicAgent 的核心直觉在于:与其被动收集数据,不如主动通过图结构“合成”逻辑;与其盲目训练,不如在 RL 阶段对“思考”和“动作”进行差异化正则。
2. 核心架构:从拓扑图到 ReAct 轨迹
MagicAgent 提出了一种轻量化、可扩展的合成数据框架。其核心逻辑不是随机生成,而是基于“原子计划”(Atomic Plan):
- 分层任务拆解:基于 5000+ API 构建工具依赖图 () 和参数共享图 (),利用图算子(串联、并行、掩码、变换)组合成复杂的交互场景。
- 长程工具执行:采用 ReAct(Reasoning + Acting)范式,通过一个虚拟的 API Simulator 模拟环境反馈,生成“ hindsight reasoning”(事后认知理由),确保思维链与动作的完美对齐。
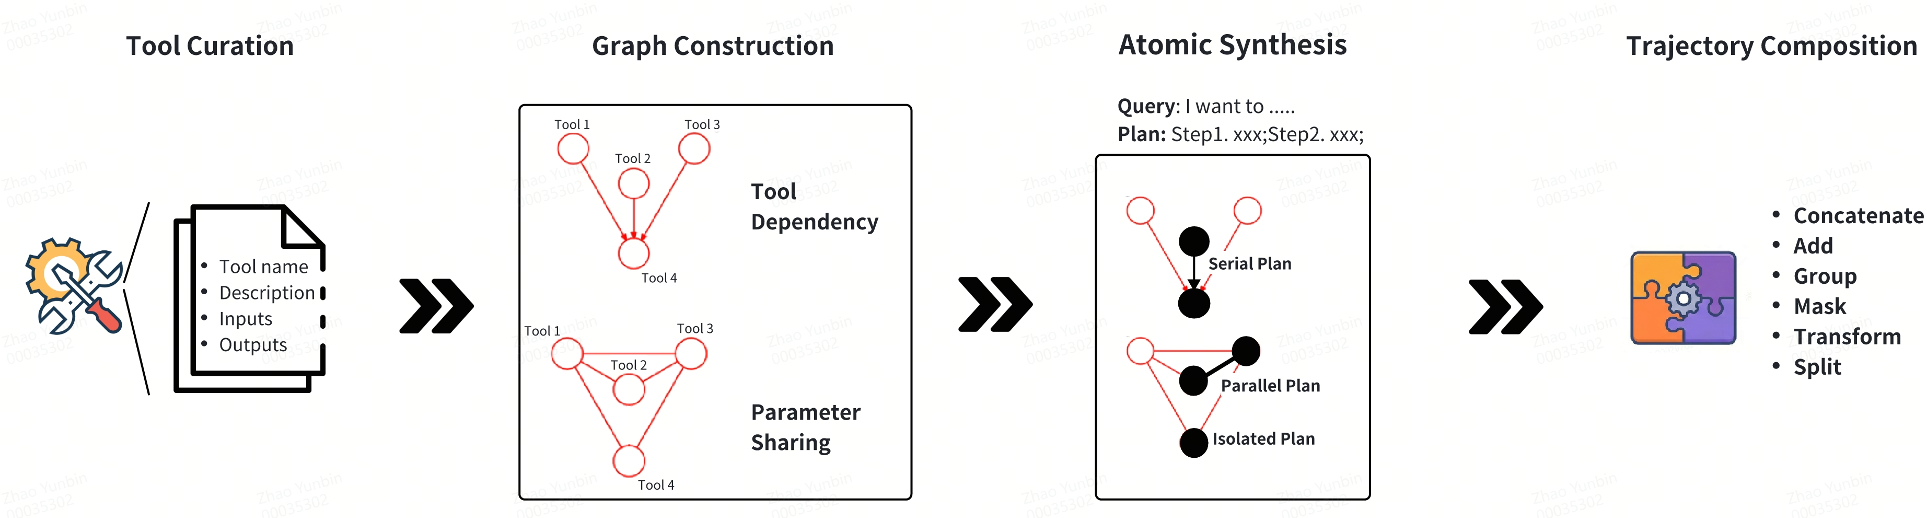 图 1:分层任务拆解的数据合成流水线,通过工具图构建原子计划。
3. 训练黑科技:χPO 强化学习算法
为了解决多任务干扰并提升环境泛化,作者提出了 χPO (Exploration-Exploitation Policy Optimization)。
3.1 思行分离的熵平滑(Think-Action Smoothing)
这是一个非常深刻的 Insight:在推理过程中,中间的“思考(Think)”部分应该保持较高的熵,以鼓励模型探索不同的推理路径;而最终的“动作(Action)”部分则应保持低熵,要求果断、准确。χPO 通过差异化的正则化系数实现了这一平衡。
3.2 信息瓶颈(Information Bottleneck)策略
为了防止模型产生“冗余废话”或无关的推理,χPO 强制模型压缩输入与推理内容之间的互信息,同时最大化推理内容与决策动作之间的互信息。这使得 MagicAgent 的 Reasoning Trace 非常精干且具备强导向性。
4. 实验战绩: sub-100B 级的“杀手”表现
MagicAgent 在 5 个主流 Benchmark 上的表现堪称惊艳:
- 工具调用 (BFCL-v3):32B 模型达到 86.9% 准确率,甚至超过了 Qwen3-Max 和 GPT-4o。
- 逻辑编排 (Worfbench):在复杂的图编排 F1 分数上,MagicAgent 领先 GPT-5.2 近 30 个百分点。
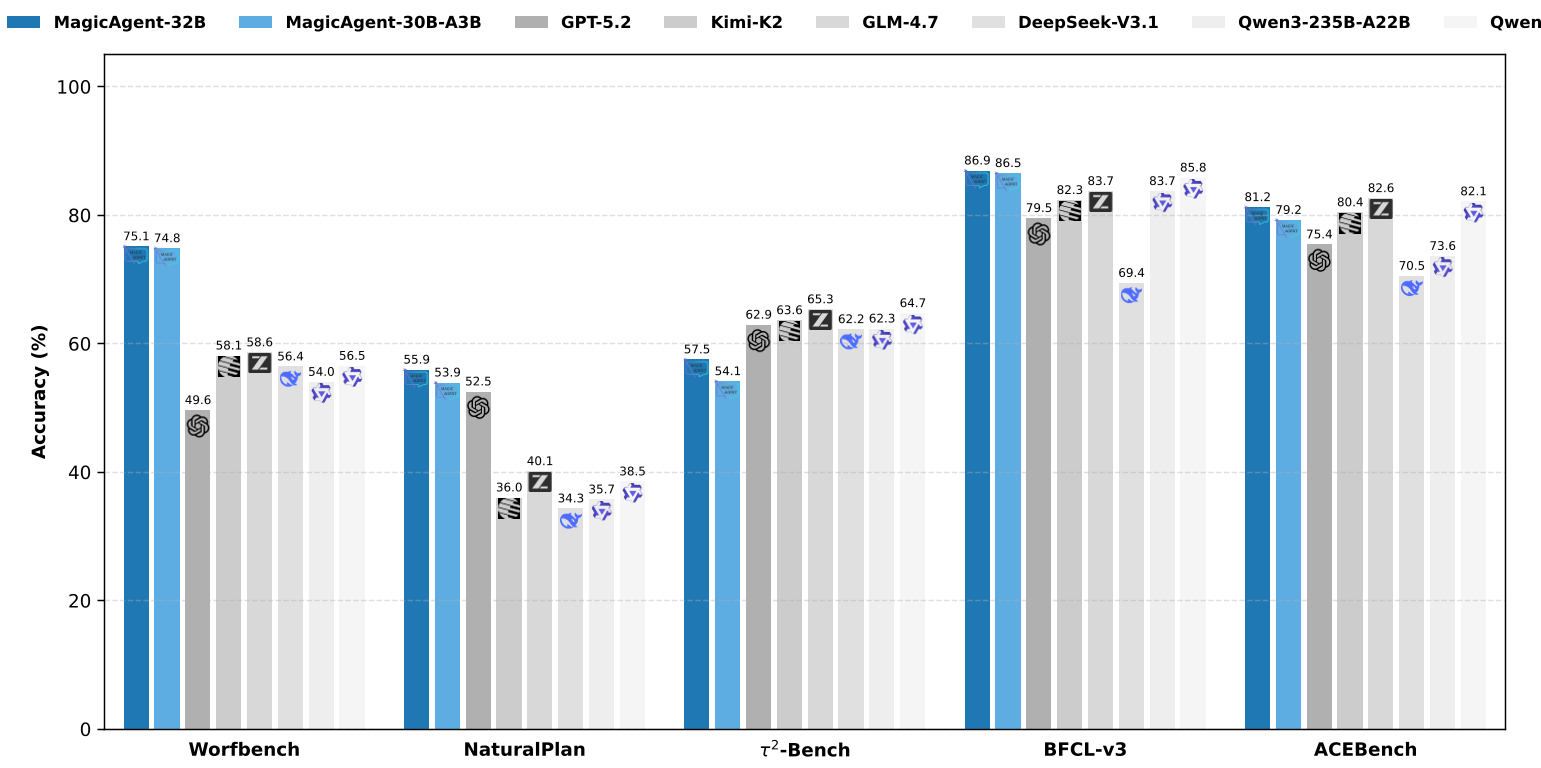 图 2:MagicAgent 在不同 Benchmark 上的性能分布,可见其在规划任务上的统治力。
此外,为了解决推理成本问题,作者还推出了 MagicAgent-30B-A3B (MoE 架构)。通过 Global-Batch Load Balancing 策略,解决了多任务训练中专家负载不均的问题。下表展示了其极致的推理效率:
| 指标 | MagicAgent-32B (Dense) | MagicAgent-30B-A3B (MoE) | 提升幅度 |
|---|---|---|---|
| 首字延迟 (TTFT) | 0.498s | 0.341s | -31.5% |
| 总延迟 (Latency) | 16.7s | 7.5s | -54.7% |
5. 总结与行业价值
MagicAgent 的出现标志着智能体训练从“数据量驱动”转向了“逻辑结构驱动”。
- 学术启示:证明了在 RLVR(基于可验证奖励的强化学习)中,对思维链和动作进行差异化熵控制能显著提升泛化力。
- 工程价值:通过 MoE 架构在移动端实现了媲美云端巨型模型的规划精度,为“手机 OS 智能体”提供了坚实的底层支撑。
局限性:虽然目前在文本逻辑规划上表现优异,但对于涉及实时多模态视觉反馈的任务(如复杂的手机游戏自动操作),其长程控制稳定性仍有待进一步验证。