
MagicAgent:突破 sub-100B 局限,打造泛化智能体规划的新基座
MAGICAGENT TOWARDS GENERALIZED AGENT PLANNING
本文推出了 MagicAgent 系列智能体规划基座模型(包含 32B 稠密版与 30B MoE 版),通过轻量化合成数据框架和两阶段强化学习,实现了泛化智能体规划。模型在 Worfbench (75.1%)、NaturalPlan (55.9%) 等多个权威榜单上刷新了 sub-100B 模型的 SOTA 纪录,甚至超越了 GPT-5.2 等闭源大模型。
TL;DR
在 LLM 向自主智能体(Autonomous Agents)演进的过程中,“规划(Planning)”是核心天花板。来自荣耀终端与复旦大学的研究团队发布了 MagicAgent。通过一套创新的数据合成逻辑和 χPO 强化学习算法,MagicAgent 在多项规划基准测试中击败了 GPT-5.2 和 DeepSeek-V3,证明了即使是 32B 规模的模型,只要“训得对、数据精”,也能在逻辑复杂度极高的领域实现越级反超。
1. 痛点:为什么“泛化规划”这么难?
目前智能体研究面临两大核心挑战:
- 数据极度匮乏:高质量、长程的工具调用轨迹(Trajectories)很难获取,依赖人工标注成本极高。
- “跷跷板效应” (Seesaw Effect):智能体任务是高度异构的。例如,任务分解要求模型具备强语义拆解能力,而工具调用要求模型严谨遵循 Schema。直接混合训练会导致性能在不同任务间由于梯度干扰而此消彼长。
MagicAgent 的直觉在于:通过轻量化的“原子计划”组合生成数据,并通过解耦“思考”与“动作”的强化学习来优化决策边界。
2. 核心贡献 1:可扩展的合成数据框架
作者没有采用昂贵的沙盒模拟,而是构建了基于图论的合成框架。
- 层次化任务分解:通过工具依赖图()和参数共享图()定义“原子计划”,再利用拼接(Concatenate)、掩码(Mask)、转换(Transform)等算子生成复杂的对话轨迹。
- 长程工具执行:专门设计了需要状态跟踪(State Tracking)的场景,确保模型在多轮对话中不丢掉任务目标。
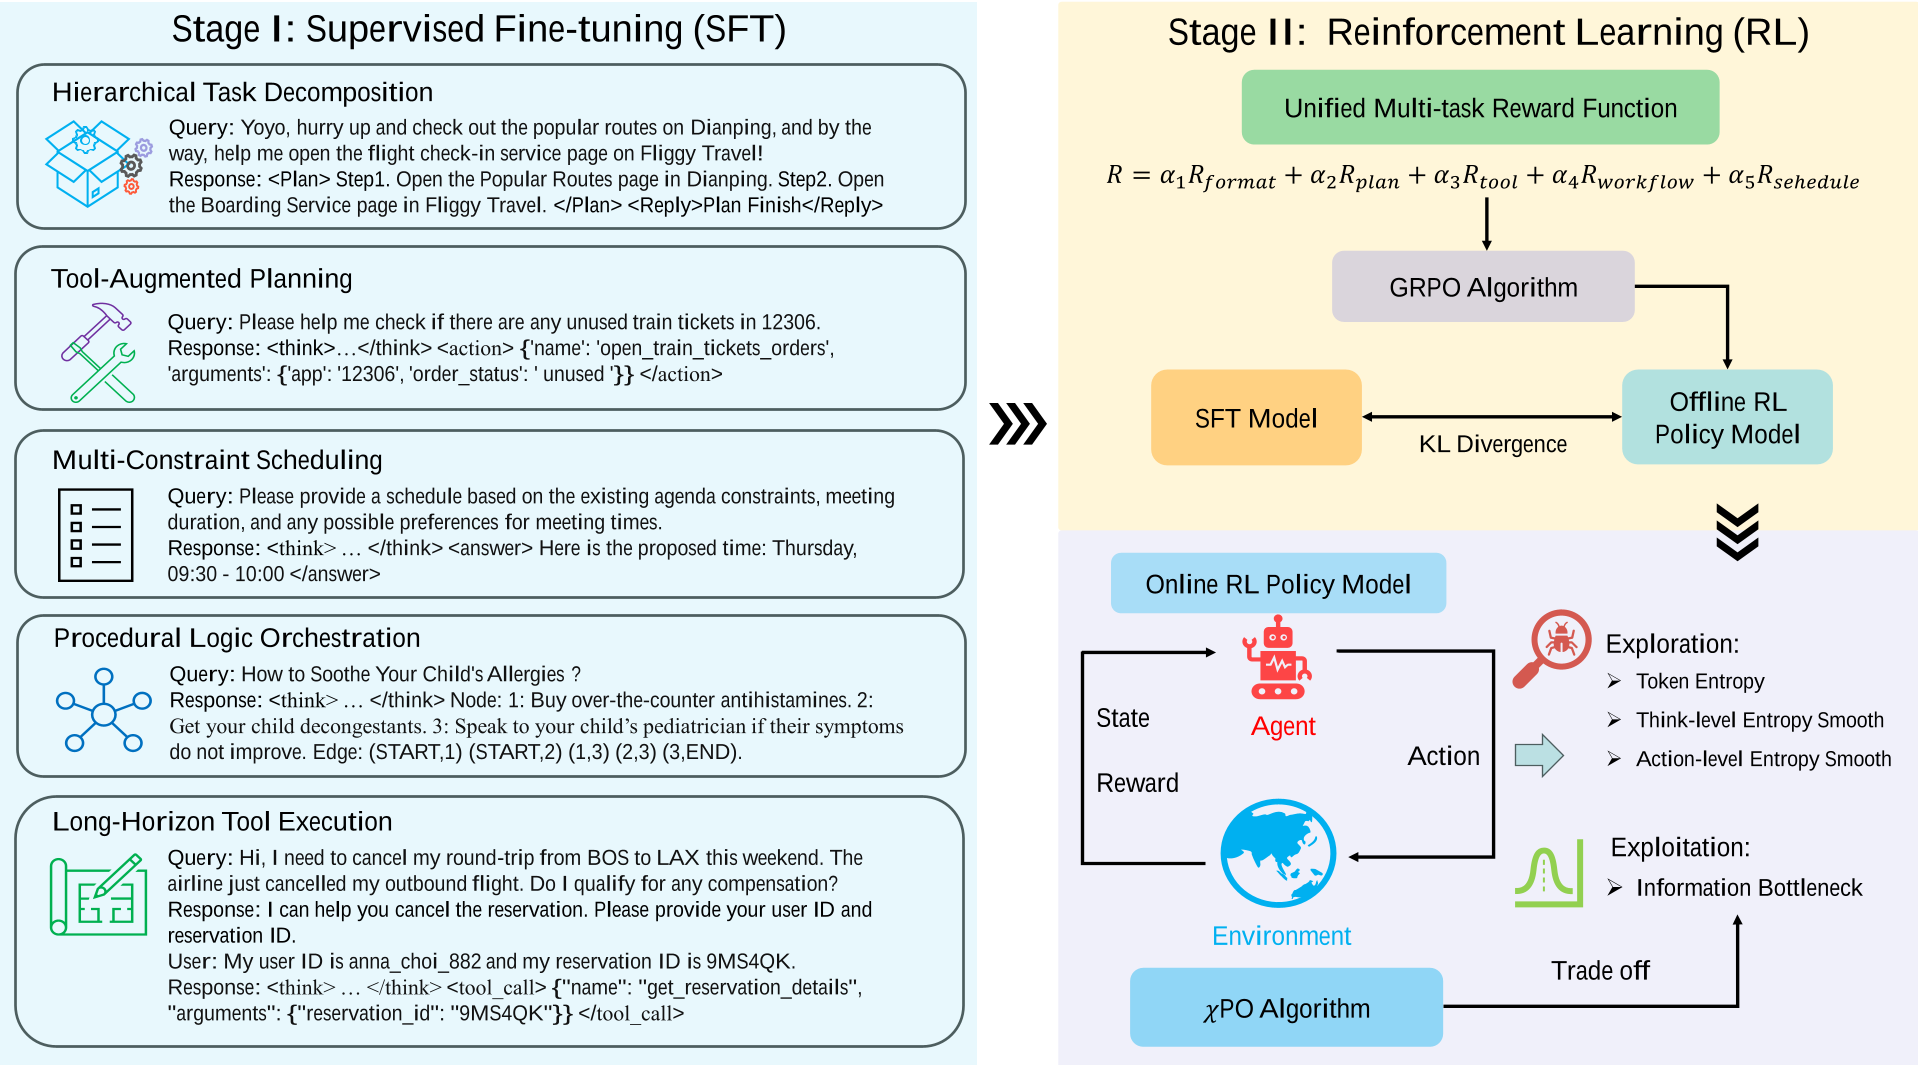 图 1:MagicAgent 两阶段训练流程:从 SFT 到多目标强化学习
3. 核心贡献 2:χPO 强化学习算法
为了解决在线环境中奖励稀疏(Sparse Reward)的问题,作者提出了 χPO (eXploration-eXploitation Policy Optimization)。
- 探索(Exploration):引入 Token 级熵正则,并区分 Think-level(思考阶段鼓励多样化推理)与 Action-level(动作阶段要求确定性)。实验发现,思考阶段的熵通常比动作阶段高一个数量级。
- 利用(Exploitation):引入信息瓶颈(Information Bottleneck),强制压缩无关推演,只保留对生成下一步 Action 有效的计算。
4. 实验战绩:sub-100B 的“屠龙”表现
MagicAgent 在 5 大核心数据集上展现了统治力:
| 任务类型 | 数据集 | MagicAgent-32B | GPT-5.2 | 优势 |
|---|---|---|---|---|
| 逻辑编排 | WorfBench (F1) | 80.3% | 60.1% | +20.2% |
| 约束调度 | NaturalPlan | 55.9% | 52.5%* | +3.4% |
| 工具调用 | BFCL-v3 | 86.9% | 79.5% | +7.4% |
| 交互环境 | ALFWorld (Succ.) | 81.4% | 63.5% | +17.9% |
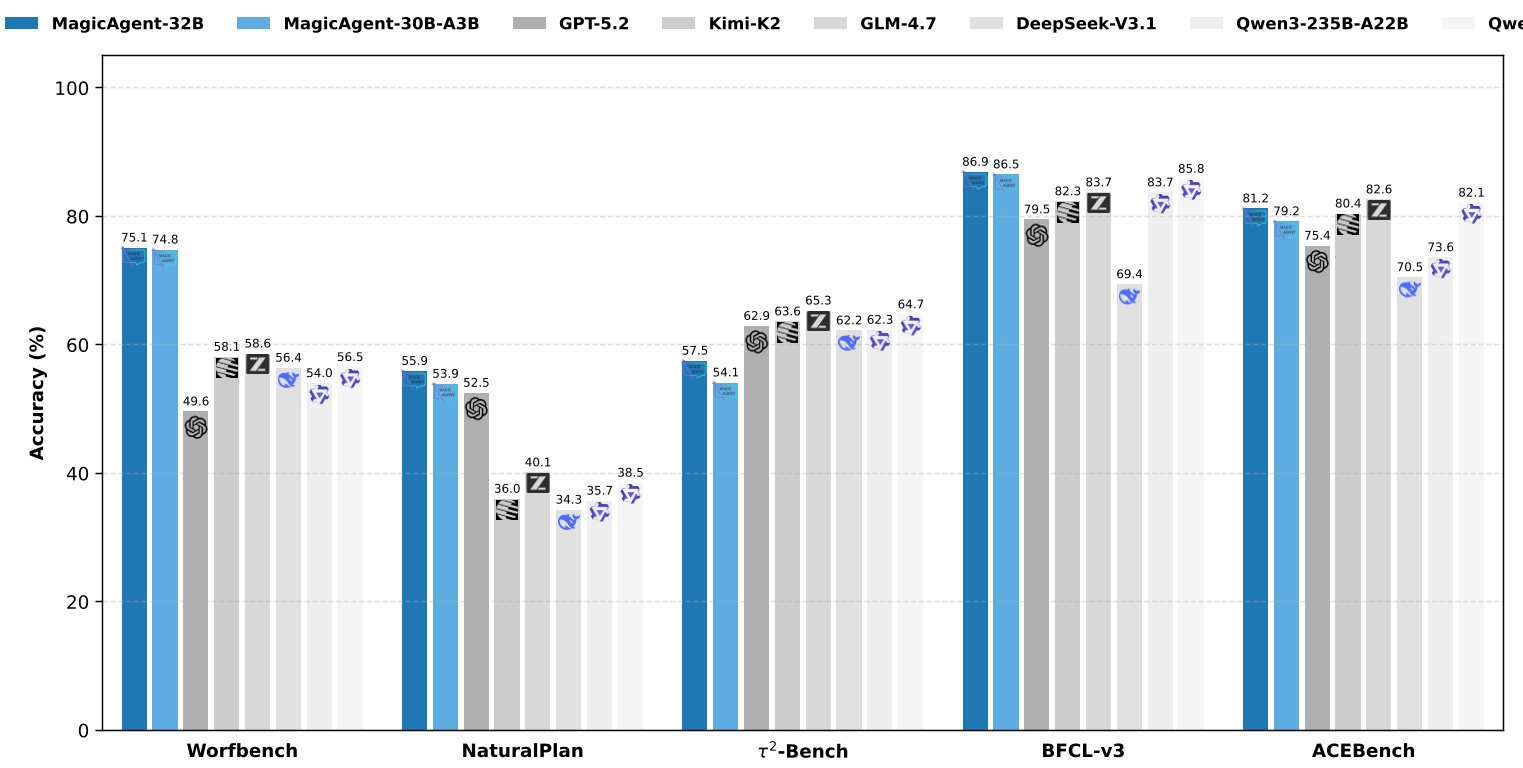 图 2:MagicAgent 在各项 Benchmark 上的性能大幅领先同类规模模型
MoE 架构的稳定性
针对 MoE 模型常见的专家负载不均(Load Imbalance)问题,MagicAgent 引入了全局负载均衡(Global-batch LBL)。通过在计算全局 batch 统计量而非 micro-batch 内容来实现负载均衡,这保证了专家在处理高度同质化的智能体指令时,依然能实现良好的专业化分工。
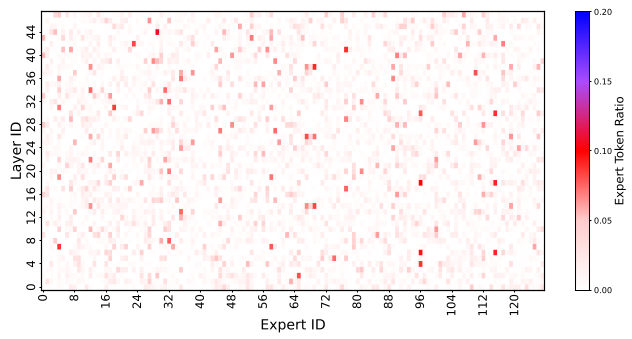 图 3:联合优化策略下的 MoE 专家分配热力图,显示了明显的任务专业化倾向
5. 结论与洞察
MagicAgent 的成功为我们揭示了一个事实:Agent 的能力不完全取决于参数规模。 通过以下三个维度,MagicAgent 实现了对巨型模型的反超:
- 数据原子化:将复杂规划任务拆解为可操作的原子逻辑。
- 强化学习的精细化操控:区分“思考熵”与“动作熵”,让推理更发散,让动作更精确。
- 计算效率:利用 MoE 架构,在端侧提供了媲美 GPT 系列的规划能力。
未来,MagicAgent 将进一步探索长上下文推理(Long-horizon Reasoning)与个性化信息的结合,有望在手机、PC 等端侧智能体中实现真正的自主决策。