
MambaIR:突破计算困局,开启图像恢复的线性全局建模时代
Mambair: A simple baseline for image restoration with state-space model
本文提出了 MambaIR,这是首个将选择性结构化状态空间模型(Mamba)引入图像恢复(Image Restoration)任务的基准模型。通过这一架构,MambaIR 在保持线性计算复杂度的同时实现了全局感受野,在图像超分辨率(SR)和去噪任务上达到了 SOTA 性能。
TL;DR
在图像恢复领域,我们长期在 CNN 的效率与 Transformer 的全局性能之间做折中。本文提出的 MambaIR 彻底打破了这一僵局,利用 State-Space Model (SSM) 的线性复杂度实现了真正的全局感受野,在超分与去噪任务上全面超越经典 SwinIR,且计算成本极具竞争力。
背景:感受野的“昂贵”代价
图像恢复(Image Restoration)的核心在于利用上下文信息重建像素。
- CNN:依靠算子并行,但有效感受野(Effective Receptive Field)极度局限。
- Transformer:拥有全局视野,但其 Self-Attention 的复杂度是 。为了实用,SwinIR 等模型不得不采用 Shifted Window,但这实际上是“牺牲全局性换取效率”的妥协。
Mamba 的出现改变了游戏规则,它通过选择性扫描机制,在 复杂度下实现了对长距离依赖的建模。但在图像这种 2D 非因果数据上,简单套用 1D Mamba 会遇到:
- 局部像素遗忘:展平后的 1D 序列让本该相邻的像素在空间上变得遥远。
- 通道冗余:为了记忆长序列,SSM 往往产生大量重复的特征表达。
核心创新:Residual State-Space Block (RSSB)
为了将 Mamba 调教成适合底层视觉的“利器”,作者设计了核心模块 RSSB。其架构流程为:Norm -> VSSM -> Local Conv -> Channel Attention。
1. 2D 扫描与全局感知
模型采用了四向选择性扫描(Selective Scan Module),从左上、右下、右上、左下四个顶点出发遍历图像。这确保了图像中的每一个像素都能从四个方向“吸收到”全图的上下文。
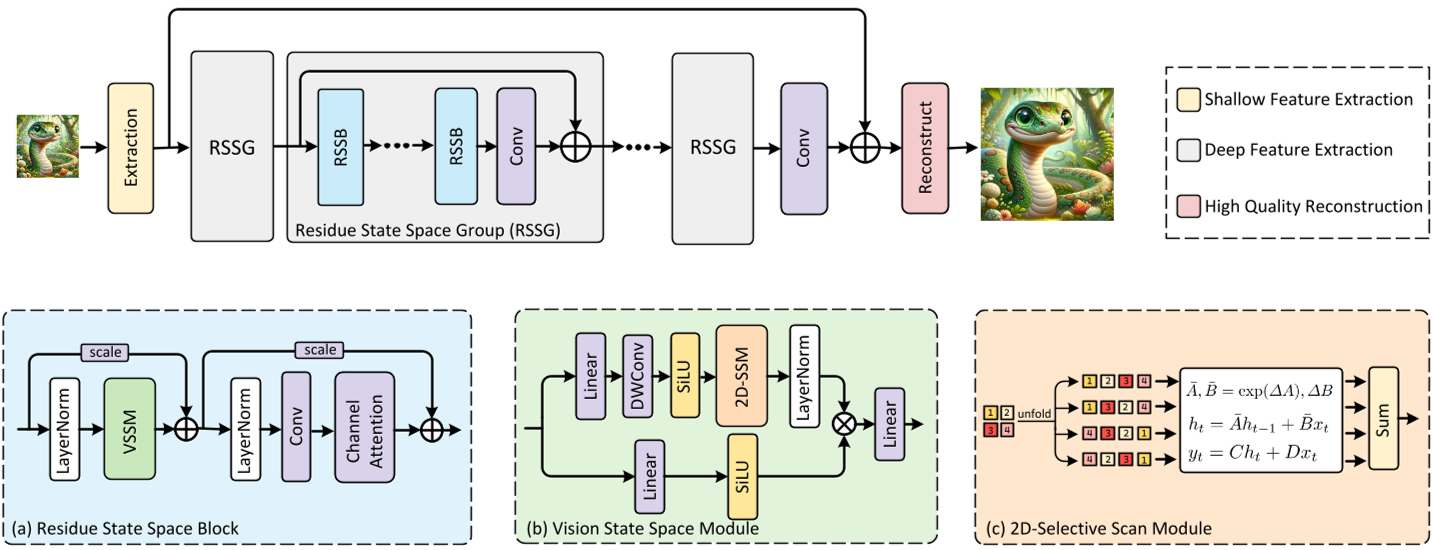 图 1:MambaIR 总体架构及 RSSB 内部细节
2. 局部增强与去冗余
- 局部卷积 (Local Conv):在 VSSM 之后串联一个瓶颈结构的深度卷积,强行召回因展平而丢失的邻域空间先验。
- 通道注意力 (CA):通过动态加权,过滤掉 SSM 中低效的冗余特征,强制模型学习更具判别力的表示。
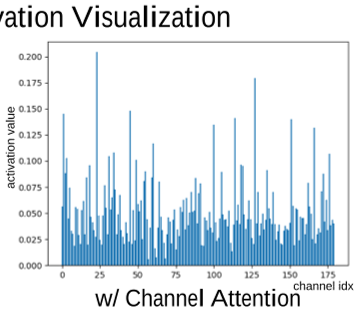 图 2:可视化证明,Channel Attention 有效缓解了 Mamba 输出中的通道失活问题。
实验战绩:全线刷新 SOTA
在经典超分辨率 (Classic SR) 榜单上,MambaIR 展示了统治级的表现:
- 精度提升:在 Manga109 数据集上,x2 倍率下比 SwinIR 高出 0.41dB。
- 视觉质量:相比 CNN 和基于窗口的 Transformer,MambaIR 恢复出的线条更锐利,没有人工伪影(Artifacts)。
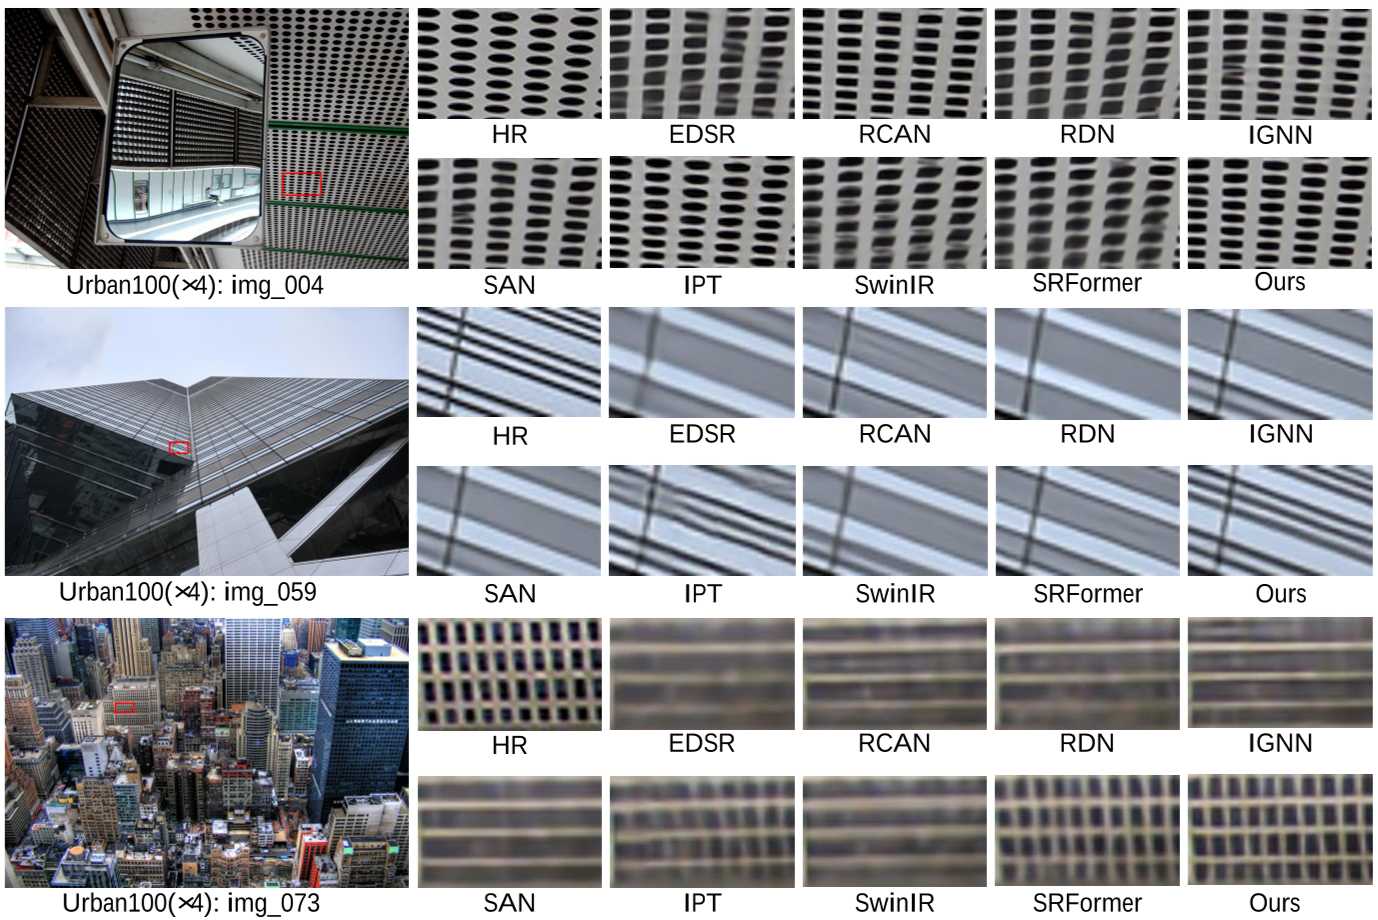 图 3:与 SwinIR 的视觉对比,MambaIR 在处理高密度纹理时更符合物理直觉。
深度洞察
MambaIR 的成功证明了一个深刻的直觉:底层视觉同样需要全局注意力,但不一定需要全量 Self-Attention。
论文中一个有趣的观察是,单纯将 MLP 替换进 MambaIR 反而会导致性能下降,这说明 SSM 模块与 Transformer 的 MLP/Attention 范式有着完全不同的归纳偏置(Inductive Bias)。Mamba 实际上更像是一个带有“选择性记忆”的循环神经网络,这使其在处理具有重复纹理特征的图像时(如 Urban100 中的建筑线条),展现出比 Transformer 强得多的建模能力。
总结与展望
MambaIR 不仅仅是一个新的 Baseline,它标志着图像恢复任务进入了“线性全局建模”时代。 局限性:尽管 MACs(计算量)较低,但目前 Mamba 在某些硬件上的推理算子优化尚不如成熟的卷积或自注意力层稳定,实际速度仍有优化空间。 展望:未来将 Mamba 扩展到多帧视频恢复或处理 4K/8K 超高清图像,将是该技术路线真正发挥其“线性优势”的战场。