
科学论文中的“AI 影子”:95 万篇论文揭示 LLM 如何重塑学术写作
Mapping the increasing use of LLMs in scientific papers
本文通过大规模统计分析量化了学术论文中 LLM 修改内容的普及程度。研究利用一种基于群体分布的 GPT 量化框架,分析了 2020 年至 2024 年间来自 arXiv、bioRxiv 和 Nature 系列期刊的近 95 万篇论文,揭示了 AI 在学术写作中呈指数级增长的趋势。
TL;DR
斯坦福大学的一项最新研究通过对 2020-2024 年间近 100 万篇学术论文的大规模扫描,发现 LLM(大语言模型)在科学写作中的渗透率正在显著攀升。其中,计算机科学 (Computer Science) 领域的论文摘要中,约有 17.5% 的句子显示出被 AI 大幅修改的痕迹。研究还指出,论文越短、作者发稿越勤奋、领域越“内卷”,AI 的参与度就越高。
背景定位:从“偶然发现”到“全景扫描”
自 ChatGPT 发布以来,学术界不断爆出论文中出现“As an AI language model”等令人尴尬的穿帮镜头。但这些只是冰山一角。本项工作在学术坐标系中属于首次针对科学出版生态的大规模实证研究。它不再纠结于“这篇论文是不是 AI 写的”,而是回答“这个学科有多少比例由于 AI 而改变”。
痛点深挖:为什么查重工具在大规模监测面前失效?
传统的 GPT 检测器(如 OpenAI 官方已下线的分类器)面临两大困境:
- 高误报率:对非英语母语作者极不友好。
- 鲁棒性差:简单的提示词工程或改写就能避开检测。
作者的核心直觉是:个体不可测,但群体有分布特征。人类写作和 AI 写作在特定词汇(如 realm, intricate, pivoting 等)的使用频率上存在显著差异,通过捕捉这些微小的统计偏离,可以精准推算语料库的“含 AI 量”。
方法论详解:群体级量化框架 (Distributional GPT Quantification)
研究者没有使用二分类器,而是构建了一个反事实训练集:
- Step 1:将 2020 年前的人类论文段落压缩成大纲(Skeleton)。
- Step 2:让 LLM 根据大纲重新“扩写”成段落。
- Step 3:对比两者的 Token 分布,构建概率模型 (人类)和 (AI)。
- Step 4:通过极大似然估计推算混合比例 。
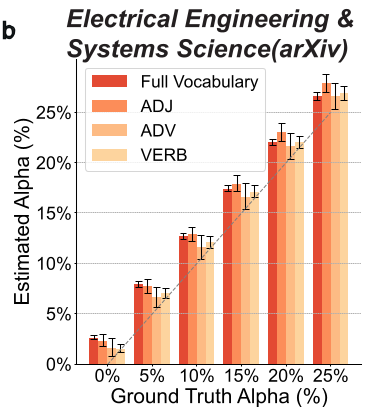 上图展示了模型在不同学科(计算机、电子工程、数学等)下的验证结果,误差均控制在 3.5% 以内,证明了跨时间、跨领域的稳健性。
实验与结果:哪里最“卷”,哪里 AI 最多
1. 学科差异显著
计算机科学(CS)一马当先,紧随其后的是电子工程。数学(Math)和 Nature 系列期刊的 AI 使用率最低,这可能与学科对逻辑严密性的极高要求或出版审核流程更严格有关。
2. “论文工厂”与“内卷”效应
研究发现了一个有趣的现象:
- 高产作者更爱 AI:每年发表 >3 篇预印本的作者,其论文中 AI 痕迹明显更高。
- 内卷领域同质化:在研究热点领域(即论文向量空间距离很近的领域),AI 的使用率更高。这说明 AI 可能正在加速知识的“平庸化”和同质化。
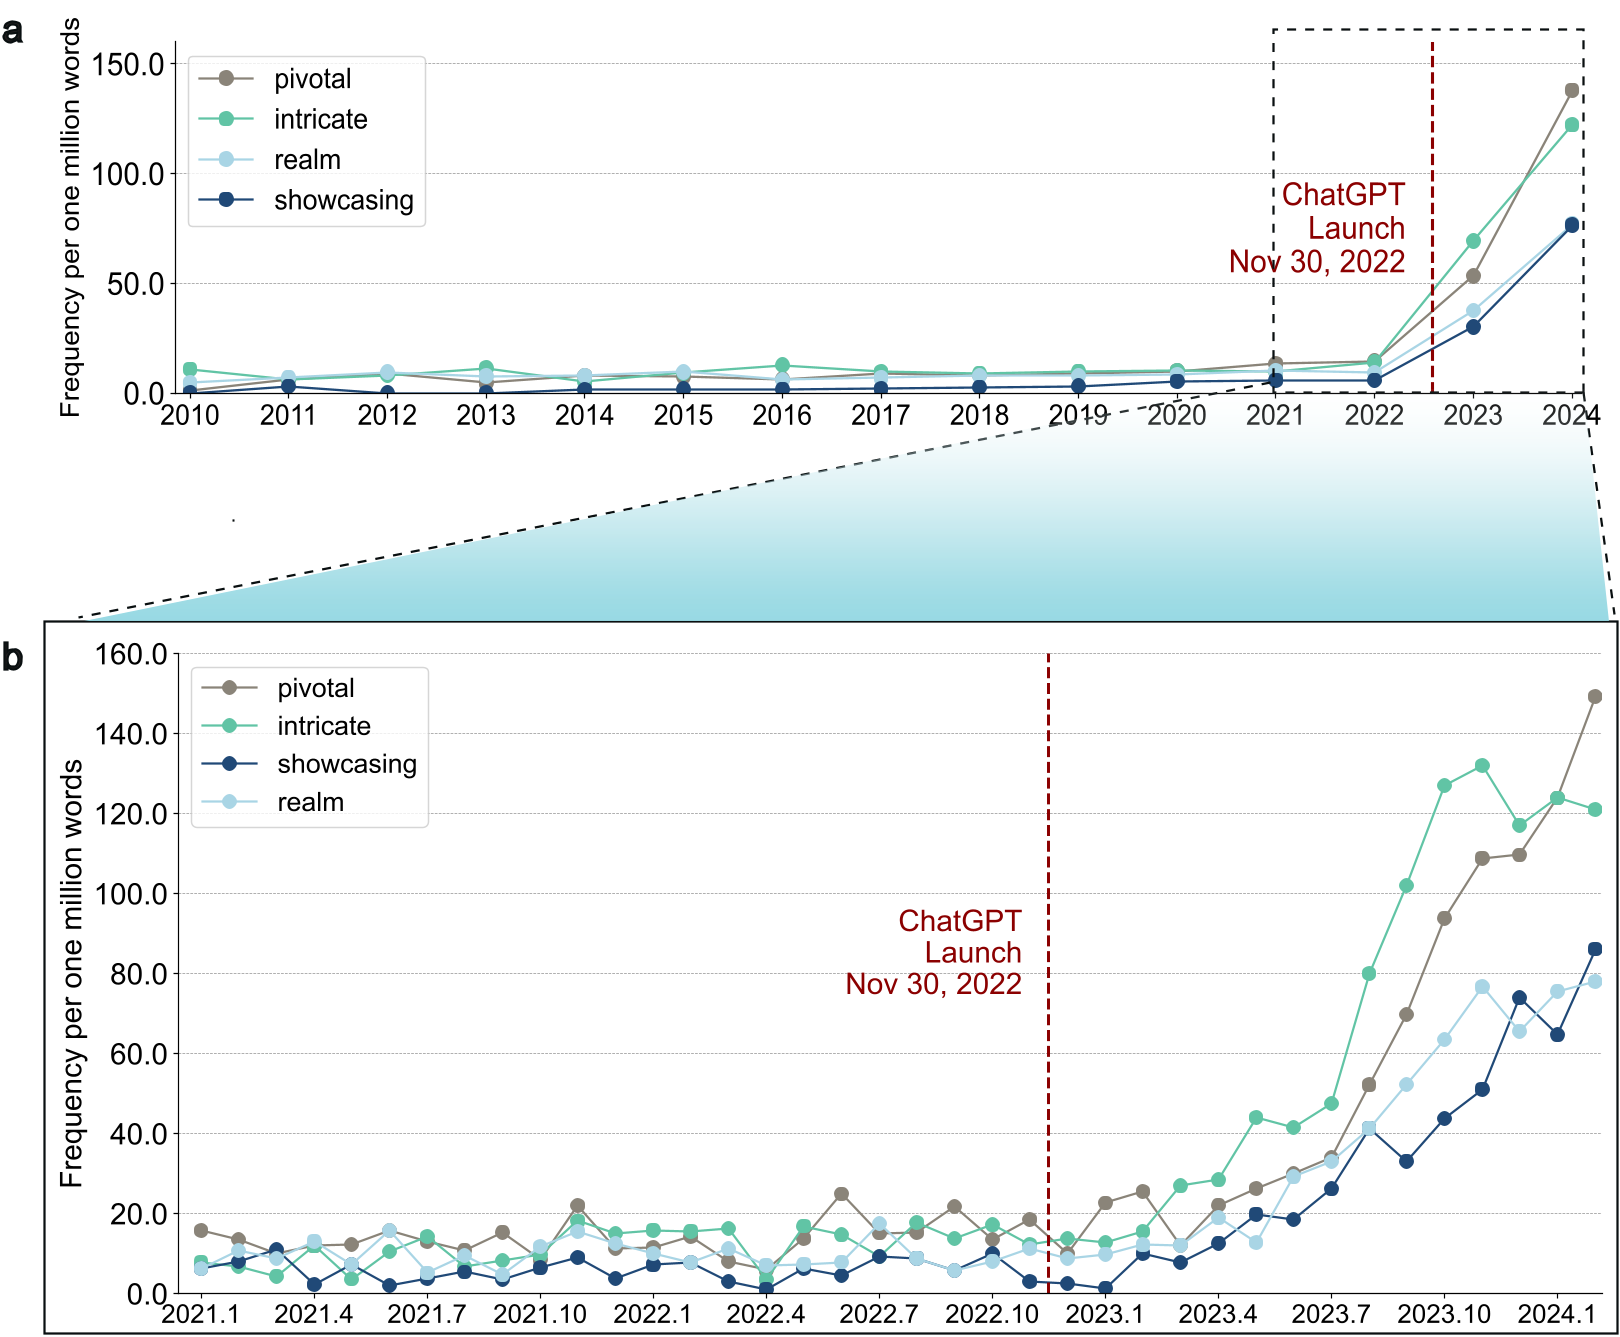 图中显示,诸如 "pivotal"、"intricate" 等词汇在 2023 年后在 CS 领域突然爆发式增长,成为了 AI 写作的标志性“黑话”。
深度洞察与总结
结论 (Takeaway): LLM 已经成为科学家的“外挂”。这在提高写作效率、消除语言障碍的同时,也引入了潜在的风险。如果学术界的输入数据(arXiv 等)被 AI 内容填满,未来的模型训练将陷入“递归污染”,导致科学思考的样态逐渐扁平。
局限性 (Limitations): 目前的方法主要捕捉的是“实质性修改”,对于细微的纠错(Proofreading)可能不够敏感。同时,研究关联性(Correlation)虽强,但尚不能锁定因果律——究竟是人变懒了,还是科学出版的竞争压力大到让人不得不依赖 AI?
未来展望: 这项研究不仅是给学术界打的一剂警醒针,也为未来“去污染”的数据清洗提供了工具。未来的学术评价体系,或许需要更多地关注那些“非 AI 化”的原创性思考。