
MathCritique:打破 LLM 自改进瓶颈,评论模型如何炼成数学高手?
MathCritique: Enhancing LLM Reasoning via Critique Models with Test-Time and Training-Time Supervision
本文提出了 MathCritique,一个旨在通过训练专门的 Critique Model(评论模型)来增强大语言模型数学推理能力的框架。核心贡献包括自动化数据采集流水线 AutoMathCritique 以及包含 7.6 万个步骤级反馈样本的数据集 MathCritique-76k,最终在 GSM8K 和 MATH 任务上实现了显著的性能提升。
TL;DR
传统的 LLM 提升数学能力主要靠“多刷题”(Self-improvement),但模型往往容易在简单题上原地踏步,难题却始终攻不破。本文提出的 MathCritique 通过训练一个专门的“评论家”(Critique Model),为“执行者”(Actor Model)提供精细到步骤的纠错反馈。这不仅让模型在测试时能通过“思考和修正”拿高分,更在训练阶段通过“评论在环”机制,有效解决了难题采样不足的痛点,显著提升了模型的推理上限。
1. 痛点:为什么 LLM 的“闭门造车”会遇到天花板?
在强化学习和自改进领域,LLM 通常通过生成多个回答并保留正确回答来训练自己。然而,这种模式存在两个核心局限:
- 自我修正无力(Self-correction Failure):研究表明,如果没有外部强信号,模型很难发现并修正自己的逻辑错误,往往只是在低水平重复。
- 尾部收缩(Tail Narrowing):模型在迭代中会越来越倾向于生成熟悉的简单题解法,而对于那些真正需要攻克的难题(长尾分布),由于初始成功率低,导致采样不到正确样本,训练陷入局部最优。
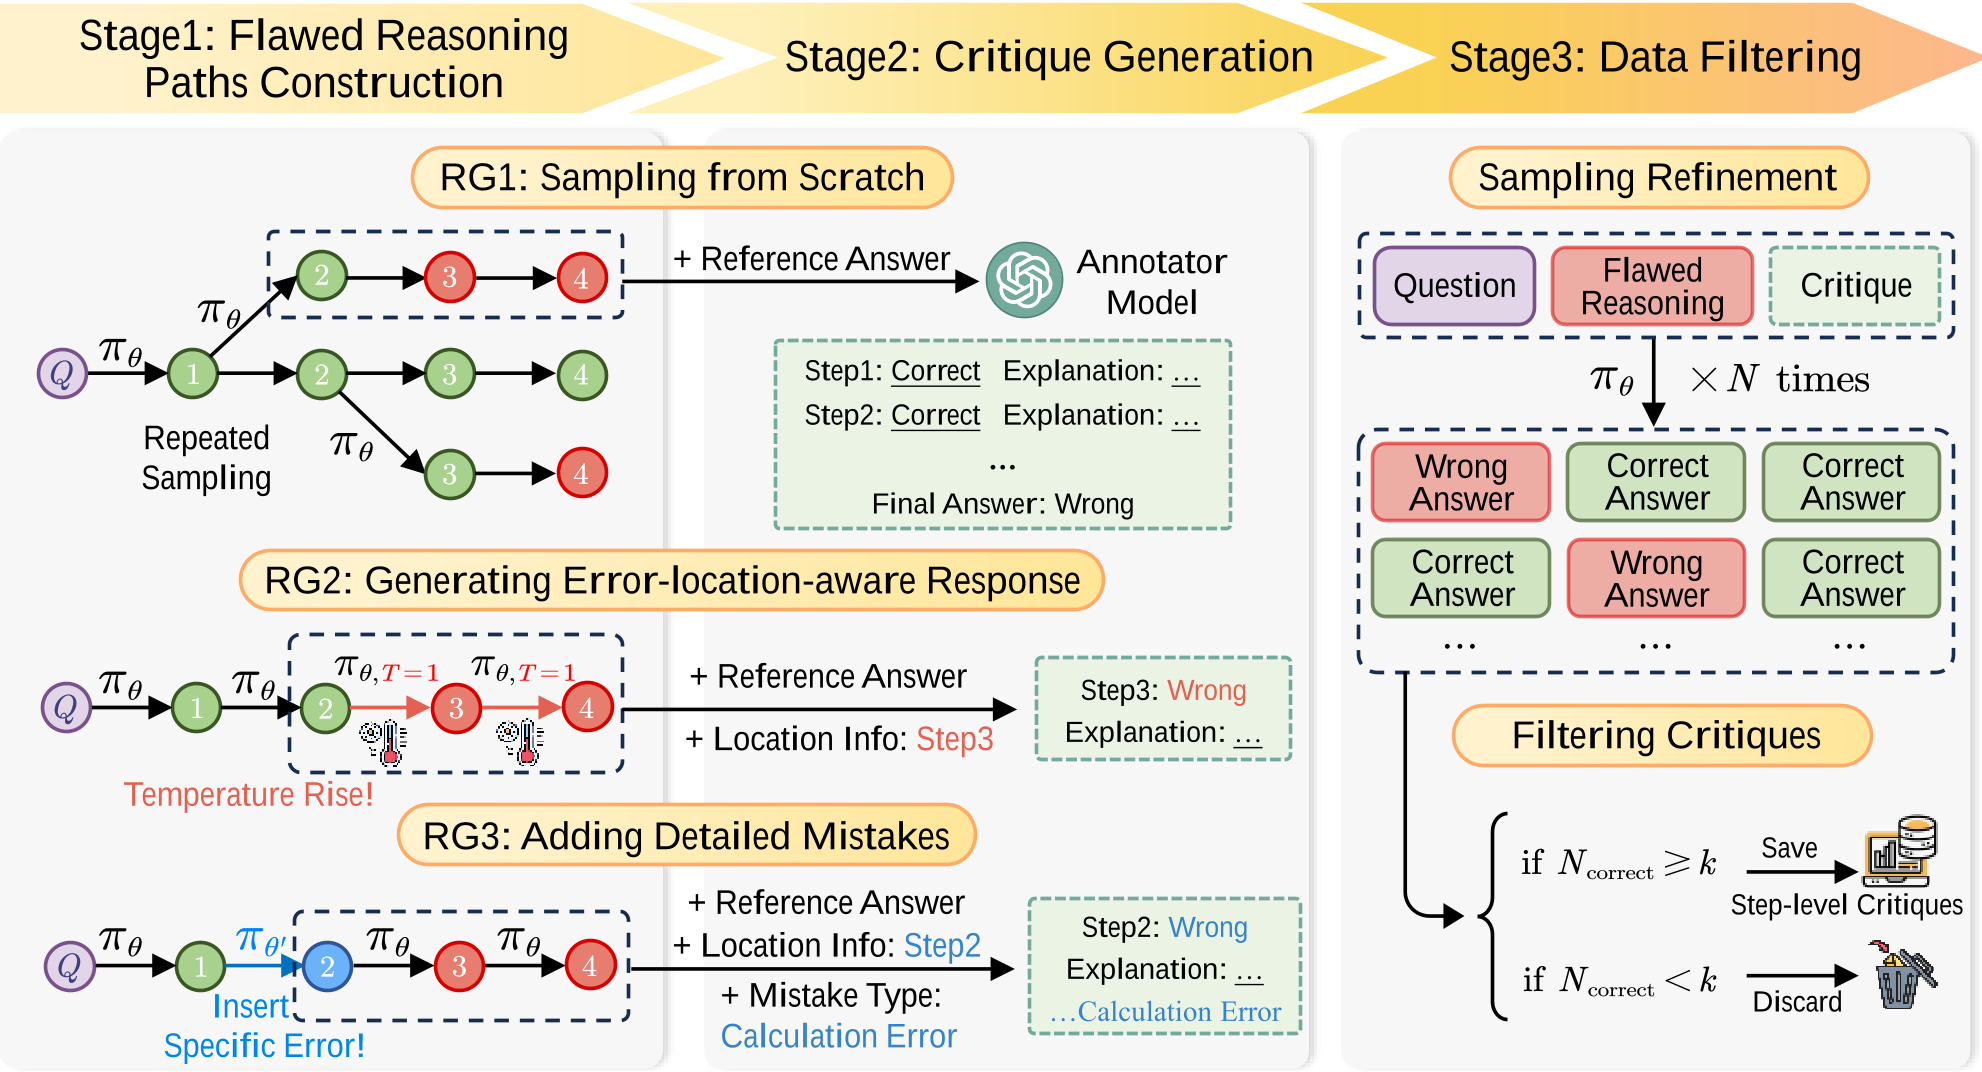 图 1:AutoMathCritique 数据采集框架系统流程
2. 核心武器:AutoMathCritique 与步骤级反馈
为了训练一个优秀的“评论家”,作者开发了 AutoMathCritique 框架。其精妙之处在于它不是被动等待模型犯错,而是“主动制造错误”:
- 精准注入错误:通过 RG2(指定位置中断)和 RG3(注入特定类型错误,如四则运算错误或逻辑跳跃)生成多样化的 Flawed Paths。
- 高质量标注:利用 GPT-4o 作为 Annotator,对比正确答案,精准指出“第一处错误”发生在第几步,并给出自然语言解释。
- 蒙特卡洛过滤:利用 Actor 模型尝试根据评论进行修正,只有那些能确实引导模型改对的评论才会被保留,确保了数据的 Constructive(建设性)。
最终形成的 MathCritique-76k 数据集,填补了开源社区缺乏高质量数学评论数据的空白。
3. 测试时监督:让推理算力(Test-time Compute)真正发挥作用
模型在测试时,如果只是简单的重复采样(Majority Voting),收益会迅速摊平。MathCritique 引入评论模型后,情况发生了变化:
- 辨别与引导:70B 的评论模型在 GSM8K 上的辨别准确率(92.3%)已经超越了 GPT-4 Turbo。
- 难题加持:如图 3 所示,评论模型对简单题的提升微乎其微,但对于 Difficulty Level 4-5 的难题,性能提升呈指数级增长。这说明“评论”是应对复杂逻辑的利器。
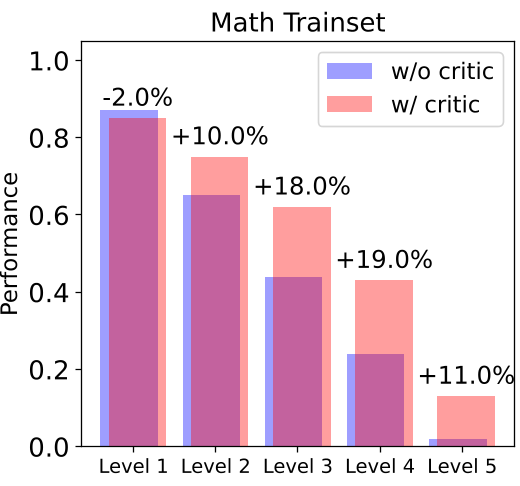 图 3:评论模型在不同难度题目下的表现增益(可以看到难题增益更明显)
4. 训练时监督:评论在环自改进
这是本文最具前瞻性的部分。作者将评论模型嵌入到 Actor 的自训练循环中。
- 扩大解法空间:当 Actor 在探索阶段遇到难题改错时,评论模型会拉它一把,使原本会丢弃的错误尝试变成正确的训练样本。
- 难度感知算力分配:针对难题分配更多的采样和评论回传次数。
实验结果(表 3)显示,这种“训练时评论”具有蒸馏效应:Actor 在训练中吸收了评论家的逻辑,即使在测试时不挂载评论模型,其原生准确率也大幅超过了传统的自改进方法(LMSI)。
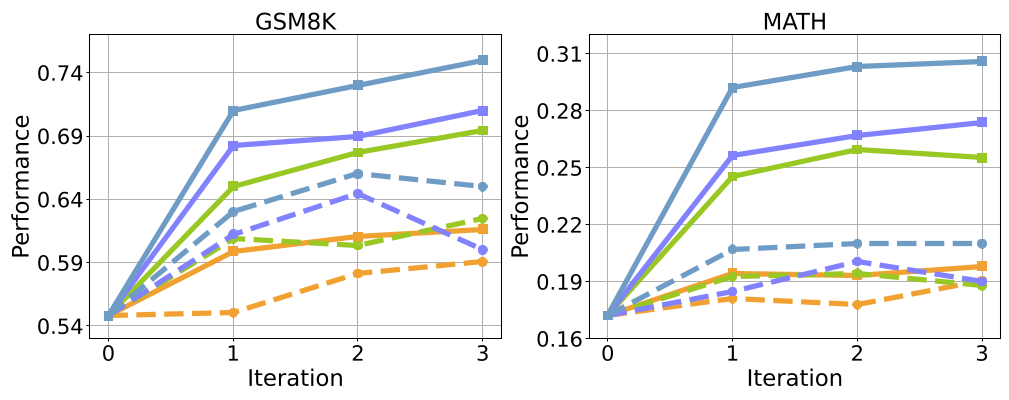 图 5/6:Critique-in-the-loop 有效缓解了尾部收缩问题,显著提升了难题样本的覆盖率
5. 深度洞察:平行还是串行?
博客特别关注了论文中对 Test-time Compute 策略的讨论。作者对比了“平行采样多个回复”和“串行迭代修正”。结论很有启发性:
- 在低算力预算下,平行采样(Parallel MV) 效果更好,因为增加了回答的多样性(Diversity)。
- 在高算力预算下,串行修正(Sequential) 的扩展性更强,因为它能深入挖掘单条逻辑路径的正确性。
6. 总结与反思
MathCritique 的成功揭示了一个深刻的道理:LLM 的推理上限不只取决于模型参数量,更取决于高质量的反馈循环。
局限性:尽管模型在数学任务上表现出色,但在处理需要极长链条推理(如奥数竞赛级题目)时,评论模型本身的判断准确率仍有待进一步提升,否则错误的反馈会误导 Actor 进入死胡同。未来的方向或许是将此类自然语言反馈与形式化验证(Formal Verification)相结合。
Takeaway for Practitioners: 如果你正在优化垂直领域的推理任务,不要只盯着 SFT 数据量,尝试构建一个专门的 Critique Model,并将其引入训练探索阶段,这可能是解决“模型遇到难题没思路”的最佳方案。