
深度解析:多模态图表检索——文本、表格与图像的博弈
Multimodal Chart Retrieval: A Comparison of Text, Table and Image Based Approaches
本文研究了多模态图表检索(Multimodal Chart Retrieval)任务,即通过文本查询检索图像形式的图表。作者提出了 TAB-GTR 模型通过增强表格结构嵌入实现 SOTA,并对比了基于 OCR、图表反渲染(DEPLOT)和原生视觉语言模型(PALI-3)的四种检索路径,其中组合方案(PALI-3 + DEPLOT)表现最佳。
TL;DR
来自 Google DeepMind 的研究团队首次系统性探讨了如何通过文本查询在海量图像中精准检索“图表”。研究发现:将图表转化为底层表格数据(De-rendering)再进行检索,其效率和精度在特定场景下甚至超过了参数量大十倍的视觉语言模型(VLM)。
核心速览
- 定位:多模态检索领域中针对“ visually grounded images”(如科学图表、财务报表)的开拓性研究。
- 核心贡献:
- 提出了 TAB-GTR:一种增强了表格结构感知的 SOTA 检索器。
- 建立了 5 个图表检索基准数据集。
- 揭示了“图表转表格”路径与“直搜图像”路径的优劣边界。
痛点深挖:为什么 OCR 和 传统 VLM 还不够好?
在科学和技术领域,图表通常是结构化数据的视觉表现。传统的做法有两种:
- OCR 路径:把图表里的字抠出来。缺点是丢失了数据之间的行列逻辑(如:不知道这个数字对应的是哪个年份)。
- VLM 路径(如 PALI-3):直接看图。缺点是图表中的微小数值变化和坐标关系对通用视觉编码器来说太过精细,且模型极其臃肿(3B+ 参数)。
方法论:TAB-GTR 与 四种检索路径
作者的核心逻辑是:图表的本质是表格。
1. TAB-GTR 的架构
为了处理表格,研究员在 T5 Encoder 基础上增加了 text_col 和 text_row 两个离散特征。这意味着模型不仅知道“这个词是什么”,还知道“它在表格的第几行第几列”。
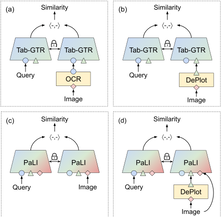 图 1:四种图表检索路径示意图
2. 四种路径对比
- (a) OCR -> Text Retrieval: 最原始的文本堆砌。
- (b) DEPLOT -> Table Retrieval: 先用 DEPLOT 模型将图还原成 Markdown 表格,再用 TAB-GTR 搜。
- (c) VLM Retrieval: 纯视觉检索(PALI-3 编码器)。
- (d) DEPLOT + PALI-3: 图像和还原后的表格我全都要。
实验与结果:并没有“一劳永逸”的赢家
关键发现 1:TAB-GTR 是目前最强的表格检索器
在 NQ-TABLES 榜单上,TAB-GTR 以极小的参数增量(+197K)实现了显著超越基础 GTR 的表现(R@1 +4.4%)。
关键发现 2:DEPLOT 的鲁棒性挑战
实验数据显示:
- 在 CHARTQA 等标准图表上,(b) 路径(DEPLOT)大获全胜。它不仅快,而且准确,证明了结构化信息的重要性。
- 在 SCICAP(复杂科学论文图表)上,(c) 路径(原生 VLM)反超。原因是 DEPLOT 难以处理多子图、非标准坐标轴或包含“测地线三角形”等高度语义化的视觉元素。
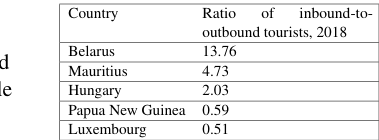 表:不同模型在各数据集上的 MAP 和 F1 表现对比
深度洞察:什么时候该选什么模型?
- 如果是标准商业/统计图表:DEPLOT + TAB-GTR 是首选。它是典型的“小而美”方案,300M 参数即可提供极高召回。
- 如果是复杂科研绘图/多模态混合图:必须使用 PALI-3 级别的 VLM。作者发现,VLM 能够识别出“S形曲线”、“MSE 图”等 DEPLOT 无法翻译成数值的高层语义。
- 如果追求极致效果:路径 (d) 这种“图表反渲染 + 视觉特征”的融合方案在多任务训练下表现出最强的跨域抗干扰能力。
局限性与展望
作者诚实地指出,当前的 DEPLOT 模型在处理“文字密集型”图表(如 Pew Research 的复杂排版)时会丢失标题信息,导致匹配失败。未来的研究重点应放在能处理更多样化、更复杂布局的“多尺度反渲染器”上,使得图表检索能够真正处理像《Nature》论文那样复杂的科学插图。
总结 (Takeaway):本工作证明了将视觉信息解构为结构化文本(De-rendering)是解决特定领域多模态任务的高效范式。对于开发者而言,建立一个针对图表结构的索引,比盲目堆砌视觉参数更具性价比。