
MusicalSCORE:音频大模型离“听懂”音乐还有多远?
MusicalSCORE Benchmark: Musical Structural and Semantic Comprehension and Reasoning Benchmark
本文推出了 MusicalSCORE,一个旨在评估音频语言模型(Audio LMs)在音乐结构、语义理解及推理能力方面的深度评估基准。该基准包含 12 个任务,涵盖 2,658 个问答对,横跨结构分割、歌词转写、音乐学分析及艺人协作四个维度,在 LMs 的长文本音乐理解上提出了严峻挑战。
TL;DR
尽管大语言模型在文本领域已趋于成熟,但在处理复杂的音乐音频时,它们似乎还是个“音痴”。最近 ACL 投稿的一篇论文提出了 MusicalSCORE 评测基准,通过 12 个极具挑战性的任务(包括结构分割、多艺人协作分析等)对 14 款顶尖音频模型进行了“大考”。结果令人大跌眼镜:即使最强的 Gemini 2.5 Pro 也仅拿到了 26.54% 的分数。
背景定位
自 2023 年以来,Audio LMs(如 Audio Flamingo, Gemini)在语音识别和环境音理解上突飞猛进。然而,音乐具有极强的层级结构(重复的副歌、过渡的桥段)和多维度属性(音色、律动)。此前的基准测试大多只让模型写简单的描述(Music Captioning),而 MusicalSCORE 则是首个要求模型进行深层音乐学推理和长程结构分析的硬核基准。
痛点深挖:为何模型会变成“音痴”?
作者指出,目前的 Audio LMs 存在三大技术痛点:
- 时序定位无能:模型很难精准说出“第二个副歌(Chorus)从第几秒开始”。
- 缺乏长程视野:在长达 10 分钟的音轨中,模型容易忘记前面的结构,导致对后续段落的判定混乱。
- 过度依赖语言先验:模型最擅长歌词转写,因为可以靠语言预测(ASR 能力),但在纯音乐学分析(如判断吉他失真度)上表现拙劣。
方法论详解:四大维度的魔鬼考题
MusicalSCORE 构建了四大维度的评估矩阵,直接击中现有模型的弱点:
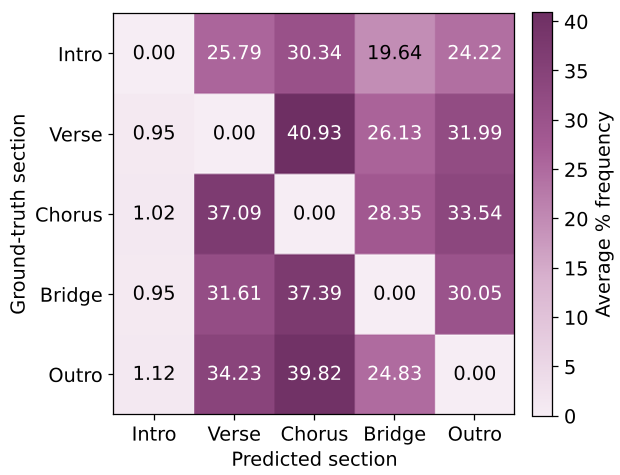
1. 结构化分割 (Structural Segmentation)
不仅仅是分割,还要为每一段打上 Verse, Chorus, Bridge 等标签。
2. 音乐基因学 (Musicological Analysis)
利用 Music Genome Project 的专业标注,让模型在 58 个维度(节奏、配器、情感)上进行识别和排序。这考察的是模型对抽象音色特征的捕获能力。
3. 艺人协作分析 (Artist Collaboration)
这是最难的部分。模型需要分辨:这首歌有几个歌手?谁是主唱?谁是客串(Featured)?谁在说唱,谁在唱歌?
实验与结果:全线折戟的“学霸”们
研究者测试了包括 Gemini, Qwen3-Omni, Step-Audio-R1 在内的 14 款模型,得出了几个令人惊讶的结论:
-
性能排行:启用“思维链/思考模式”的模型普遍表现更好。Gemini-2.5 Pro 和 Qwen3-Omni 领先,但依然处于“低分段”。
-
源分离的悖论:直觉上,把人声提取出来(Vocal Stem)应该有助于理解。但实验证明,混合音频反而效果更好。这说明模型在推理时会潜意识地参考伴奏中的信息。
-
“早读”效应:模型对歌曲开头的 Intro 和第一个 Verse 的定位和理解更准,随着歌曲推进到 Outro(结尾),错误率显著飙升。
深度洞察:未来的进阶之路
MusicalSCORE 的出现为音频大模型指明了几个改进方向:
- 突破 ASR 思维:音频模型不能只是“会听话”,更要学会“听音”。目前的模型太依赖语言预测,而忽略了声学属性的物理本质。
- 时间轴感知(Time-awareness):模型急需一种更精准的内部计时器,用于处理音乐这种高度依赖时序的艺术形式。
- 层级化注意力机制:既然音乐是按段落组织的,模型的 Context Window 也应该具备对应的层级理解能力。
总结 (Takeaway): MusicalSCORE 证明了当前的 AI 系统在音乐理解上依然处于“能听见但听不懂”的阶段。真正的音乐 AGI 不仅要能生成动听的旋律,更要能像专业制作人或音乐学家那样,洞察音轨背后的结构与灵魂。