
NSA:深挖稀疏注意力的原生训练潜力,让长文本建模起飞
Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
本文提出了 NSA (Native Sparse Attention),这是一种硬件对齐且原生可训练的稀疏注意力机制。通过整合分层 token 压缩、分层块选择和滑动窗口技术,NSA 在 DeepSeek 推出的 27B 模型上实现了长文本建模,显著提升了推理和训练速度。
TL;DR
DeepSeek 团队开源了 NSA (Native Sparse Attention),这不仅是一个提升推理速度的 Trick,更是一套原生可训练的稀疏注意力架构。它通过硬件对齐的 Blockwise 选择和分层压缩策略,在保持甚至超越满注意力(Full Attention)性能的同时,将 64k 文本的解码速度提升了 11.6 倍,训练效率也得到了数倍的飞跃。
背景:稀疏注意力的“理想”与“现实”
在处理超长文本(如整个代码库或数本书籍)时,Transformer 的标准注意力机制面临着 计算复杂度的天花板。虽然学术界提出了各种稀疏化方案(如 H2O, Quest, MInference 等),但它们普遍面临两个尴尬境地:
- 推理快、训练慢:大多数方案是“后验”的,即在预训练完成后强行修剪 KV Cache,由于训练时没见过这种稀疏模式,导致模型精度受损且训练由于无法利用稀疏性而依然昂贵。
- 硬件不友好:很多基于聚类或哈希的方法虽然理论复杂度低,但在 GPU 上由于频繁的随机访存,实际跑起来甚至不如暴力计算快。
核心架构:NSA 的三位一体
NSA 的精髓在于它不押注于单一的稀疏策略,而是通过一个**三路并行(Three-path)**的架构来兼顾效率与精度:
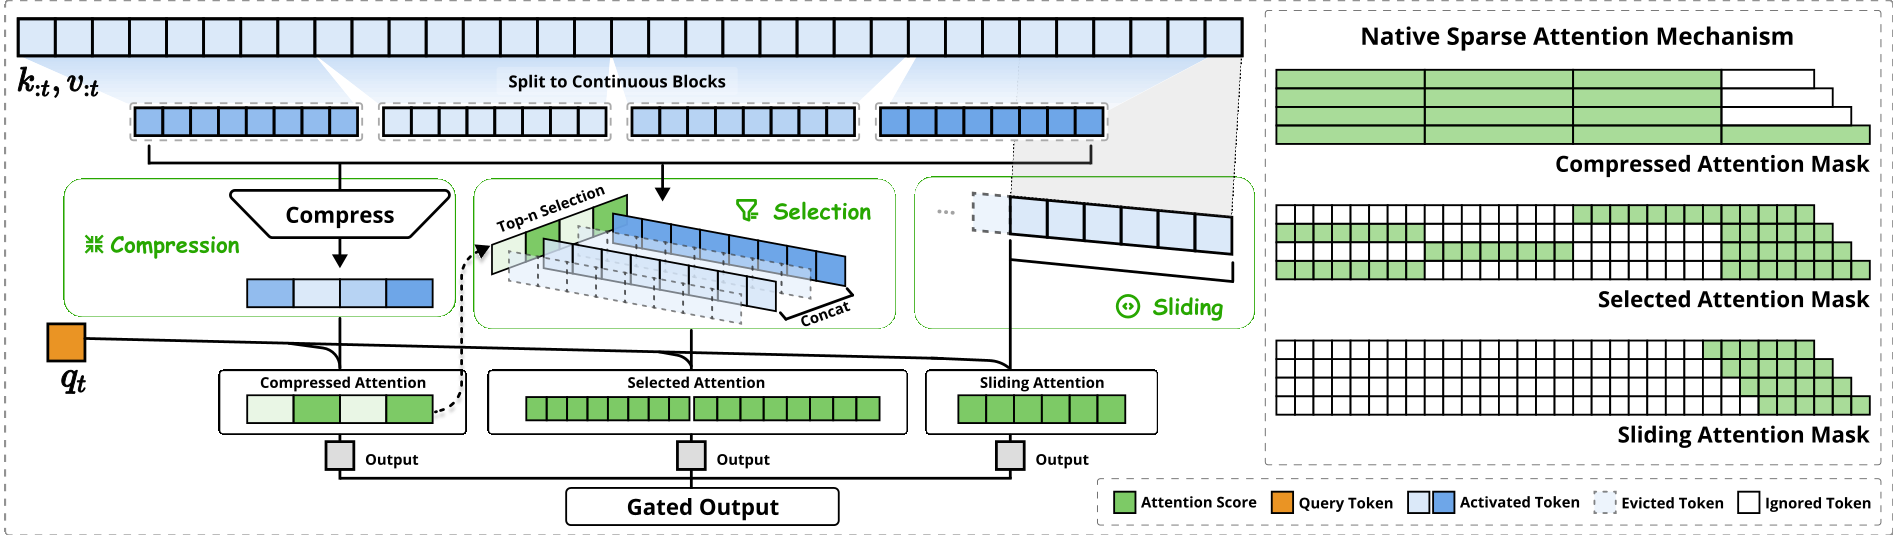
- Token Compression(压缩分支):将连续的 Key-Value 块通过一个小型的可学习 MLP 压缩成一个代表性的 Token。这相当于给模型提供了一个“缩略图”,获取全局概览。
- Token Selection(选择分支):这是 NSA 的核心创新。它利用压缩分支产生的注意力得分来预测哪些细粒度块是重要的,并只对这些 Top-n 块进行计算。
- Sliding Window(滑动窗口):由于自然语言具有极强的局部相关性,NSA 始终保留最近的 个 token 的原始精度。
为什么 NSA 是“硬件对齐”的?
NSA 的 Kernel 代码是基于 Triton 编写的。它一改 FlashAttention 的做法,转而采用 GQA Group-Centric 的数据加载策略:在每个内循环中,一次性加载同一组内所有 Query Head 对应的 KV 块,最大化了 Tensor Core 的吞吐并减少了冗余的 HBM 访存。
实验战果:不只是快,而且更强
1. 效率全线碾压
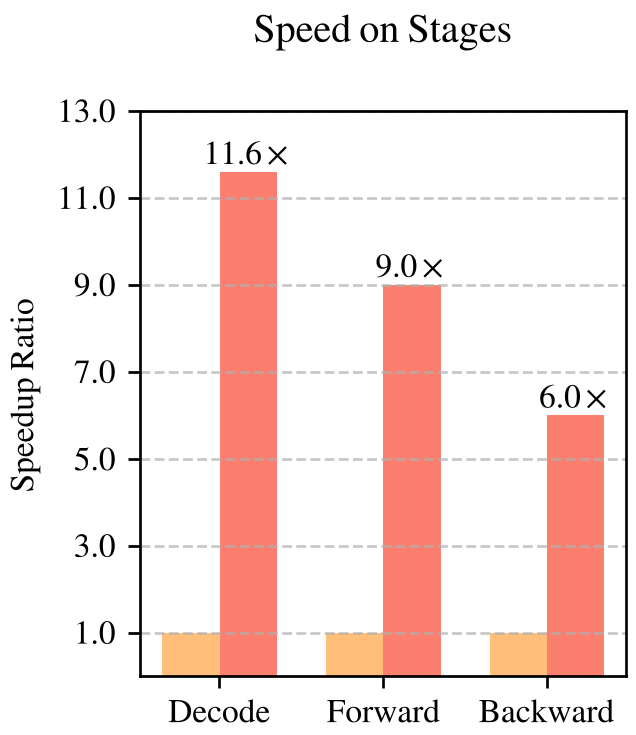
在 A100 GPU 上的实测显示,当处理 64k 长度的序列时:
- 前向传播:提速 9.0x
- 反向传播:提速 6.0x
- 推理解码:提速 11.6x
2. 长文本与推理能力的双重提升
在 64k 的“大海捞针”(Needle-in-a-Haystack)实验中,NSA 实现了 100% 的准确率。更令人意外的是,在数学推理基准 AIME 上,NSA 训练出来的模型表现居然优于 Full Attention。
学术洞察:这种提升可能源于稀疏化带来的 Inductive Bias。通过强制模型在预训练时只看最重要的 Token,NSA 实际上起到了“噪声过滤”的作用,让注意力机制更加聚焦。
深度思考:NSA 对行业的意义
NSA 的出现标志着稀疏注意力从“推理插件”演变成了“训练原生”。
- 训练成本的结构性下降:以往训练长文本模型需要耗费天量的算力,NSA 让开发者在预训练阶段就能享受到稀疏带来的红利。
- 复杂推理的助推器:如 DeepSeek-R1 所示,长链思考(Chain-of-Thought)需要模型生成极长的推理路径。NSA 的高效与高性能,使其成为此类推理模型的理想底座。
总结
DeepSeek 再次证明了他们在系统级优化与模型算法结合上的深厚功底。NSA 不仅仅是几个算子的组合,它是对硬件特性、算术密度(Arithmetic Intensity)以及模型收敛规律深刻理解后的成果。对于那些被 Transformer 计算量苦扰的开发者来说,NSA 指明了一条通向超长上下文、高性能模型的务实之路。
局限性:虽然 NSA 表现卓越,但其实现依赖于高度优化的自定义 Triton Kernel,对于不同硬件平台的迁移可能存在一定的门槛。此外,固定块大小对某些极端分布的任务是否有影响,仍值得进一步消融研究。