
[CVPR 2026] PGPO:拒绝“平均主义”,多模态强化学习的细粒度进化
Not All Tokens See Equally: Perception-Grounded Policy Optimization for Large Vision-Language Models
本文提出了 Perception-Grounded Policy Optimization (PGPO),这是一种针对多模态大模型(LVLMs)推理优化的细粒度强化学习框架。通过动态重塑 Token 级别的 Advantage,该方法在 Qwen2.5-VL 系列模型上实现了平均 18.7% 的性能提升,刷新了多步视觉推理任务的 SOTA 指标。
TL;DR
在多模态大模型(LVLM)的强化学习过程中,并非所有的 Token 对视觉信息的依赖都是平等的。本文提出的 Perception-Grounded Policy Optimization (PGPO) 针对性地解决了传统强化学习(如 GRPO)在信用分配上的“平均主义”弊端。通过量化 Token Visual Dependency,PGPO 能够识别并放大那些真正承载视觉逻辑的关键 Token 的学习信号,从而在不增加明显计算开销的前提下,显著提升复杂几何、数学和逻辑推理的准确度。
痛点深挖:被稀释的“视觉感知”
当前的 LVLM 系列模型(如 Qwen2-VL, Llama-3-V)在推理任务中广泛采用可验证奖励的强化学习(RLVR)。然而,标准的优化策略(如 GRPO)通常将一个序列级别的 Advantage(优势函数)无差别地广播给所有 Token。
这存在一个核心悖论:在一段长达几百个词的推理链中,可能只有 5% 的 Token(如具体的几何坐标或图表数值)是必须盯着图看才能写出来的,剩下的内容大多是通用的语法连接或逻辑推导。在这种“大锅饭”制度下,真正的视觉感知信号被淹没在大量的语言先验噪声中,导致模型虽然能说会道,却经常在最关键的视觉观察点上“睁眼瞎”。
核心机制:量化“视觉依赖度”
作者首先提出了 Token Visual Dependency () 的概念。其直觉非常直接:如果在遮掉图像(Unconditioned)后,模型预测某个 Token 的概率发生了剧烈变化,说明这个 Token 对视觉信息高度依赖。
这种变化被量化为:
实验观察到的三个直觉:
- 分布极度稀疏:只有极少数 Token 拥有高依赖分值。
- 高度语义相关:高分 Token 往往是数字、几何实体词、动词等“核心锚点”。
- 幻觉的克星:实验发现,当模型产生幻觉(Hallucinated Tokens)时,其视觉依赖度极低。这意味着 可以作为衡量模型是否“在胡说八道”的反向指标。
方法论:PGPO 优势重构
PGPO 并不单纯是给高分 Token 加权,它设计了一套严密的数学框架来确保训练平衡。
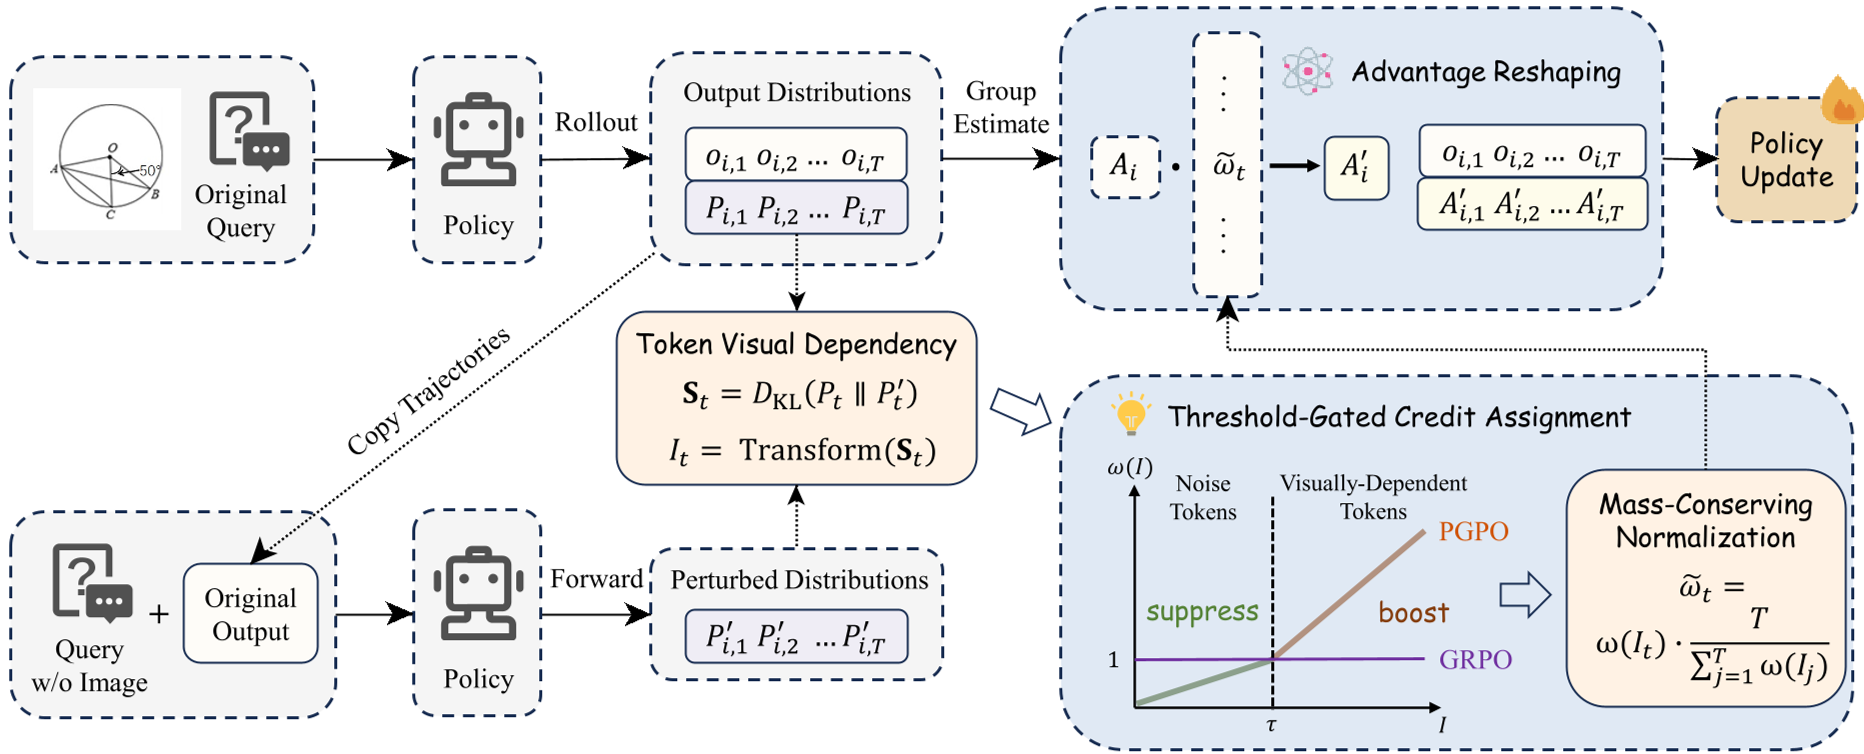
关键步骤:
- 对数压缩与归一化:解决 KL 散度长尾分布带来的数值不稳定。
- 阈值门控重分配:
- 抑制区:低于阈值的 Token 权重被极力压缩,减小噪声梯度。
- 增强区:高于阈值的视觉锚点 Token 被大幅增强(Boosting)。
- 总和守恒归一化(Mass-Conserving):论文严谨地证明了,必须保持整条序列的总 Advantage 不变(均值为 0),否则会导致梯度爆炸或策略坍塌。
实验结果:推理能力的阶跃
在 Qwen2.5-VL 平台上,PGPO 在七大挑战性基准测试中均超越了现有最强基线(如 VPPO, DAPO)。
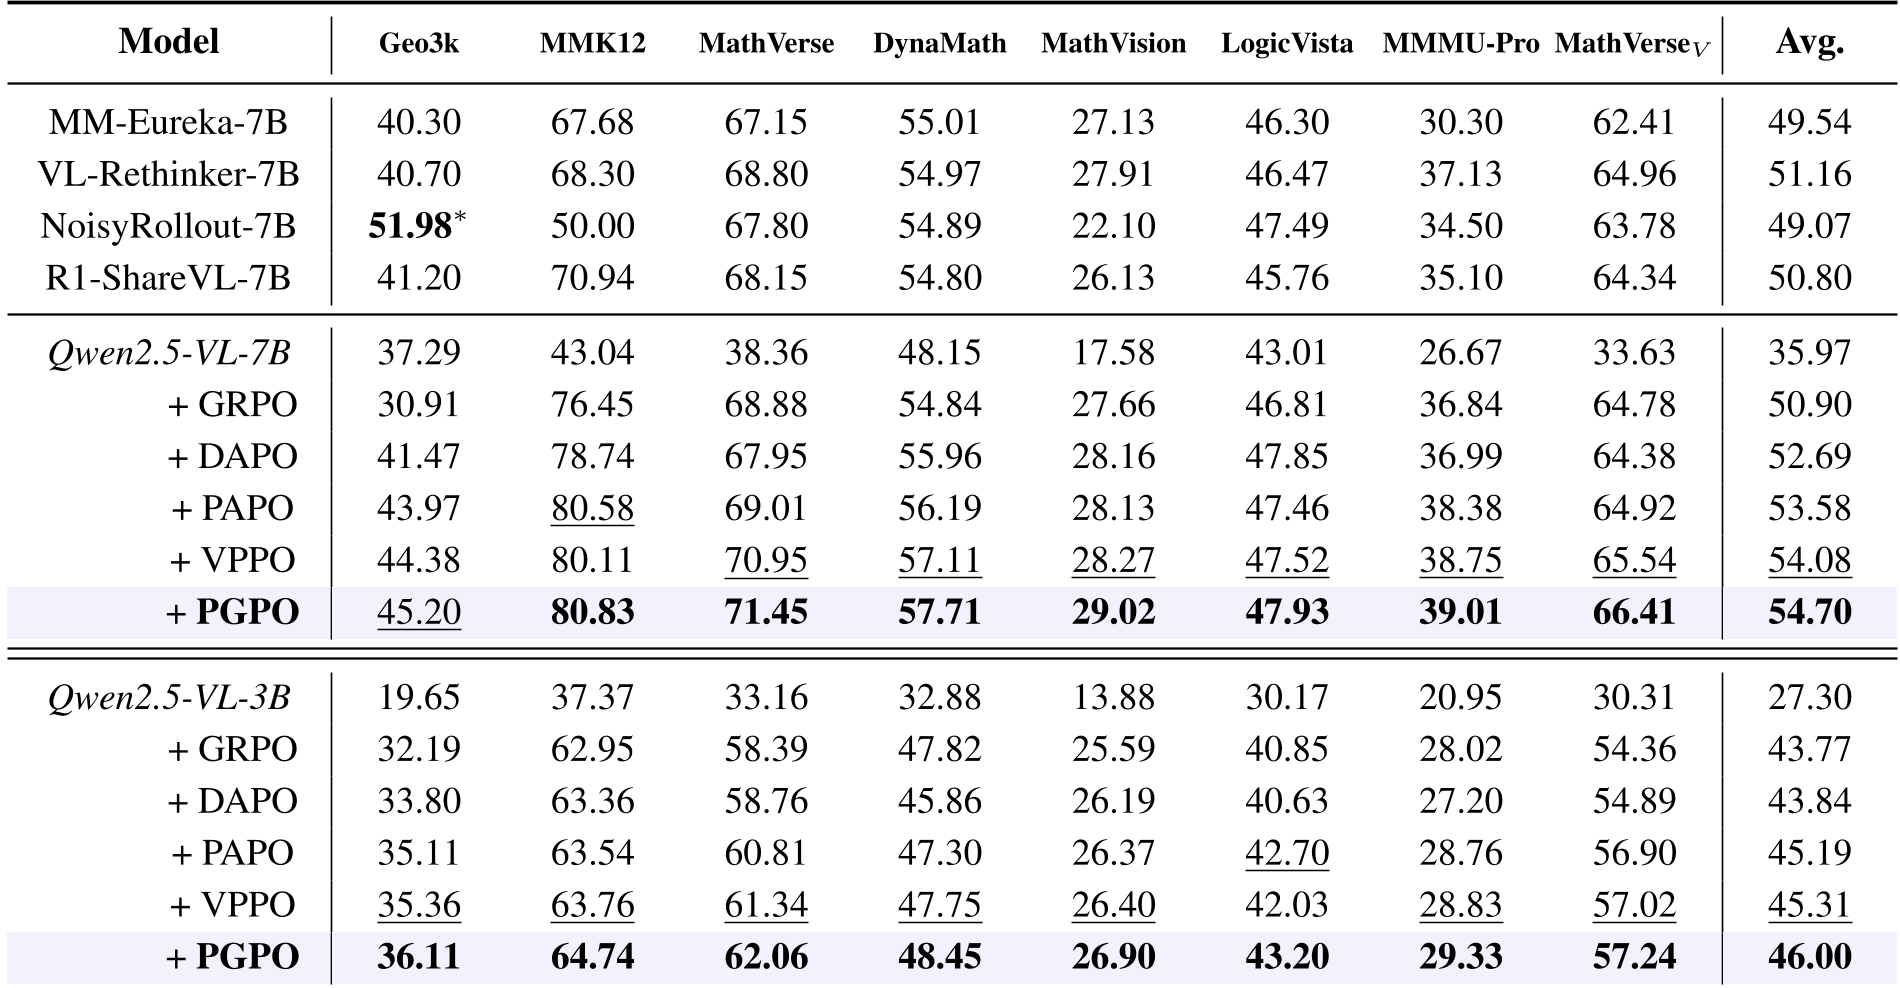
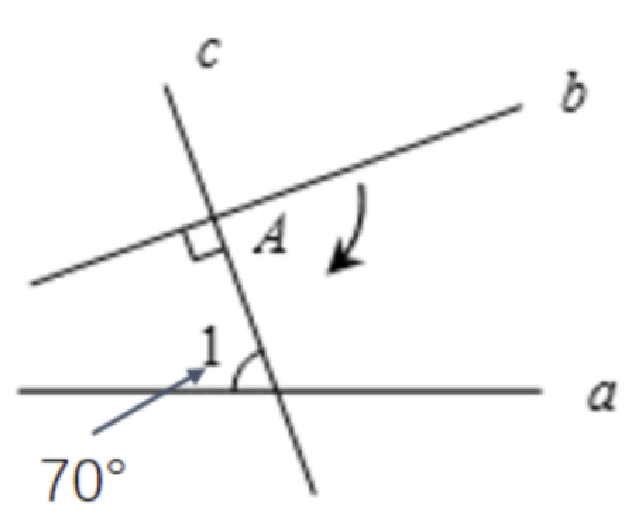
在对空间感知要求极高的 Geo3k 和 MathVerse 任务中,PGPO 的优势尤为明显。通过 Case Study 可以看到,PGPO 能够引导模型在推理过程中通过类似“内部单白”的方式,反复校验图像中的具体几何参数(如下方案例中对 20° 夹角的精确捕捉)。
深度洞察与总结
PGPO 的成功再次验证了梯度信噪比在强化学习中的核心地位。在多模态领域,简单地增加奖励反馈是不够的,关键在于如何分配这些反馈。
- 局限性:由于需要进行一次“视觉屏蔽”的额外前向传导,PGPO 增加了约 10% 的计算开销。虽然作者通过并行计算控制了成本,但在更大规模参数的模型上,这种开销仍需权衡。
- 未来展望:这种“基于感知的信用分配”思想完全能够平移到其他模态,例如在视频模型中识别对“时间维度”高度依赖的帧,或在音频任务中提取关键音素。
正如论文标题所言:“Not All Tokens See Equally”。PGPO 让我们看清了视觉信息是如何渗入模型的每一轮思考之中的。